
PostgreSQL / 系统课时
理解 startup 与 total cost
理解 startup 与 total cost
执行计划里的 cost=启动成本..总成本 不是毫秒,而是规划器比较候选路径的相对成本。本课解释 startup cost、total cost、rows、width,以及 LIMIT 为何偏爱更早产出数据的路径。
学习目标
- 正确解释计划节点中的
startup cost、total cost、rows与width。 - 理解 cost 是估算单位而非真实执行时间。
- 说明
LIMIT、EXISTS等只消费部分结果的场景为何更看重尽早产出数据。
先读懂 cost 区间
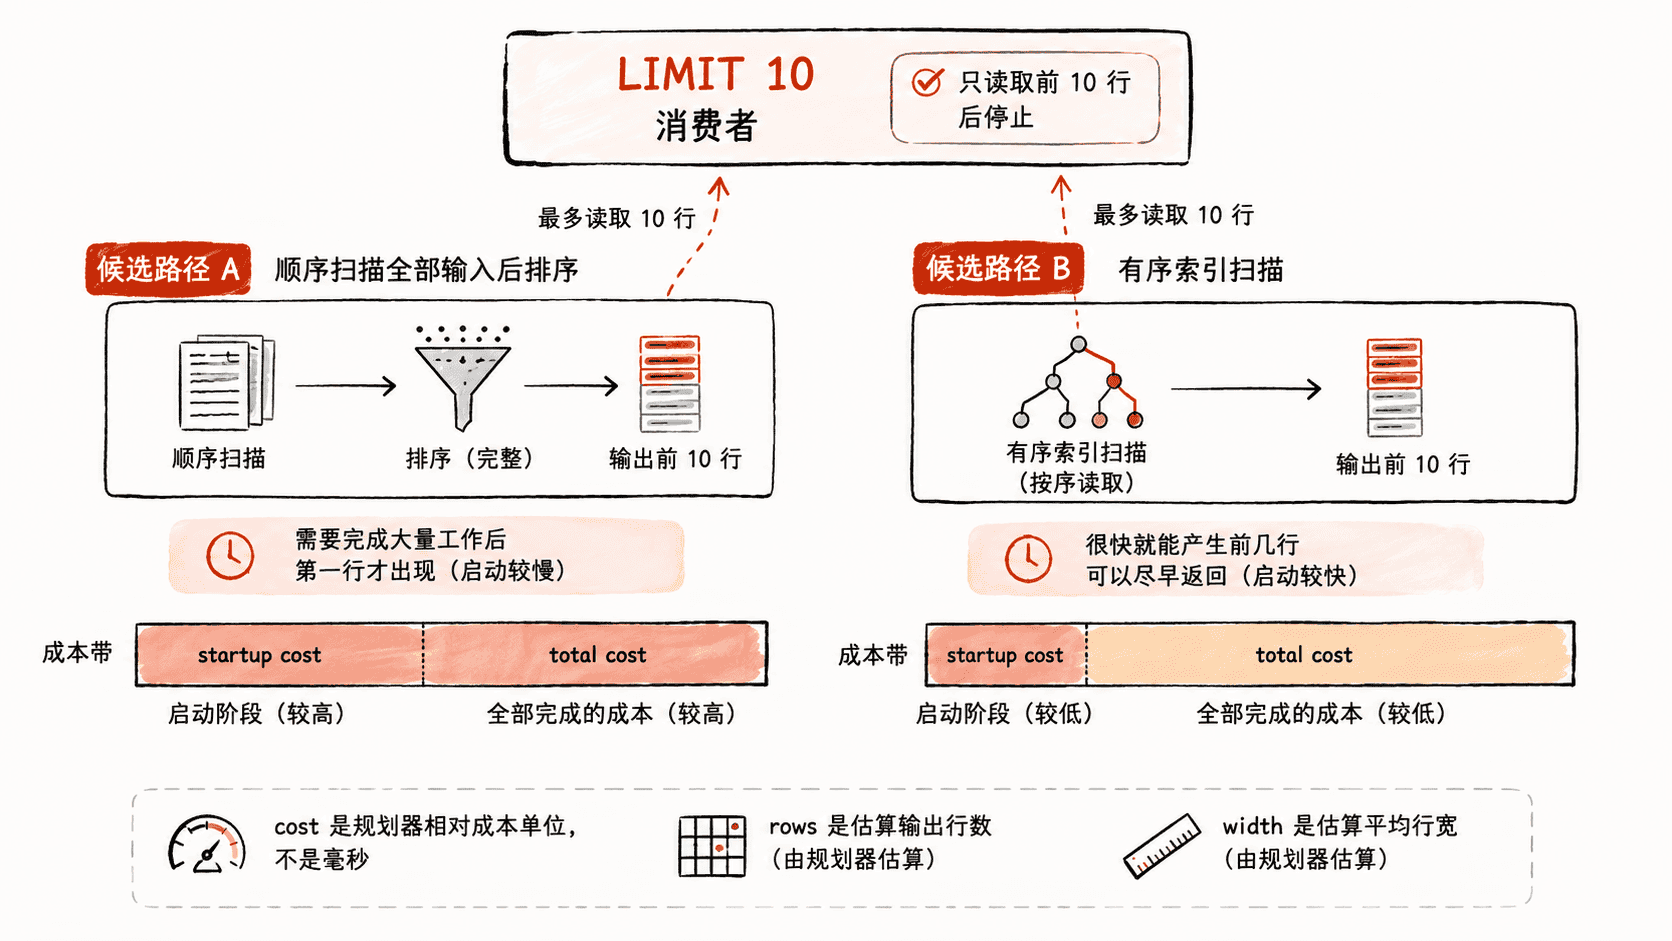
计划中的典型片段形如 cost=0.29..318.29 rows=10000 width=12。左侧数值是 startup cost:节点在能够产出第一行之前预计需要付出的成本;右侧数值是 total cost:假设该节点的所有结果都被上层消费完,预计累计需要付出的成本,其中已经包含启动成本。
rows 是规划器估算该节点完整执行时会输出多少行,width 是每行平均字节数的估算。它们都不是实际值,却会继续影响上层的排序、哈希、连接和数据搬运成本。如果基数估算严重失真,后续 cost 比较也会跟着偏离现实。
用 LIMIT 观察成本区间
下面创建 1 万行临时数据,并建立能直接提供 created_at DESC 顺序的索引。EXPLAIN 只做规划,不执行查询,因此很适合先观察估算成本。
BEGIN;

CREATE TEMP TABLE cost_demo (
    id integer PRIMARY KEY,
    created_at timestamp NOT NULL,
    payload text NOT NULL
);

INSERT INTO cost_demo (id, created_at, payload)
SELECT
    i,
    timestamp '2026-01-01 00:00:00' + i * interval '1 second',
    repeat('x', 40)
FROM generate_series(1, 10000) AS s(i);

CREATE INDEX cost_demo_created_at_desc_idx
    ON cost_demo (created_at DESC);

ANALYZE cost_demo;

EXPLAIN (COSTS ON)
SELECT id, created_at
FROM cost_demo
ORDER BY created_at DESC
LIMIT 10;

ROLLBACK;
预期结果的具体成本值会随 PostgreSQL 版本、统计信息与参数变化,但计划形态应体现 Limit 只需要消费索引路径的前 10 行:
Limit  (cost=<VALUE>..<VALUE> rows=10 width=<VALUE>)
  ->  Index Scan using cost_demo_created_at_desc_idx on cost_demo  (cost=<VALUE>..<VALUE> rows=10000 width=<VALUE>)
这里最值得观察的不是某个固定数字,而是父级 Limit 的总成本通常只反映取得前 10 行所需的那一小段工作,而子级索引扫描的 total cost 表示“如果把预计 1 万行全部读完”时的成本。
LIMIT 为什么会改变路径偏好
当上层明确只需要少量结果时,规划器不会简单地假设所有候选路径都要跑到末尾。可以把它直观理解为:对能够边执行边产出行的节点,部分消费成本大致从 startup cost 开始,再加上 total cost - startup cost 的一部分。
因此,有序索引扫描即使完整读完全部数据未必拥有最低的 total cost,也可能因为能快速返回第一批行而更适合 LIMIT 10。相反,一个必须先读取大量输入再排序的路径,往往要先支付较高启动成本才能产生第一行;即使后续逐行输出很便宜,前 10 行也未必来得快。
这也是为什么不能脱离上层消费者单独评价某个节点。普通查询需要全部结果时,total cost 更关键;LIMIT、EXISTS 或某些可以提前停止的执行场景,则会明显放大 startup cost 的影响。
把 rows 和 width 一起检查
rows 决定规划器认为后续节点要处理多少元组,width 则影响这些元组占用的数据量。两者一旦估错,排序是否值得、哈希表多大、随机读取次数是否可接受等判断都可能变化。
读计划时可以按一个稳定顺序检查:先确认上层究竟会消费全部结果还是可能早停;再看候选路径的 startup 与 total cost;随后核对 rows 是否符合业务选择率、width 是否因读取大字段而明显增加。只有估算基础可信时,cost 的比较才真正有解释力。
如果还要验证估算和现实是否一致,再使用 EXPLAIN (ANALYZE, BUFFERS) 对照实际行数和 I/O。此时要比较“估算是否把路径排序排对了”,而不是把 cost 数字与实际毫秒做一一换算。