
PostgreSQL / 系统课时
分析连接基数估算
分析连接基数估算
连接计划是否靠谱,往往先取决于“连接后会有多少行”的判断。本课用一组可复现数据,把过滤选择性、连接键 NDV 与唯一性放到同一条推理链里,帮助你解释连接结果为何被放大或压缩。
学习目标
- 能把连接基数拆成过滤后行数、连接键 NDV 与唯一性三个因素
- 能从
EXPLAIN ANALYZE和pg_stats判断估算偏差来自哪一侧 - 能识别统计信息失真、数据倾斜与过滤相关性对连接估算的影响
先把连接行数拆开看
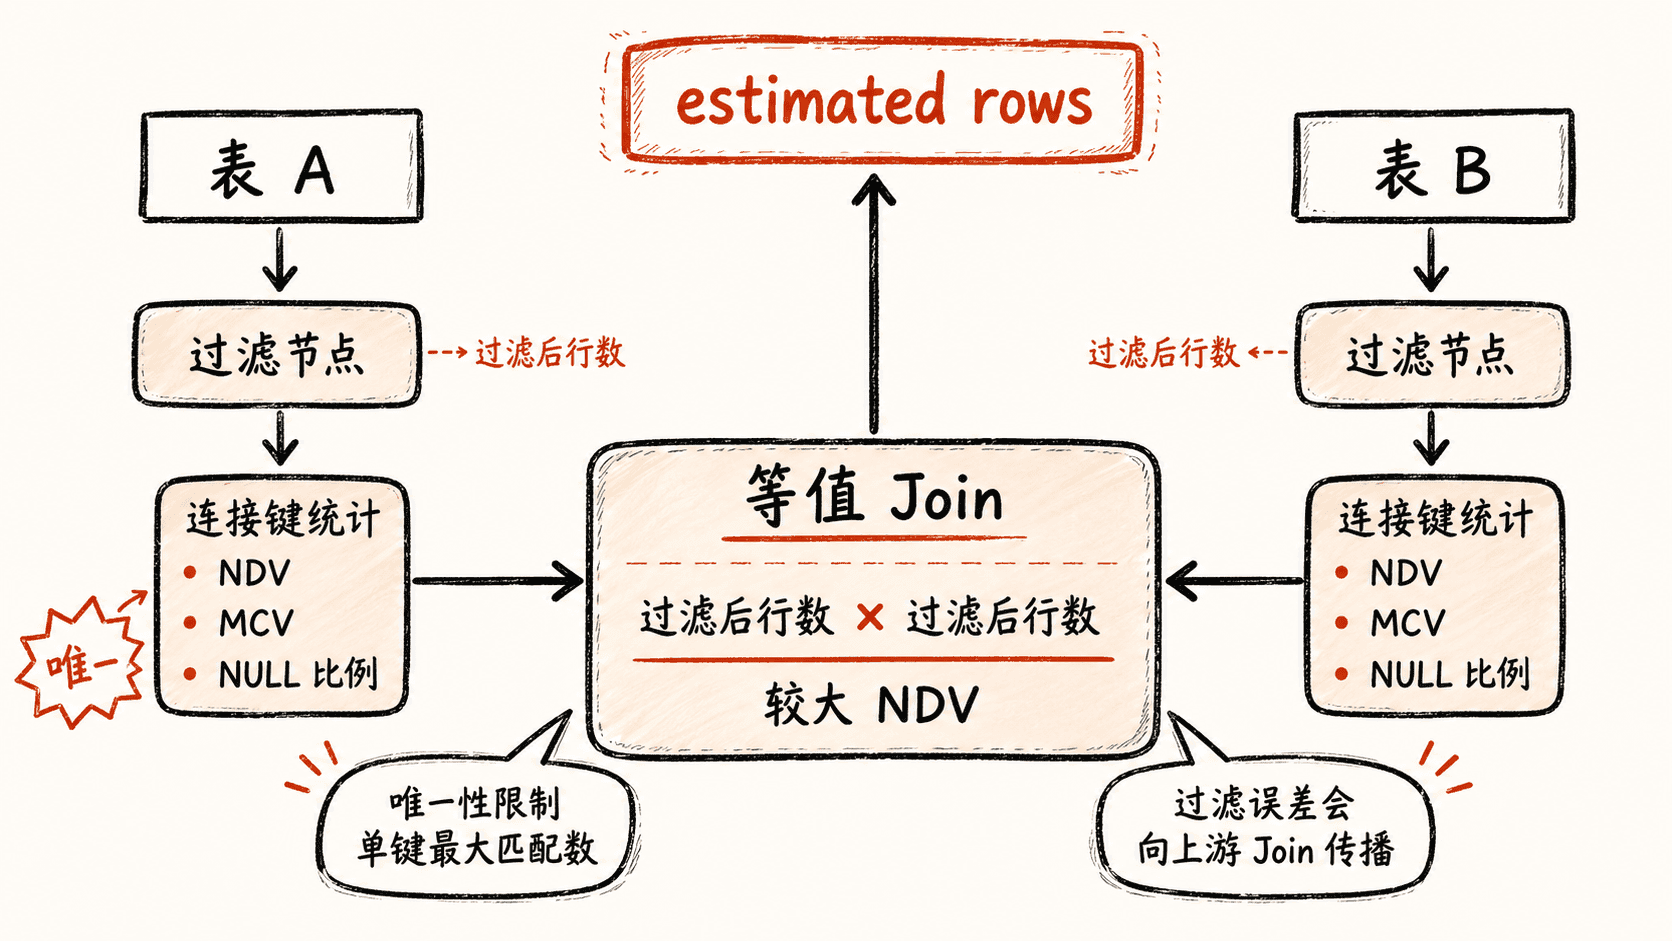
对等值连接,可以先用一个简化模型建立直觉:先估算两侧经过过滤后各剩多少行,再根据连接键的不同值数量(NDV,Number of Distinct Values)推算平均匹配数。忽略 MCV、NULL、直方图等细节时,常见近似是“左侧行数 × 右侧行数 ÷ 两侧较大的 NDV”。
如果一侧连接键有唯一约束或唯一索引,优化器还能证明这一侧每个键最多匹配一行。唯一性不会替代统计信息,但会收紧“一个输入行能匹配多少行”的边界。因此,分析连接基数时不要只盯总行数,要同时检查过滤后的规模、NDV 和唯一性。
用可复现实验观察唯一性与 NDV
下面创建 1000 个客户和 10000 个订单。客户主键唯一;每个客户恰好对应 10 个订单;其中 100 个客户属于 east 区域,因此过滤后再连接应得到 1000 行。
DROP TABLE IF EXISTS cardinality_orders;
DROP TABLE IF EXISTS cardinality_customers;

CREATE TABLE cardinality_customers (
    customer_id integer PRIMARY KEY,
    region text NOT NULL
);

CREATE TABLE cardinality_orders (
    order_id integer PRIMARY KEY,
    customer_id integer NOT NULL
);

INSERT INTO cardinality_customers
SELECT id,
       CASE WHEN id % 10 = 0 THEN 'east' ELSE 'west' END
FROM generate_series(1, 1000) AS g(id);

INSERT INTO cardinality_orders
SELECT id,
       ((id - 1) % 1000) + 1
FROM generate_series(1, 10000) AS g(id);

ANALYZE cardinality_customers;
ANALYZE cardinality_orders;

SELECT c.region, count(*) AS customer_rows
FROM cardinality_customers AS c
GROUP BY c.region
ORDER BY c.region;

SELECT count(*) AS joined_rows
FROM cardinality_orders AS o
JOIN cardinality_customers AS c
  ON c.customer_id = o.customer_id
WHERE c.region = 'east';
预期结果
 region | customer_rows
--------+--------------
 east   |          100
 west   |          900

 joined_rows
-------------
1000这组数据里,cardinality_customers.customer_id 是唯一键,订单侧 customer_id 大约有 1000 个不同值。过滤把客户侧从 1000 行缩到 100 行,每个保留下来的客户键在订单侧平均匹配 10 行,所以连接结果是 1000 行。
在执行计划里核对估算
对同一查询执行 EXPLAIN ANALYZE,重点比较 Join 节点以及两侧输入节点的 rows。rows 是计划阶段的估算行数,actual rows 是执行阶段观察到的行数。
EXPLAIN (ANALYZE, VERBOSE, TIMING OFF, SUMMARY OFF)
SELECT o.order_id, c.region
FROM cardinality_orders AS o
JOIN cardinality_customers AS c
  ON c.customer_id = o.customer_id
WHERE c.region = 'east';
预期输出
<JOIN_NODE>  (... rows=<EST_ROWS> ...)
  (actual rows=1000 loops=1)
  ...
  ->  <CUSTOMER_SCAN>  (... rows=<EST_FILTERED_CUSTOMERS> ...)
        (actual rows=100 loops=1)
        Filter: (region = 'east'::text)
Rows Removed by Filter: 900<JOIN_NODE>、成本数字和具体扫描方式会随 PostgreSQL 版本、统计采样与本机参数变化;本实验中应重点看到客户过滤实际为 100 行、连接实际为 1000 行,且 <EST_ROWS> 通常应接近实际值,而不是放大到数万行。
还可以直接检查列统计信息。n_distinct 为正数时表示估算的不同值个数;为负数时表示“不同值个数约占表行数的比例”,因此唯一列常见为 -1。
SELECT tablename, attname, n_distinct
FROM pg_stats
WHERE schemaname = current_schema()
  AND tablename IN ('cardinality_customers', 'cardinality_orders')
  AND attname IN ('customer_id', 'region')
ORDER BY tablename, attname;
预期结果
        tablename         |   attname    | n_distinct
--------------------------+--------------+------------
 cardinality_customers    | customer_id  | -1
 cardinality_customers    | region       | 2
 cardinality_orders       | customer_id  | <NDV_AROUND_1000>
订单侧的具体 NDV 会受统计采样影响,因此以实际输出为准。若订单侧 NDV 被明显低估,等值连接的平均匹配数会被放大;反过来,NDV 被高估则可能把连接结果压小。
判断偏差究竟从哪里来
当 Join 节点估算失真时,按“输入规模 → 键分布 → 唯一性”的顺序检查最省时间。先确认两侧过滤节点是否已经错了;如果输入行数本身就偏差一个数量级,Join 只是继承了上游错误,不应先归因于连接算法。
若两侧输入行数都准确,再看连接键统计。过期统计信息可能让 NDV 偏离真实分布;热点值会让“平均每个键出现次数”失真;两个过滤条件存在相关性时,单列选择性相乘也可能先把某一侧输入规模算错。此时应进一步检查 MCV、扩展统计或重新 ANALYZE。
最后核对唯一性是否能被优化器证明。业务上“应该唯一”但数据库里没有唯一约束,与真正存在 PRIMARY KEY 或 UNIQUE 不是一回事。连接估算需要基于数据库可见的约束和统计信息,而不是依赖代码层面的约定。