
PostgreSQL / 系统课时
比较连接路径代价
比较连接路径代价
连接计划不只是在 Nested Loop、Hash Join 和 Merge Join 中三选一,还要同时决定先连接哪些表、哪一侧做外表或构建端。本节把外表行数、内表重复访问、哈希构建和排序成本放到同一框架里,并用 EXPLAIN 对比三类路径。
学习目标
- 解释 Nested Loop、Hash Join、Merge Join 各自主要成本来自哪里
- 判断外表估算行数、内表访问方式、
work_mem与输入顺序如何影响连接算法 - 用规划器诊断开关对比候选连接路径,并识别错误基数估算如何放大代价误判
三类连接的成本结构
Nested Loop 的直觉是“外表每来一行,就访问一次内表”。如果外表只有几行,并且内表能用索引快速定位,它往往非常便宜;但外表行数一旦被低估,重复内表访问会按外表行数放大。可近似理解为:
Hash Join 通常先读取一侧建立哈希表,再扫描另一侧探测。它适合较大的等值连接,成本主要来自构建端扫描、哈希计算和探测;如果哈希表不能在 work_mem 相关预算内完成,就可能分批处理并产生额外 I/O。
Merge Join 要求两侧按连接键有序。已有可利用的索引顺序时,这个条件很便宜;否则还要承担 Sort 节点的成本。排序完成后,两边可以近似线性向前推进,因此对大数据集也可能有竞争力。
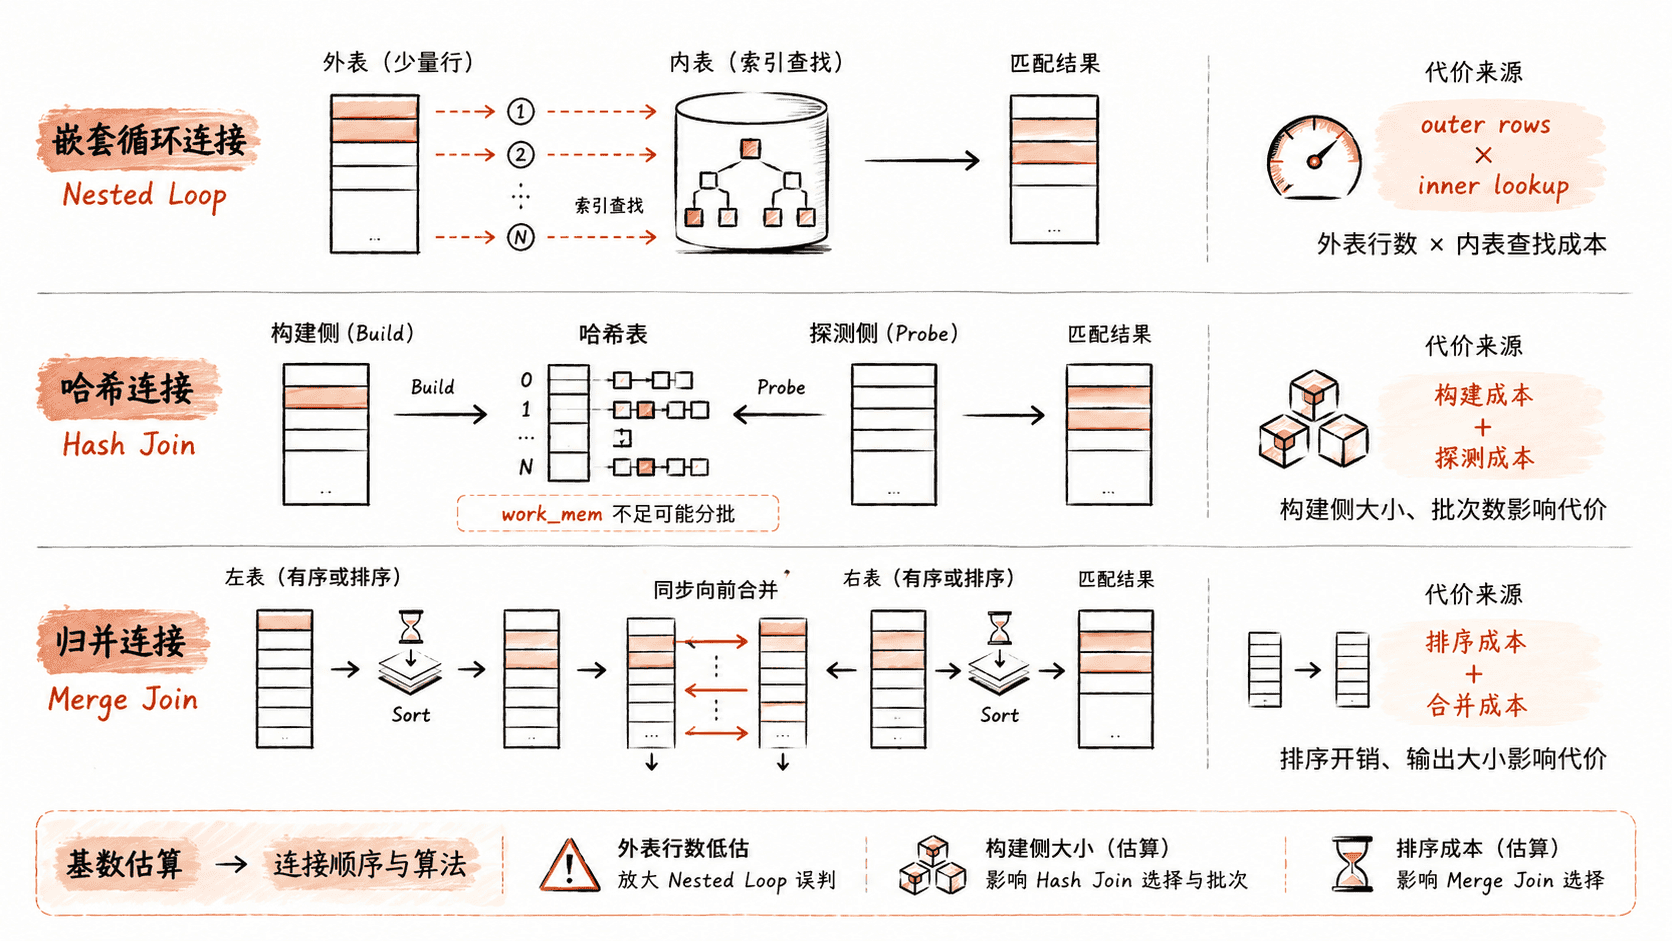
用同一连接对比候选路径
下面创建一张 100 行外表和一张 1 万行内表,并给内表连接键建立索引。先看规划器默认选择,再在事务内临时“劝退”其他算法以观察候选路径。enable_* 开关用于诊断,不应当作为生产环境长期固定计划的手段。
DROP TABLE IF EXISTS join_inner_lab;
DROP TABLE IF EXISTS join_outer_lab;

CREATE TABLE join_outer_lab (
    id integer PRIMARY KEY,
    join_key integer NOT NULL
);

CREATE TABLE join_inner_lab (
    id integer PRIMARY KEY,
    join_key integer NOT NULL,
    payload text NOT NULL
);

INSERT INTO join_outer_lab (id, join_key)
SELECT g, g
FROM generate_series(1, 100) AS g;

INSERT INTO join_inner_lab (id, join_key, payload)
SELECT g, (g % 100) + 1, repeat('y', 40)
FROM generate_series(1, 10000) AS g;

CREATE INDEX join_inner_lab_join_key_idx
ON join_inner_lab (join_key);

ANALYZE join_outer_lab;
ANALYZE join_inner_lab;

EXPLAIN (COSTS ON)
SELECT count(*)
FROM join_outer_lab AS o
JOIN join_inner_lab AS i
  ON i.join_key = o.join_key;

BEGIN;

SET LOCAL enable_hashjoin = off;
SET LOCAL enable_mergejoin = off;
EXPLAIN (COSTS ON)
SELECT count(*)
FROM join_outer_lab AS o
JOIN join_inner_lab AS i
  ON i.join_key = o.join_key;

SET LOCAL enable_hashjoin = on;
SET LOCAL enable_nestloop = off;
EXPLAIN (COSTS ON)
SELECT count(*)
FROM join_outer_lab AS o
JOIN join_inner_lab AS i
  ON i.join_key = o.join_key;

SET LOCAL enable_hashjoin = off;
SET LOCAL enable_mergejoin = on;
EXPLAIN (COSTS ON)
SELECT count(*)
FROM join_outer_lab AS o
JOIN join_inner_lab AS i
  ON i.join_key = o.join_key;

ROLLBACK;
预期输出
-- 默认计划:由当前代价参数决定
Aggregate  (cost=<START>..<TOTAL> rows=1 width=<WIDTH>)
  ->  <JOIN_NODE>  (cost=<START>..<TOTAL> rows=<ROWS> width=<WIDTH>)
      <CHILD_NODES>

-- 只鼓励 Nested Loop 后
Aggregate
  ->  Nested Loop
      <OUTER_SCAN>
      <INNER_INDEX_OR_BITMAP_ACCESS>

-- 劝退 Nested Loop、允许 Hash Join 后
Aggregate
  ->  Hash Join
      Hash Cond: (i.join_key = o.join_key)
      <BUILD_AND_PROBE_CHILDREN>

-- 只鼓励 Merge Join 后
Aggregate
  ->  Merge Join
      Merge Cond: (i.join_key = o.join_key)
      <ORDERED_SCAN_OR_SORT_CHILDREN>
节点的左右顺序、是否出现 Bitmap、Sort 或 Materialize,以及具体 cost 数字都可能因版本、统计信息和参数不同而变化。诊断时要比较每个候选计划的总代价组成,而不是要求输出与示例逐行一致。
外表行数为什么会改变算法
如果查询先把外表过滤到极少数行,Nested Loop 往往能把“重复访问内表”控制在很小的次数;内表又有高选择性索引时,这种组合尤其有利。问题在于 rows_outer 是估算值,不是执行时才知道的真实值。
当统计信息把外表从 10,000 行错估成 10 行时,规划器会把内表查找成本只乘 10 次。执行时却可能重复 10,000 次,计划就从“看起来最便宜”变成真正的瓶颈。因此连接问题经常不是 Join 节点本身出了错,而是更早的基数估算已经偏离。
对于 Hash Join,构建端的估算大小直接影响哈希表成本与批次数判断。对于 Merge Join,输入是否已经有序、是否需要排序,以及排序行数估计都进入代价。错误行数会同时污染连接算法和连接顺序。
连接顺序也是代价选择的一部分
三张以上表连接时,规划器并不是先固定顺序再挑算法,而是在搜索过程中比较“先连哪两张、产出多少行、下一步再和谁连”的候选路径。一个较早的高选择性连接如果能显著缩小中间结果,后续所有连接都会更便宜。
这也是为什么生产排查要从最底层扫描节点的 rows 估算一路向上看:若第一个扫描节点已经低估十倍,上一层连接可能继续放大误差,最终让 Join Order 和 Join Method 同时偏离。必要时使用 EXPLAIN (ANALYZE, BUFFERS) 对照估算行数与实际行数,再回到统计信息、谓词相关性和数据倾斜寻找根因。