
PostgreSQL / 系统课时
理解自动 ANALYZE 触发
理解自动 ANALYZE 触发
自动 ANALYZE 不是固定每隔一段时间执行,而是依据“自上次分析以来的变更量”和“表规模”判断表是否达到分析门槛。本课把触发公式、表级覆盖、大表风险和分区表盲区串起来,方便你判断为什么统计信息迟迟没有刷新。
学习目标
- 解释自动 ANALYZE 阈值与表规模之间的关系。
- 计算具体表距离触发门槛还有多远,并识别表级参数覆盖。
- 识别大表、高频变更表和分区父表的维护盲区。
触发门槛由基础值和表规模共同决定
自动分析的核心条件可以写成:
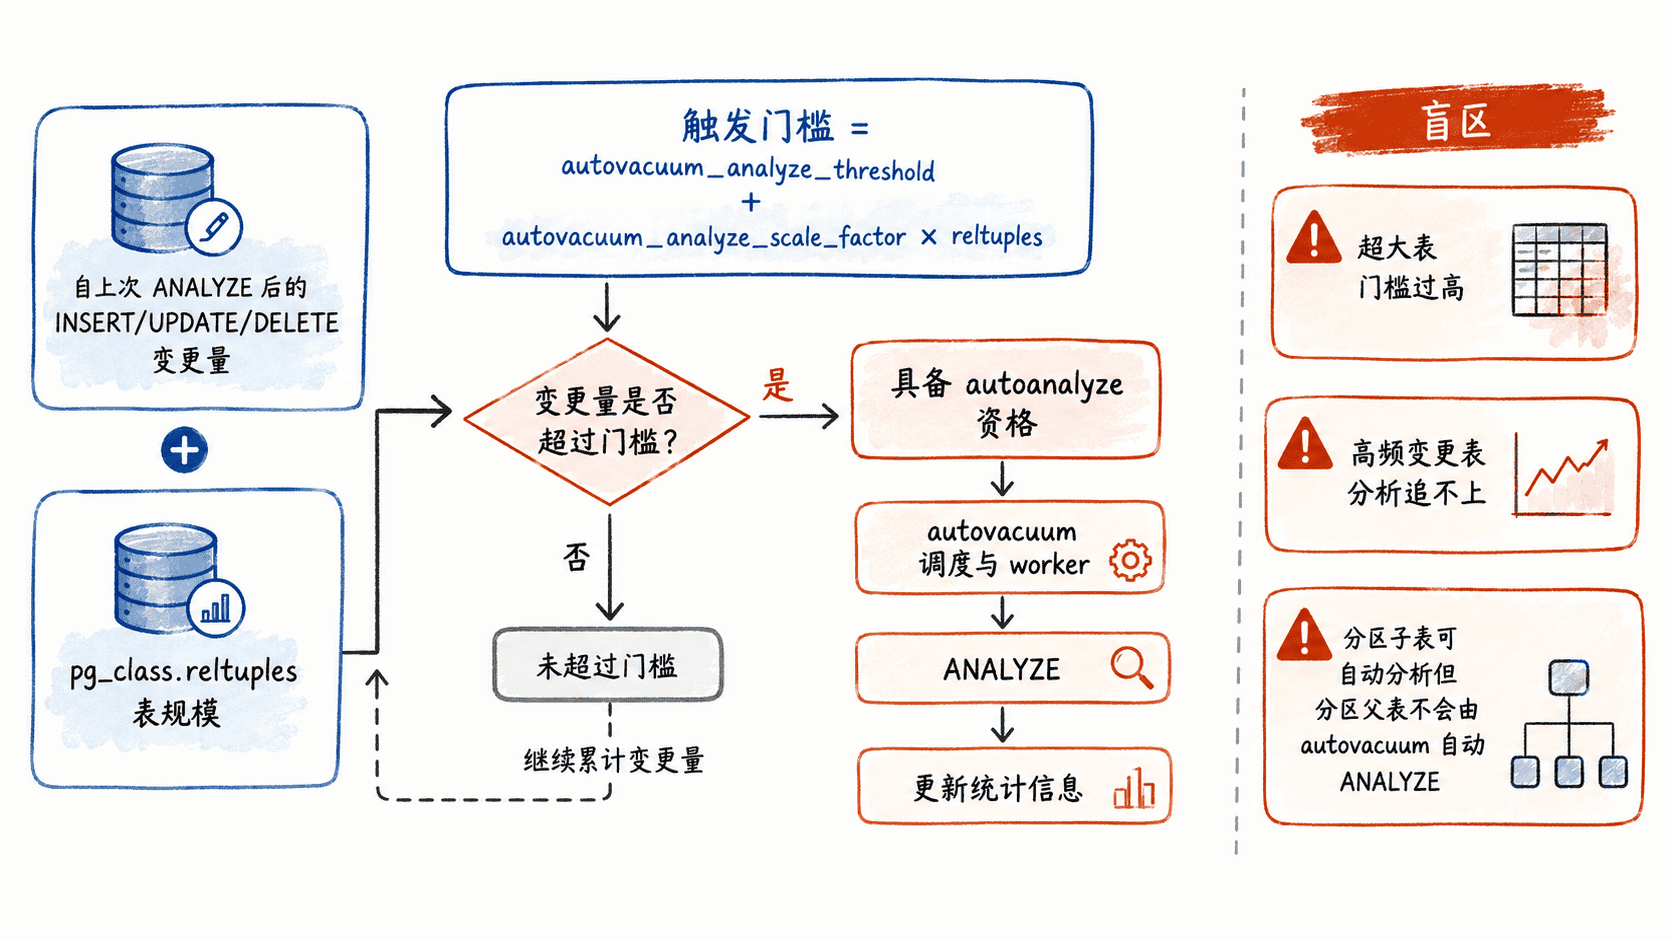
其中 b 是 autovacuum_analyze_threshold,s 是 autovacuum_analyze_scale_factor,N 采用表的估算行数 pg_class.reltuples。自上次 ANALYZE 以来插入、更新和删除的元组数量超过这个门槛后,该表才具备自动分析资格。
这说明同一套全局参数对不同规模的表并不等价:表越大,按比例项计算出的门槛越高。达到门槛也不代表立刻开始执行,实际启动还受到 autovacuum 调度、worker 可用性和系统负载影响。
计算每张表离门槛还有多远
生产排查时不要把默认值写死。下面的查询读取当前实例的全局参数,并识别表级 reloptions 是否覆盖了分析阈值或比例,再把当前变更量与估算触发门槛放在一起。
WITH table_cfg AS (
    SELECT
        s.relid,
        s.schemaname,
        s.relname,
        s.n_live_tup,
        s.n_mod_since_analyze,
        s.last_autoanalyze,
        c.reltuples::numeric AS reltuples,
        COALESCE(
            o.analyze_threshold,
            current_setting('autovacuum_analyze_threshold')::numeric
        ) AS analyze_threshold,
        COALESCE(
            o.analyze_scale_factor,
            current_setting('autovacuum_analyze_scale_factor')::numeric
        ) AS analyze_scale_factor
    FROM pg_stat_user_tables AS s
    JOIN pg_class AS c
      ON c.oid = s.relid
    LEFT JOIN LATERAL (
        SELECT
            max(option_value::numeric)
                FILTER (WHERE option_name = 'autovacuum_analyze_threshold')
                AS analyze_threshold,
            max(option_value::numeric)
                FILTER (WHERE option_name = 'autovacuum_analyze_scale_factor')
                AS analyze_scale_factor
        FROM pg_options_to_table(c.reloptions)
    ) AS o ON true
)
SELECT
    schemaname,
    relname,
    n_live_tup,
    n_mod_since_analyze,
    ceil(
        analyze_threshold
        + analyze_scale_factor * GREATEST(reltuples, 0)
    )::bigint AS analyze_trigger,
    round(
        n_mod_since_analyze
        / NULLIF(
            analyze_threshold
            + analyze_scale_factor * GREATEST(reltuples, 0),
            0
        ),
        2
    ) AS trigger_ratio,
    last_autoanalyze
FROM table_cfg
ORDER BY trigger_ratio DESC NULLS LAST
LIMIT 20;
预期输出
 schemaname | relname | n_live_tup | n_mod_since_analyze | analyze_trigger | trigger_ratio | last_autoanalyze
------------+---------+------------+---------------------+-----------------+---------------+-----------------
public | <TABLE> | <VALUE> | <VALUE> | <VALUE> | <VALUE> | <TIME>实际值会随表规模、统计计数和配置不同而变化。trigger_ratio 接近或超过 1 表示从计数角度已经接近或达到门槛;如果长期明显超过 1 却迟迟没有新的 last_autoanalyze,就应继续检查 autovacuum 是否启用、worker 是否繁忙以及是否存在长期资源压力。
大表和高频变更表为什么容易失配
大表的主要风险是比例项被绝对规模放大。即使 autovacuum_analyze_scale_factor 看起来不高,乘上数亿行后仍可能要求非常多的变更才触发分析,而热点分布可能早在那之前就改变。此时应按可接受的统计陈旧窗口,为关键大表设置更低的表级比例,而不是机械照搬全局值。
高频变更表则是另一种问题:它可能很快反复达到门槛,但分析任务的实际启动与完成速度追不上数据变化。降低阈值只能让表更早获得资格,不能增加 worker 数量或消除 I/O、CPU 竞争,所以要同时观察自动分析耗时、autovacuum 活跃任务和系统资源。
分区表有一个容易忽略的父表盲区
普通分区叶子表会像其他表一样由 autovacuum 处理,但分区父表本身不直接存储元组,因此 autovacuum 不会自动对分区父表执行 ANALYZE。当查询依赖父表级统计,而新分区装载或各分区数据占比发生明显变化时,父表统计可能继续停留在旧分布。
因此,分区表治理要分两层:叶子分区继续检查各自的自动分析节奏;父表则在首次装载、批量切换分区或整体分布显著变化后安排手工 ANALYZE。如果只看到叶子分区的 last_autoanalyze 很新,就判断整棵分区表统计健康,容易漏掉父表这一层。
调整触发策略时看三个指标
判断是否需要改自动分析参数,可以同时看变更速率、触发门槛和计划估算误差。门槛远高于业务分布变化速度,说明比例项可能过大;门槛已经频繁跨过但分析仍滞后,说明瓶颈更可能在调度或资源;只有分区父表统计落后,则应补充手工维护,而不是继续压低叶子表阈值。
自动 ANALYZE 的治理目标不是“越频繁越好”,而是在统计陈旧造成明显估算偏差之前完成刷新。把触发公式、实际变更速度和查询对统计信息的敏感度放在一起,才能为大表、热点表和分区表制定不同的维护节奏。