
PostgreSQL / 系统课时
理解规划器的路径选择
理解规划器的路径选择
这节课把“规划器为什么选这个计划”拆成可观察的决策过程:先为扫描、连接和排序生成候选路径,再用统计信息估算每条路径会处理多少行,最后比较启动成本与总成本。理解这套机制后,看到 Seq Scan、Hash Join 或 Sort 就不再只是记节点名称。
学习目标
- 理解 Path 候选与最终 Plan 的关系
- 说明访问、连接和排序路径如何参与成本比较
- 解释统计估算为什么会放大到整棵计划树
Path 是规划器比较的候选方案
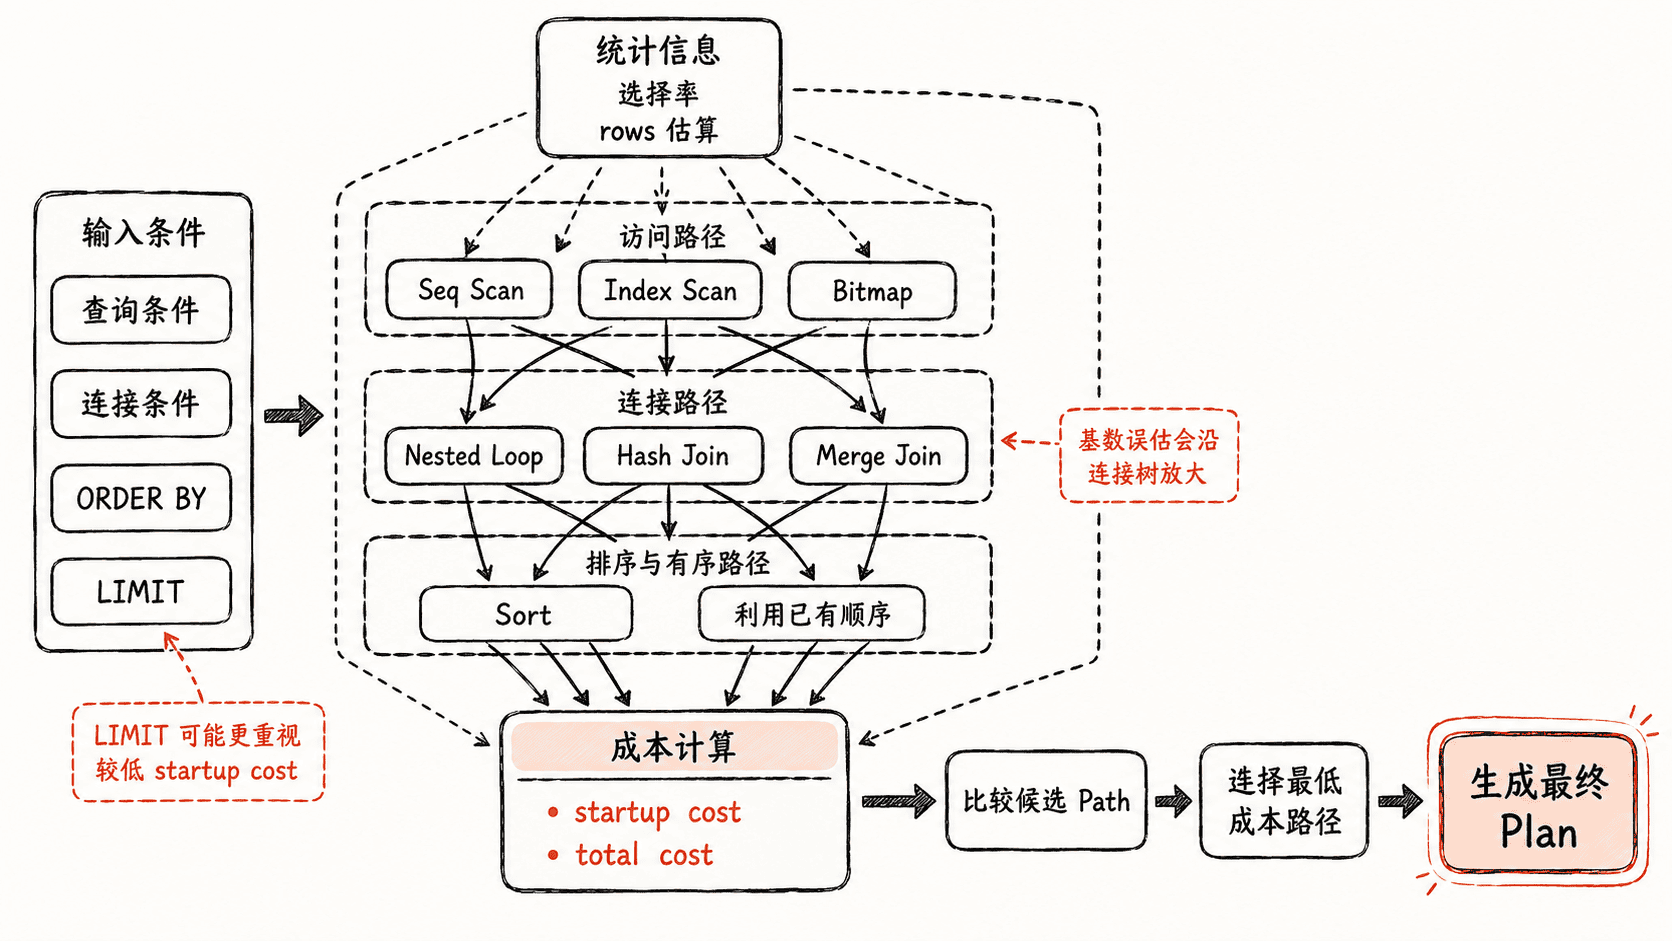
规划器不会看到一个索引就直接决定使用它。对基础表,它可能比较顺序扫描、索引扫描和 Bitmap 路径;对多表查询,还要组合不同连接顺序与 Nested Loop、Hash Join、Merge Join 等连接方法;遇到 ORDER BY、聚合或 LIMIT 时,还会继续比较是否需要排序以及哪种路径能更早产出所需行。
这些候选在内部以 Path 形式参与比较。规划器根据每条 Path 的行数估算、启动成本和总成本选择更便宜的方案,再把胜出的路径转换成最终 Plan 交给执行器。
统计信息先影响 rows,再影响 cost
成本公式并不是只看“有没有索引”。规划器先根据统计信息估算条件选择率,再得到各节点的 rows;这个行数会继续影响扫描页数、连接输入规模、哈希表大小、排序工作量以及上层节点成本。
例如把实际返回 10 行误估成 100000 行,规划器可能认为索引随机访问太贵而转向顺序扫描;连接时,错误基数还会继续传递,让本来适合 Nested Loop 的场景被估成更适合 Hash Join。所谓“统计信息治理”,本质上就是让这些成本计算建立在更可靠的行数估算上。
用一个查询观察访问、连接与排序
下面的实验创建两个临时表、建立索引并收集统计信息,然后查看一个带过滤、连接、排序和 LIMIT 的计划。不同 PostgreSQL 版本、机器和成本参数可能选择不同节点,这正是本课要观察的现象。
CREATE TEMP TABLE planner_customers (
    id integer PRIMARY KEY,
    name text NOT NULL
);

CREATE TEMP TABLE planner_orders (
    id bigint PRIMARY KEY,
    customer_id integer NOT NULL,
    amount numeric(10, 2) NOT NULL,
    created_at timestamp NOT NULL
);

INSERT INTO planner_customers
SELECT i, 'customer-' || i
FROM generate_series(1, 1000) AS g(i);

INSERT INTO planner_orders
SELECT i,
       (i % 1000) + 1,
       (i % 5000) / 10.0,
       timestamp '2026-01-01' + (i || ' minutes')::interval
FROM generate_series(1, 50000) AS g(i);

CREATE INDEX planner_orders_customer_idx
    ON planner_orders(customer_id);

ANALYZE planner_customers;
ANALYZE planner_orders;

EXPLAIN
SELECT c.name, o.amount, o.created_at
FROM planner_customers AS c
JOIN planner_orders AS o
  ON o.customer_id = c.id
WHERE c.id BETWEEN 40 AND 60
ORDER BY o.created_at DESC
LIMIT 20;
预期输出
CREATE TABLE
CREATE TABLE
INSERT 0 1000
INSERT 0 50000
CREATE INDEX
ANALYZE
ANALYZE
QUERY PLAN
Limit  (cost=<VALUE>..<VALUE> rows=20 width=<VALUE>)
  ->  <SORT_OR_ORDERED_PATH>
        ->  <JOIN_PATH>
              ->  <CUSTOMER_ACCESS_PATH>
              ->  <ORDER_ACCESS_PATH>
<...> 代表规划器按当前环境选出的实际节点,常见结果可能包含 Sort、Nested Loop 或 Hash Join,以及 Seq Scan、Index Scan 或 Bitmap 路径。验收重点不是背出固定树形,而是确认计划中每个节点都有 rows 与 cost,并沿着扫描、连接、排序逐层解释“为什么这条候选路径更便宜”。
启动成本和总成本都重要
没有 LIMIT 时,规划器通常更关注取完全部结果的总成本;存在小 LIMIT 时,能更快产出前几行的低启动成本路径可能更有优势。于是,同一数据和过滤条件,仅仅增加或删除 LIMIT,就可能让路径选择变化。
排查路径选择时,应按“估算行数 → 候选访问路径 → 连接顺序和方法 → 排序需求 → startup/total cost”的顺序阅读。只看最终节点名称,很容易错过真正驱动决策的上游基数估算。