
PostgreSQL / 系统课时
分析三类连接节点
分析三类连接节点
连接计划不能只看节点名字。真正要判断的是:外表会产生多少行、内表如何被访问、连接条件是否可哈希或排序,以及估算行数偏差会不会把一个本来便宜的算法放大成灾难。本课用同一组数据对照 Nested Loop、Hash Join 与 Merge Join,建立可复用的判断顺序。
学习目标
- 读懂 Nested Loop、Hash Join、Merge Join 的输入方式与主要成本来源
- 根据输入规模、连接条件和索引判断连接算法是否合理
- 从
EXPLAIN ANALYZE中识别“估算错导致选错连接”的危险信号
先用同一组数据观察三种连接
下面创建两张临时表。customer_id 是等值连接键,订单表明显更大,并分别为连接键建立索引。随后通过会话级 Planner 开关仅用于教学演示,让三种连接节点依次出现。
CREATE TEMP TABLE customer_plan_lab AS
SELECT i AS customer_id, 'c-' || i AS name
FROM generate_series(1, 1000) AS g(i);

CREATE TEMP TABLE order_plan_lab AS
SELECT i AS order_id,
       1 + (i % 1000) AS customer_id,
       (i % 5000)::numeric / 100 AS amount
FROM generate_series(1, 50000) AS g(i);

CREATE INDEX ON customer_plan_lab (customer_id);
CREATE INDEX ON order_plan_lab (customer_id);
ANALYZE customer_plan_lab;
ANALYZE order_plan_lab;

SET enable_hashjoin = off;
SET enable_mergejoin = off;
EXPLAIN (ANALYZE, TIMING OFF, SUMMARY OFF)
SELECT c.customer_id, o.order_id
FROM customer_plan_lab AS c
JOIN order_plan_lab AS o USING (customer_id)
WHERE c.customer_id <= 5;

SET enable_nestloop = off;
SET enable_mergejoin = off;
SET enable_hashjoin = on;
EXPLAIN (ANALYZE, TIMING OFF, SUMMARY OFF)
SELECT count(*)
FROM customer_plan_lab AS c
JOIN order_plan_lab AS o USING (customer_id);

SET enable_nestloop = off;
SET enable_hashjoin = off;
SET enable_mergejoin = on;
EXPLAIN (ANALYZE, TIMING OFF, SUMMARY OFF)
SELECT count(*)
FROM customer_plan_lab AS c
JOIN order_plan_lab AS o USING (customer_id);

RESET enable_nestloop;
RESET enable_hashjoin;
RESET enable_mergejoin;
预期输出
第一段计划的连接节点应为 Nested Loop,并可看到内侧通过 customer_id 索引反复查找。
第二段计划的连接节点应为 Hash Join,并出现 Hash 节点。
第三段计划的连接节点应为 Merge Join;输入可能来自索引顺序,也可能先出现 Sort。
实际扫描节点、循环次数与耗时会因 PostgreSQL 版本、缓存和机器环境不同。
这些 Planner 开关只适合实验,不是生产优化手段。生产环境应让优化器根据统计信息和成本模型自行选择,再用执行计划验证选择是否符合真实数据分布。
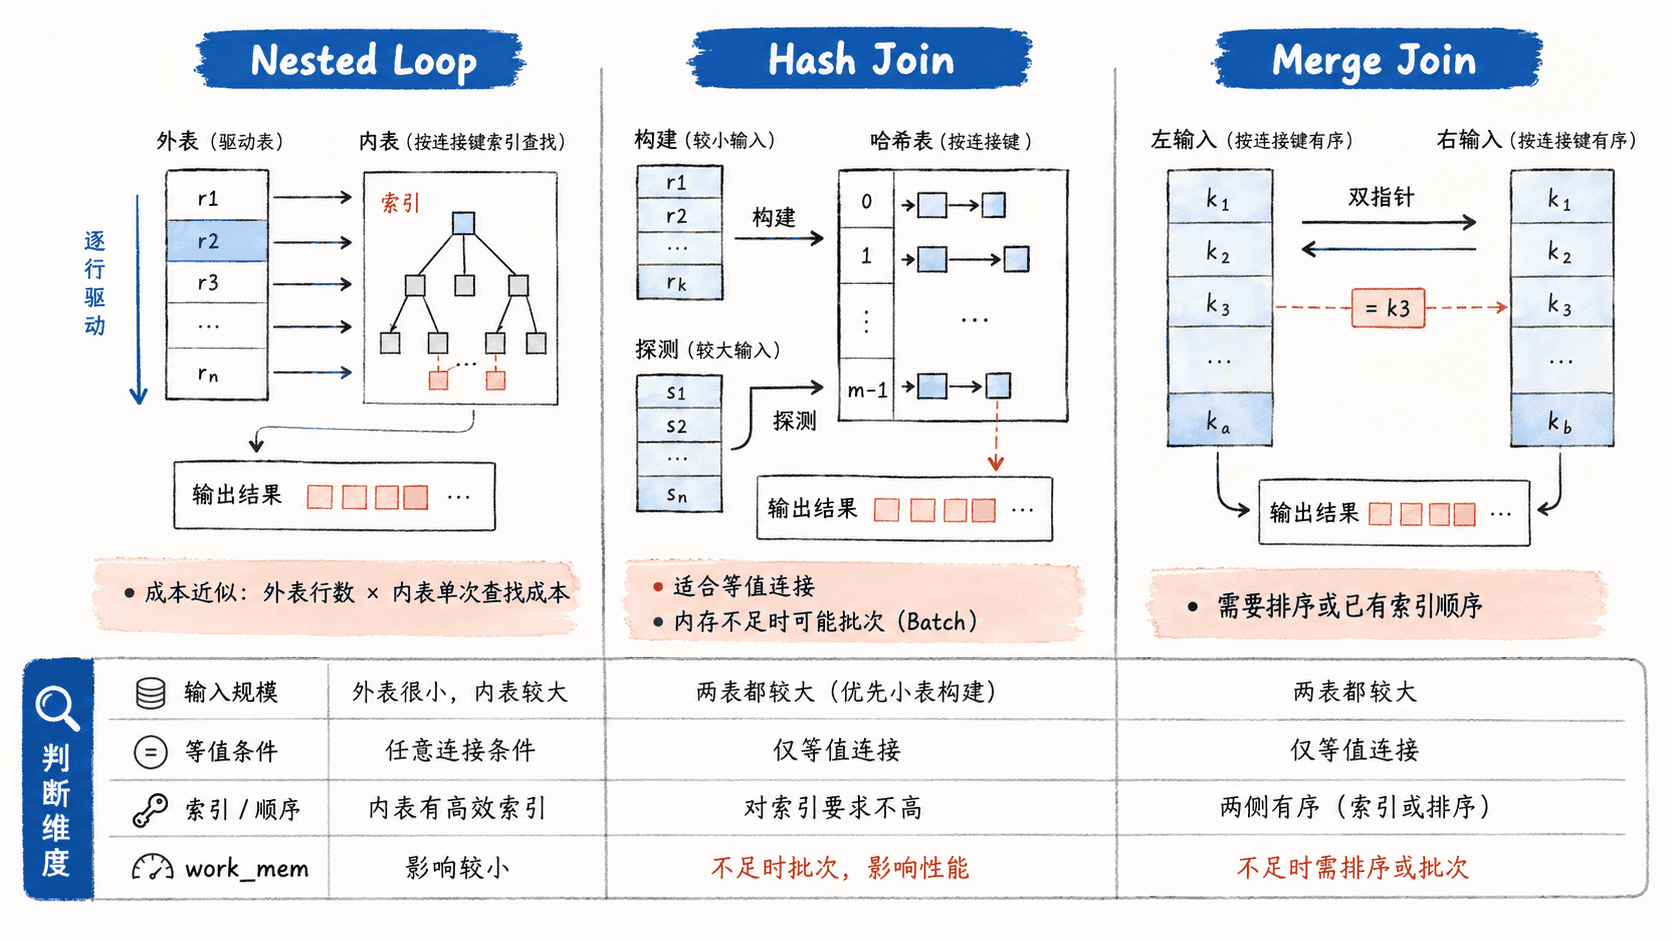
Nested Loop:小外表驱动快速内表
Nested Loop 的核心是“外表每产出一行,就执行一次内侧计划”。因此不要只盯总表大小,而要看 loops:如果内侧节点执行 5 次且每次都能命中索引,这通常非常便宜;如果误估后执行几十万次,随机 I/O 和 CPU 会被重复放大。
它最适合外表结果很小、内表有高选择性索引的场景,例如先通过主键或强过滤条件找到少量用户,再查询每个用户的订单。危险组合则是“外表实际行数远高于估算 + 内侧没有便宜索引”。此时计划里常见内侧节点 loops 极大,且每轮都扫描大量数据。
判断 Nested Loop 时依次问三个问题:外表实际产生多少行;内侧一次访问需要多少工作;这个内侧工作会重复多少次。只要其中一个量级失控,Nested Loop 就可能从最优方案变成主要瓶颈。
Hash Join:用内存换线性探测
Hash Join 只适用于可哈希的等值连接条件。执行时一侧先经过 Hash 节点构建哈希表,另一侧再逐行按连接键探测。对于两个都不算小、又没有可直接利用的排序顺序的输入,它通常比大量随机索引查找更稳定。
计划中要同时看 Hash 的实际行数和内存行为。EXPLAIN (ANALYZE ...) 在不同版本中会给出诸如 Buckets、Batches、Memory Usage 等信息;如果批次数明显大于 1,通常意味着哈希表无法一次放入工作内存,需要分批处理并可能产生临时 I/O。
Merge Join:有序输入上的同步扫描
Merge Join 要求两侧按连接键有序,然后像两个指针一样向前推进。顺序可以由索引天然提供,也可以由显式 Sort 节点产生。因此它是否划算,往往取决于“排序成本能不能被省掉,或者排序结果能不能顺便服务后续操作”。
当两侧输入都很大、连接条件是可排序的等值条件,且至少一侧已经按连接键有序时,Merge Join 很有竞争力。相反,如果为了连接必须先对两个大输入做昂贵排序,而 Hash Join 又能直接在内存中完成,Merge Join 往往不占优势。
看计划时不要把 Sort -> Merge Join 分开评价:排序是连接算法的一部分成本。若扫描本身不慢但排序产生大量临时文件,真正要优化的可能是输入顺序、索引或前置过滤,而不是 Merge Join 节点本身。
用估算偏差判断“算法错”还是“统计错”
连接算法的选择高度依赖基数估算。最值得警惕的不是某一种节点,而是估算行数与实际行数相差一个或多个数量级。若 Planner 以为外表只有 10 行,实际却有 100000 行,就可能错误选择 Nested Loop;若低估哈希输入规模,也可能把本应一次驻留内存的 Hash Join 推成多批执行。
排查时先比较连接节点两侧的 estimated rows 与 actual rows,再沿子节点向下找第一处明显偏差。偏差来自过期统计、列相关性、倾斜值或表达式条件时,优先修复统计信息与查询条件;只有估算基本可信而代价仍高时,再考虑索引、SQL 结构或内存参数。
最终的判断标准不是“哪种连接最快”,而是“当前数据规模与访问路径下,这个连接节点的重复工作、排序成本或哈希成本是否与估算一致”。只要把输入规模、访问方式和实际循环次数串起来,三类连接节点就能从名字变成可验证的成本模型。