
PostgreSQL / 系统课时
理解 correlation
理解 correlation
这篇解决一个容易被忽略的问题:同样使用索引,为什么数据物理布局不同,优化器估算出的代价也会不同。你将看到 correlation 如何描述逻辑顺序与堆表物理顺序的关系,以及它为什么会影响索引扫描成本。
学习目标
- 理解
pg_stats.correlation的含义及取值范围 - 建立“索引顺序与 Heap 页面访问顺序”之间的成本模型
- 能通过统计信息判断索引扫描成本偏高是否与物理相关性有关
correlation 衡量什么
PostgreSQL 的 pg_stats.correlation 描述某列的值排序与表中物理行位置之间的相关程度,范围通常在 到 。接近 1 表示值越大,行越靠近表的后部;接近 -1 表示值越大,行越靠近表的前部;接近 0 则说明逻辑顺序与物理顺序关系很弱。
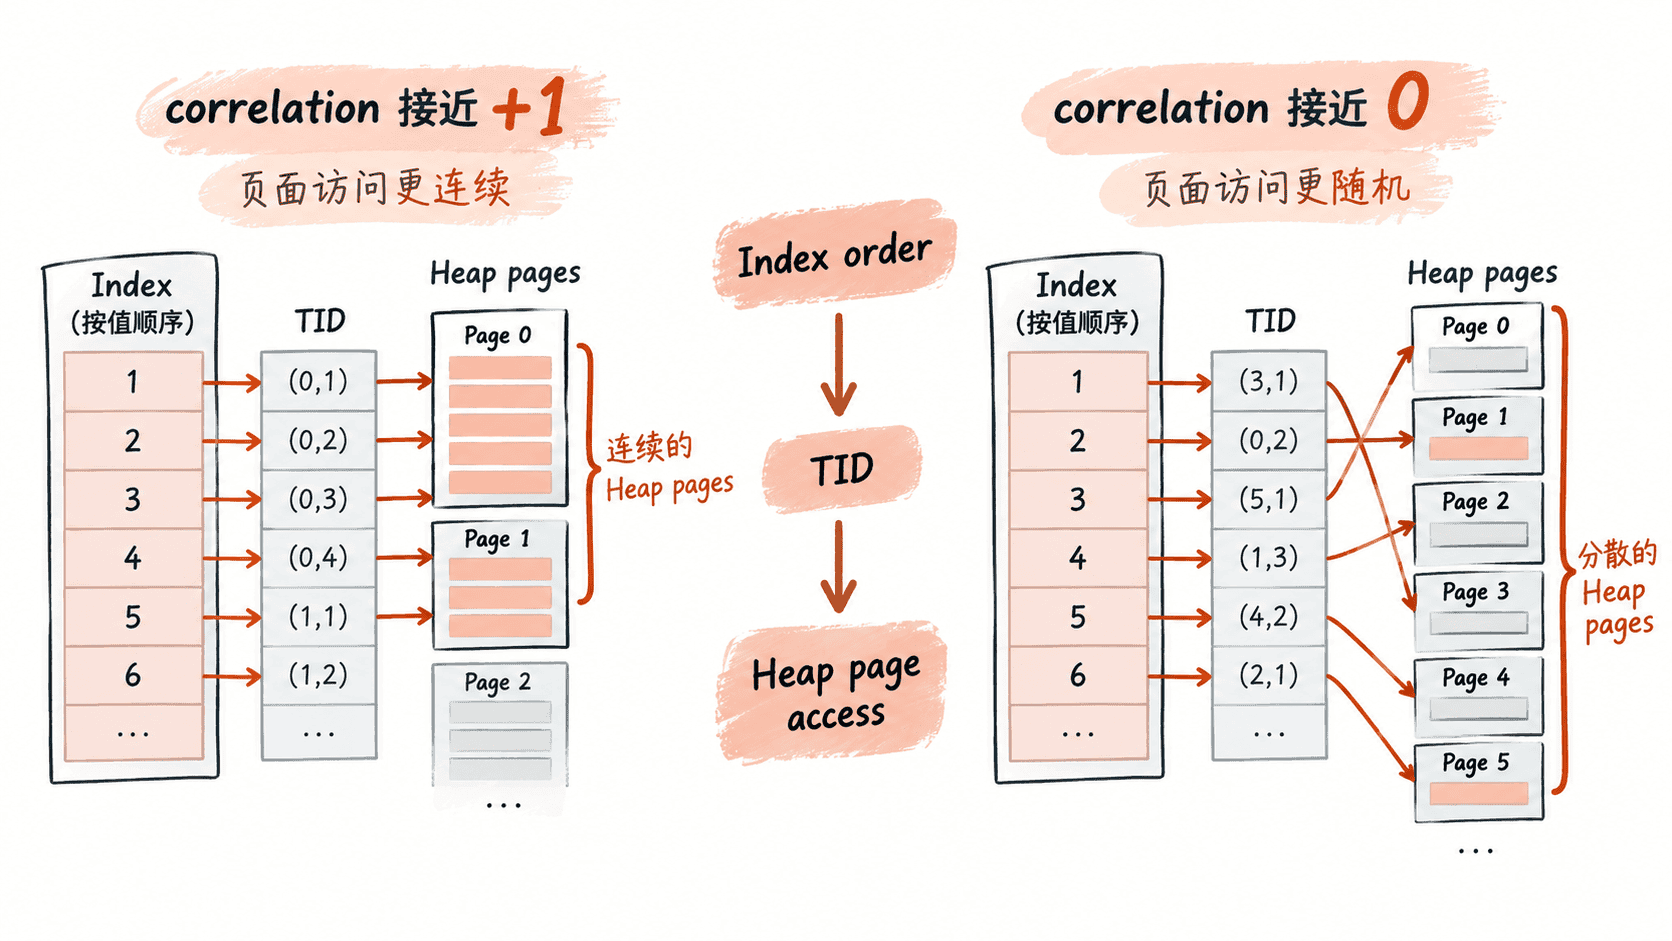
这里的“物理顺序”不是 B-tree 索引内部的顺序,而是表数据在 Heap 页面中的实际排列。优化器关心这一点,是因为索引找到 TID 后,还需要访问 Heap 获取行;如果这些行集中在相邻页面,磁盘或缓存访问会更连续。
为什么相关性会影响索引成本
假设查询先通过 B-tree 索引得到一批符合条件的 TID。随后 PostgreSQL 还要根据这些 TID 回到 Heap 取出完整行。若列值与物理位置高度相关,同一范围内的 TID 往往落在相邻数据页,访问模式更接近顺序扫描;若相关性接近零,同样数量的 TID 可能散落在许多页面,随机访问成本更高。
因此 correlation 并不是“这个索引好不好”的评分,也不是索引选择性的替代指标。它描述的是索引键顺序与 Heap 物理位置之间的关系,主要影响范围索引扫描的页面访问成本。
观察统计信息
可以用一张按键值顺序写入的表,观察高相关性场景。下面示例使用确定性数据,不依赖随机函数,因此重复执行时现象更容易复现。
DROP TABLE IF EXISTS correlation_demo;

CREATE TABLE correlation_demo AS
SELECT
    n AS id,
    n AS sort_key,
    md5(n::text) AS payload
FROM generate_series(1, 100000) AS g(n);

CREATE INDEX correlation_demo_sort_key_idx
    ON correlation_demo (sort_key);

ANALYZE correlation_demo;

SELECT
    tablename,
    attname,
    correlation
FROM pg_stats
WHERE tablename = 'correlation_demo'
  AND attname = 'sort_key';
预期结果:
tablename          | attname  | correlation
-------------------+----------+------------
correlation_demo   | sort_key | 接近 1
因为 sort_key 按递增顺序写入 Heap,逻辑顺序与物理顺序高度一致,所以相关性通常非常接近 1。实际显示值可能略有差异,但重点应是其明显偏高,而不是某个固定小数位。
如何把 correlation 放回执行计划
面对范围条件时,不要只问“有没有索引”,还要问“索引命中的行在 Heap 中是否容易连续访问”。在相同选择性下,高相关性通常让索引扫描的 Heap 访问更接近顺序读取;低相关性则可能提高随机页面访问成本,使优化器更倾向重新比较 Index Scan、Bitmap Heap Scan 和 Seq Scan 的总代价。
这也是为什么一个实际业务表在持续插入、更新、重排或经过不同维护操作后,执行计划可能发生变化。查询条件没有改,索引也没有消失,但统计信息中的相关性以及表的物理布局可能已经不同。
correlation 的几个边界
correlation 为负数并不代表“坏”。例如按降序排列的数据可能接近 -1,这同样意味着逻辑顺序与物理顺序存在很强关系,只是方向相反。对页面访问连续性的判断,绝不能把负相关简单理解成随机。
同时,correlation 也不能单独决定计划。选择性、表大小、缓存命中、random_page_cost、seq_page_cost、Bitmap 路径以及其他统计信息都会参与最终成本比较。排查计划异常时,应把 correlation 当作解释页面访问成本的一块证据,而不是单一开关。
实际工作中,先通过 pg_stats 确认相关性,再结合目标 SQL 的条件选择性和 EXPLAIN 观察访问路径,通常比单纯反复创建索引更有效。真正重要的不是把 correlation 人为追求到某个数字,而是判断优化器对 Heap 页面访问成本的理解是否符合当前数据分布。