
PostgreSQL / 系统课时
分析常见扫描节点
分析常见扫描节点
本课解决一个常见的执行计划阅读问题:看到 Scan 节点时,如何判断 PostgreSQL 是顺序读、索引定位、仅索引读取,还是先批量收集 TID 再访问表。读完后,你能把节点名称与过滤、回表和批量访问直接对应起来。
学习目标
- 识别 Seq Scan、Index Scan、Index Only Scan 与 Bitmap Scan 的访问方式
- 判断过滤条件发生在哪一层,以及是否产生 Heap Fetches 或 Bitmap Heap Scan
- 用 EXPLAIN 验证不同扫描节点的主要计划信号
先看扫描节点在解决什么问题
扫描节点的核心不是“有没有索引”,而是“优化器怎样取得最终需要的行”。Seq Scan 直接遍历表;Index Scan 先利用索引找到目标,再按 TID 回到堆表;Index Only Scan 在可见性条件满足时直接从索引返回所需列;Bitmap Scan 则先批量收集 TID,再由 Bitmap Heap Scan 按页面组织访问。
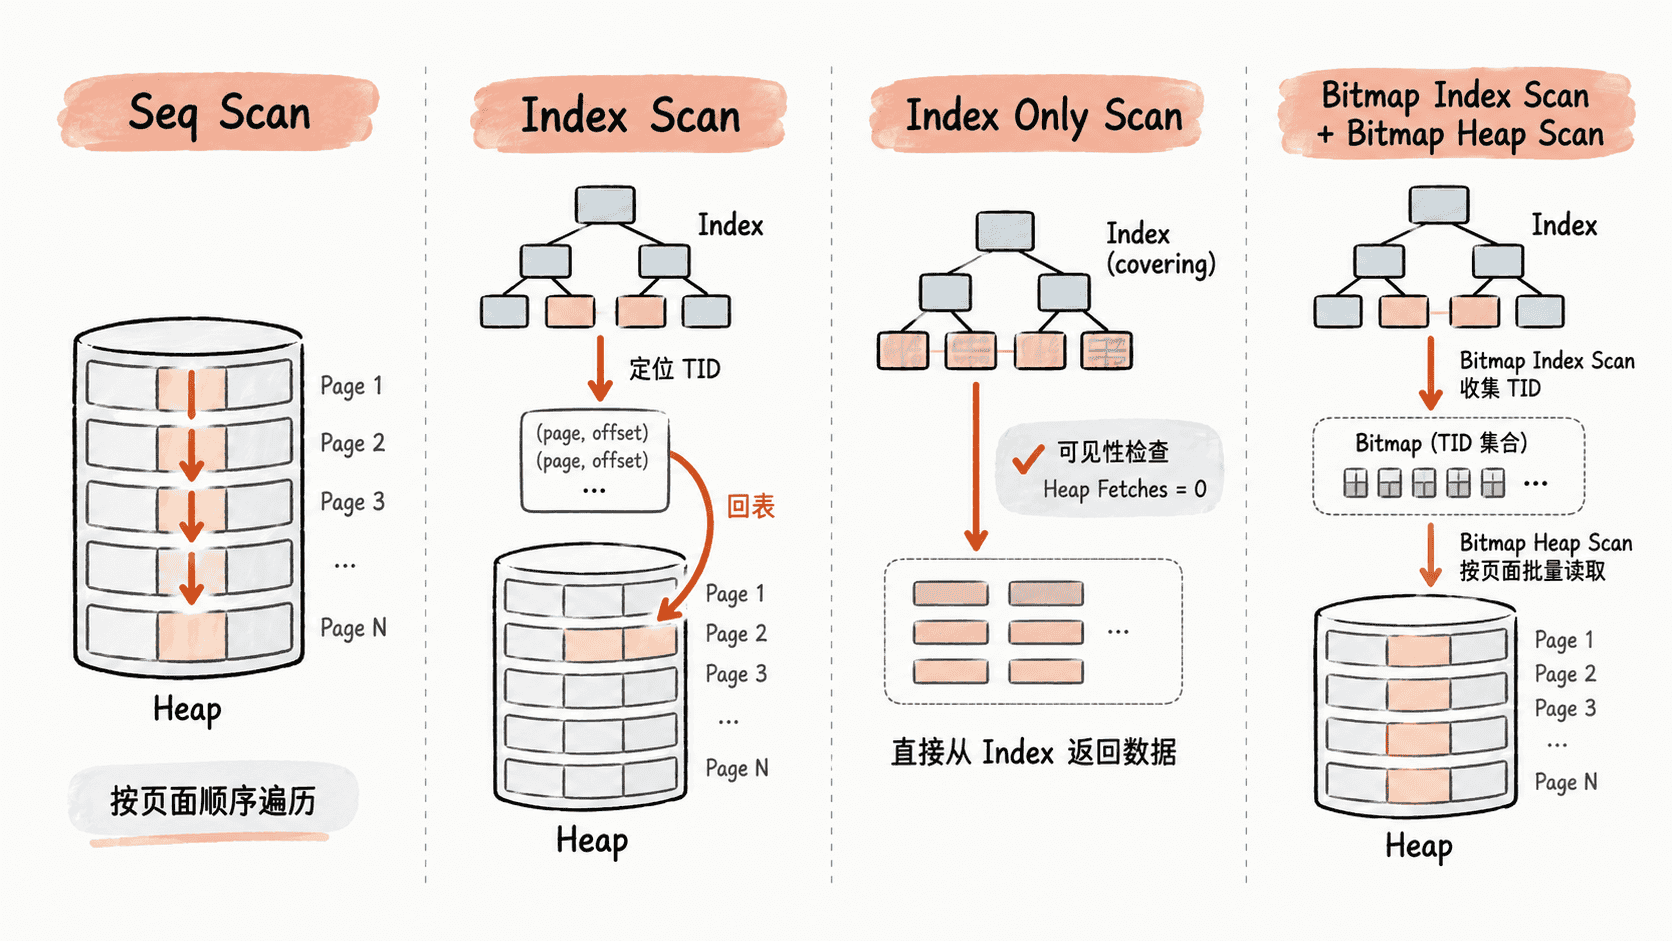
用计划节点判断过滤与回表
Seq Scan 并不等于“错误”。当返回比例较高、表很小,或者没有合适索引时,顺序扫描可能更便宜。Index Scan 通常适合选择性较高的条件;它可以利用索引快速定位,但如果查询还需要索引之外的列,就必须访问 Heap。
Index Only Scan 的关键不是“用了索引”这么简单,而是查询需要的列都能从索引获得,并且可见性映射允许 PostgreSQL 不必逐行回堆确认可见性。计划中的 Heap Fetches 是很重要的观察信号:数值较高时,理论上的“只读索引”仍然发生了不少堆访问。
Bitmap Scan 适合一次命中较多行、但又没有必要把整张表顺序扫完的情况。它通常由 Bitmap Index Scan 负责收集 TID,再交给 Bitmap Heap Scan 合并为页面级访问,因此不要把它理解成“另一种普通索引扫描”。
用实验直接辨认四类节点
下面的实验只用于建立节点直觉。通过关闭部分路径来稳定观察目标节点,不代表生产环境应长期关闭这些优化路径。
DROP TABLE IF EXISTS scan_demo;
CREATE TABLE scan_demo (
    id bigint PRIMARY KEY,
    customer_id integer NOT NULL,
    amount numeric(10,2) NOT NULL
);

INSERT INTO scan_demo (id, customer_id, amount)
SELECT g, (g % 100) + 1, (g % 5000) / 10.0
FROM generate_series(1, 10000) AS g;

CREATE INDEX scan_demo_customer_idx ON scan_demo (customer_id);
CREATE INDEX scan_demo_customer_amount_idx ON scan_demo (customer_id, amount);

ANALYZE scan_demo;
VACUUM (ANALYZE) scan_demo;

-- 教学用:关闭部分路径,让目标节点稳定出现。
SET enable_indexscan = off;
SET enable_indexonlyscan = off;
EXPLAIN (COSTS OFF) SELECT * FROM scan_demo WHERE amount >= 200.00;

SET enable_indexscan = on;
SET enable_indexonlyscan = off;
SET enable_bitmapscan = off;
EXPLAIN (COSTS OFF) SELECT customer_id, amount
FROM scan_demo
WHERE customer_id = 42;

SET enable_indexonlyscan = on;
SET enable_bitmapscan = off;
EXPLAIN (COSTS OFF) SELECT customer_id, amount
FROM scan_demo
WHERE customer_id = 42;

SET enable_indexonlyscan = off;
SET enable_indexscan = off;
SET enable_bitmapscan = on;
EXPLAIN (COSTS OFF) SELECT *
FROM scan_demo
WHERE customer_id BETWEEN 1 AND 50;
预期结果
Seq Scan on scan_demo
  Filter: (amount >= 200.00)

Index Scan using scan_demo_customer_idx on scan_demo
  Index Cond: (customer_id = 42)

Index Only Scan using scan_demo_customer_amount_idx on scan_demo
  Index Cond: (customer_id = 42)

Bitmap Heap Scan on scan_demo
  Recheck Cond: ((customer_id >= 1) AND (customer_id <= 50))
  -> Bitmap Index Scan on scan_demo_customer_idx
       Index Cond: ((customer_id >= 1) AND (customer_id <= 50))
实际计划仍可能包含成本、估算行数或其他细节;阅读时先抓住节点类型,再看 Filter、Index Cond、Recheck Cond 等字段。对于 Index Only Scan,使用 EXPLAIN (ANALYZE, BUFFERS) 时还应关注 Heap Fetches。
读懂节点时优先看哪些信号
看到 Seq Scan,先判断是否只是因为表小或命中比例高;看到 Index Scan,重点看索引条件和后续回表成本;看到 Index Only Scan,检查所需列是否都由索引覆盖,并观察 Heap Fetches;看到 Bitmap Heap Scan,则同时检查前面的 Bitmap Index Scan 和 Recheck Cond。
还有一个容易混淆的点:Filter 和 Index Cond 不是一回事。Index Cond 表示条件参与了索引定位,而 Filter 表示行已经被访问后才进一步过滤。索引设计真正有价值的地方之一,就是尽量让高选择性的条件进入可用于定位的索引条件,而不是把大量候选行取出来后再过滤。
当计划从 Index Scan 变成 Bitmap Heap Scan 时,不应只看节点名字判断优劣。真正需要比较的是估算行数、页面访问量、实际耗时以及是否发生大量随机堆访问。扫描节点是访问路径的结果,最终是否合理仍要结合数据分布、统计信息和实际执行证据判断。