
PostgreSQL / 系统课时
诊断自定义与通用计划
诊断自定义与通用计划
本课解决 Prepared Statement 在参数分布差异明显时为什么会出现计划不稳定,以及如何用 plan_cache_mode 把 custom plan 与 generic plan 分开验证,最终判断性能问题究竟来自参数敏感还是统计估算。
学习目标
- 区分 custom plan 与 generic plan 的生成条件、成本差异和适用场景。
- 使用
plan_cache_mode强制两种计划并观察执行与缓存计数。 - 根据数据倾斜、执行代价和计划选择判断是否存在参数敏感问题。
两种计划解决的是不同问题
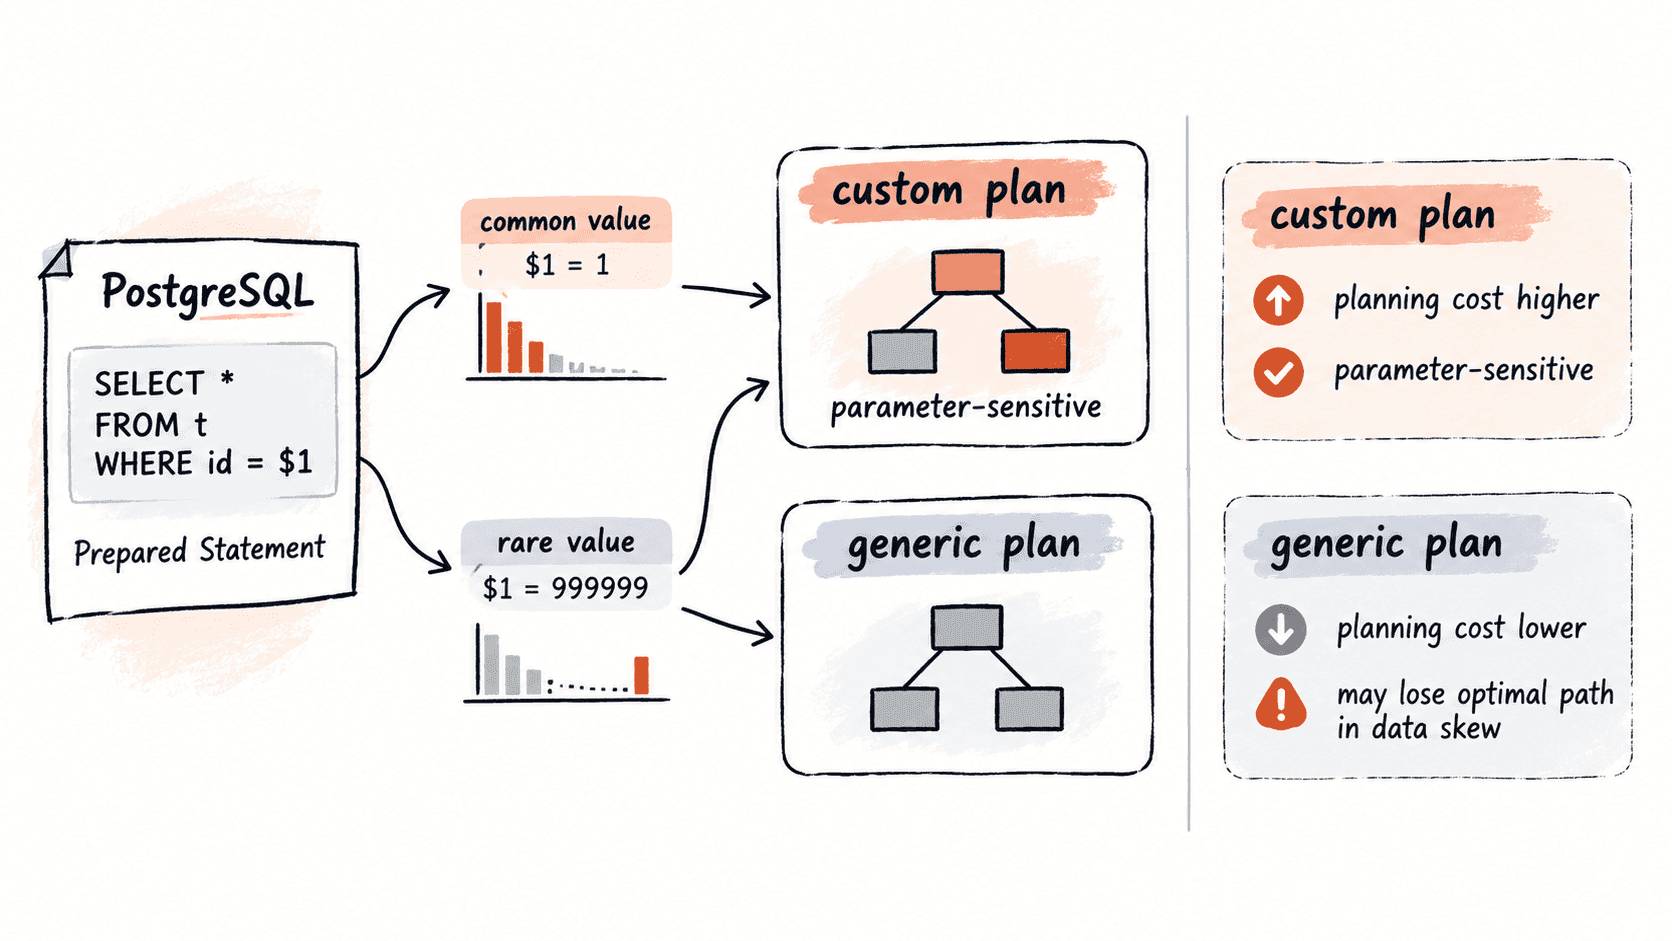
Prepared Statement 有参数时,PostgreSQL 可以为每次执行按实际参数重新规划,也可以复用不依赖参数值的通用计划。custom plan 能利用当前参数值,适合不同参数会对应明显不同访问路径的查询;generic plan 只规划一次并复用,能够节省重复规划成本。默认的 auto 会由服务器自行判断使用哪一种。
真正危险的是参数敏感:例如同一列中绝大多数值都很常见,只有少数值非常稀疏。查询常见值时顺序扫描或其他大范围访问可能更合适,查询稀疏值时索引可能更合适。如果 generic plan 无法利用当前参数差异,就可能在其中一类请求上持续表现不佳。
用强制模式建立诊断基线
诊断时不要一开始修改生产参数。先在可复现环境中准备一个带索引的参数化查询,再分别设置 force_custom_plan 和 force_generic_plan,观察两次执行的结果与计划计数。plan_cache_mode 的取值包括 auto、force_custom_plan 和 force_generic_plan;该设置作用于缓存计划执行阶段。
下面的示例故意使用两个会话参数值,并查询 pg_prepared_statements,这样即使具体执行计划因数据规模、版本或成本参数略有变化,也能先确认当前测试确实在走哪一种计划。
CREATE TABLE orders (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id bigint NOT NULL,
    amount numeric(12, 2) NOT NULL
);

CREATE INDEX orders_customer_id_idx ON orders(customer_id);

INSERT INTO orders (customer_id, amount)
SELECT CASE WHEN g <= 9900 THEN 1 ELSE g END,
       100.00
FROM generate_series(1, 10000) AS g;

ANALYZE orders;

PREPARE find_orders(bigint) AS
SELECT id, amount
FROM orders
WHERE customer_id = $1;

SET plan_cache_mode = force_custom_plan;
EXECUTE find_orders(1);
EXECUTE find_orders(9999);

SET plan_cache_mode = force_generic_plan;
EXECUTE find_orders(1);
EXECUTE find_orders(9999);

SELECT name, generic_plans, custom_plans
FROM pg_prepared_statements
WHERE name = 'find_orders';
预期结果
 name        | generic_plans | custom_plans
-------------+---------------+-------------
 find_orders |             2 |           2
这里的关键不是死记某一种 Index Scan 或 Seq Scan,而是先确认实验边界:前两次执行被强制使用 custom plan,后两次被强制使用 generic plan。然后再用 EXPLAIN (ANALYZE, BUFFERS) 比较两种模式下的实际访问代价。pg_prepared_statements 会记录 generic plan 与 custom plan 被选中的次数。
为什么数据倾斜会放大问题
统计信息描述的是列值分布,而 generic plan 在执行时不能根据这一次传入的具体参数重新选择路径。因此,当参数值对应的选择率相差很大时,固定计划更容易出现估算与实际行数不匹配。
排查时重点比较三件事:估算行数与实际行数是否严重偏离;不同参数执行时间是否呈现明显分层;强制 custom plan 后性能是否恢复。若三者同时成立,优先怀疑参数敏感,而不是简单认为“索引失效”。
还要注意一个常见误区:看到 generic plan 并不等于它一定更差。若参数分布均匀、执行次数很多且规划成本明显,复用通用计划反而可能更划算。真正需要治理的是“复用节省的规划成本”没有抵消“错误访问路径”带来的执行成本。
从验证结果到治理决定
线上诊断可以按这个顺序收敛。先确认是否为参数化语句,再用相同 SQL 和相同参数分别测试 custom、generic 两种模式;接着检查统计信息是否及时,最后才决定是否需要调整应用侧 Prepare 行为、SQL 结构或 plan_cache_mode。
不建议把 force_custom_plan 当成所有慢查询的全局开关。它解决的是参数值参与计划选择这一特定问题,而且会增加规划工作。更稳妥的做法是找到确实具有强参数敏感性的语句,证明 generic plan 在真实负载下持续劣化,再针对具体语句或连接范围治理。