
PostgreSQL / 系统课时
编写查询计划排障 Runbook
编写查询计划排障 Runbook
一份可执行的查询计划 Runbook,关键不是列出更多命令,而是规定证据顺序、风险闸门和停止条件:先固定慢 SQL 与参数,再安全采样计划,从叶子节点找首个估算偏差,按根因选择最小修复,最后用同条件计划完成验收和复盘。
学习目标
- 把慢查询证据采集、计划读取、误差判断和修复选择整理成固定顺序。
- 明确
EXPLAIN ANALYZE、统计变更和参数调整的生产风险边界。 - 为每次处置定义可重复的验证项与复盘记录,避免“改完变快就结束”。
先固定证据再做动作
Runbook 的第一条应是冻结上下文,而不是立即 ANALYZE 或改参数。至少记录 SQL 指纹、绑定参数、数据库、用户、application_name、开始时间、PostgreSQL 版本,以及问题发生时是否存在等待事件。活动中的 SQL 可以先从 pg_stat_activity 做只读采样。
SELECT
    pid,
    usename,
    application_name,
    state,
    wait_event_type,
    wait_event,
    now() - query_start AS query_age,
    left(query, 200) AS query_text
FROM pg_stat_activity
WHERE datname = current_database()
  AND state <> 'idle'
ORDER BY query_start;
预期结果
 pid  | usename | application_name | state  | wait_event_type | wait_event | query_age | query_text
------+---------+------------------+--------+-----------------+------------+-----------+----------------
 <PID>| <USER>  | <APP>            | active | <VALUE>         | <VALUE>    | <TIME>    | <SQL>
动态值会随现场变化。若目标 SQL 已结束,应从应用日志、APM 或已部署的 pg_stat_statements 中补齐 SQL 指纹与参数;Runbook 不应假设慢查询一定还在 pg_stat_activity 里。
按数据流读计划
计划读取顺序固定为“叶子扫描 → Join → Aggregate/Sort → 顶层输出”。对每个关键节点记录 estimated rows、actual rows、loops、Buffers 和是否发生磁盘 spill。先找第一个明显偏离真实数据的节点,因为上层误差往往只是被动放大。
对于可安全重放的 SELECT,可以在只读事务中设置本地超时后采样。下面是片段示例:必须把目标 SQL 替换成已经确认可在当前环境执行的查询。
BEGIN READ ONLY;
SET LOCAL statement_timeout = '5s';
SET LOCAL lock_timeout = '1s';

EXPLAIN (ANALYZE, BUFFERS, SETTINGS, SUMMARY, TIMING OFF)
SELECT *
FROM public.orders
WHERE status = 'pending'
  AND region = 'east';

ROLLBACK;
预期结果
BEGIN
SET
SET
<QUERY PLAN>
Planning Time: <TIME> ms
Execution Time: <TIME> ms
ROLLBACK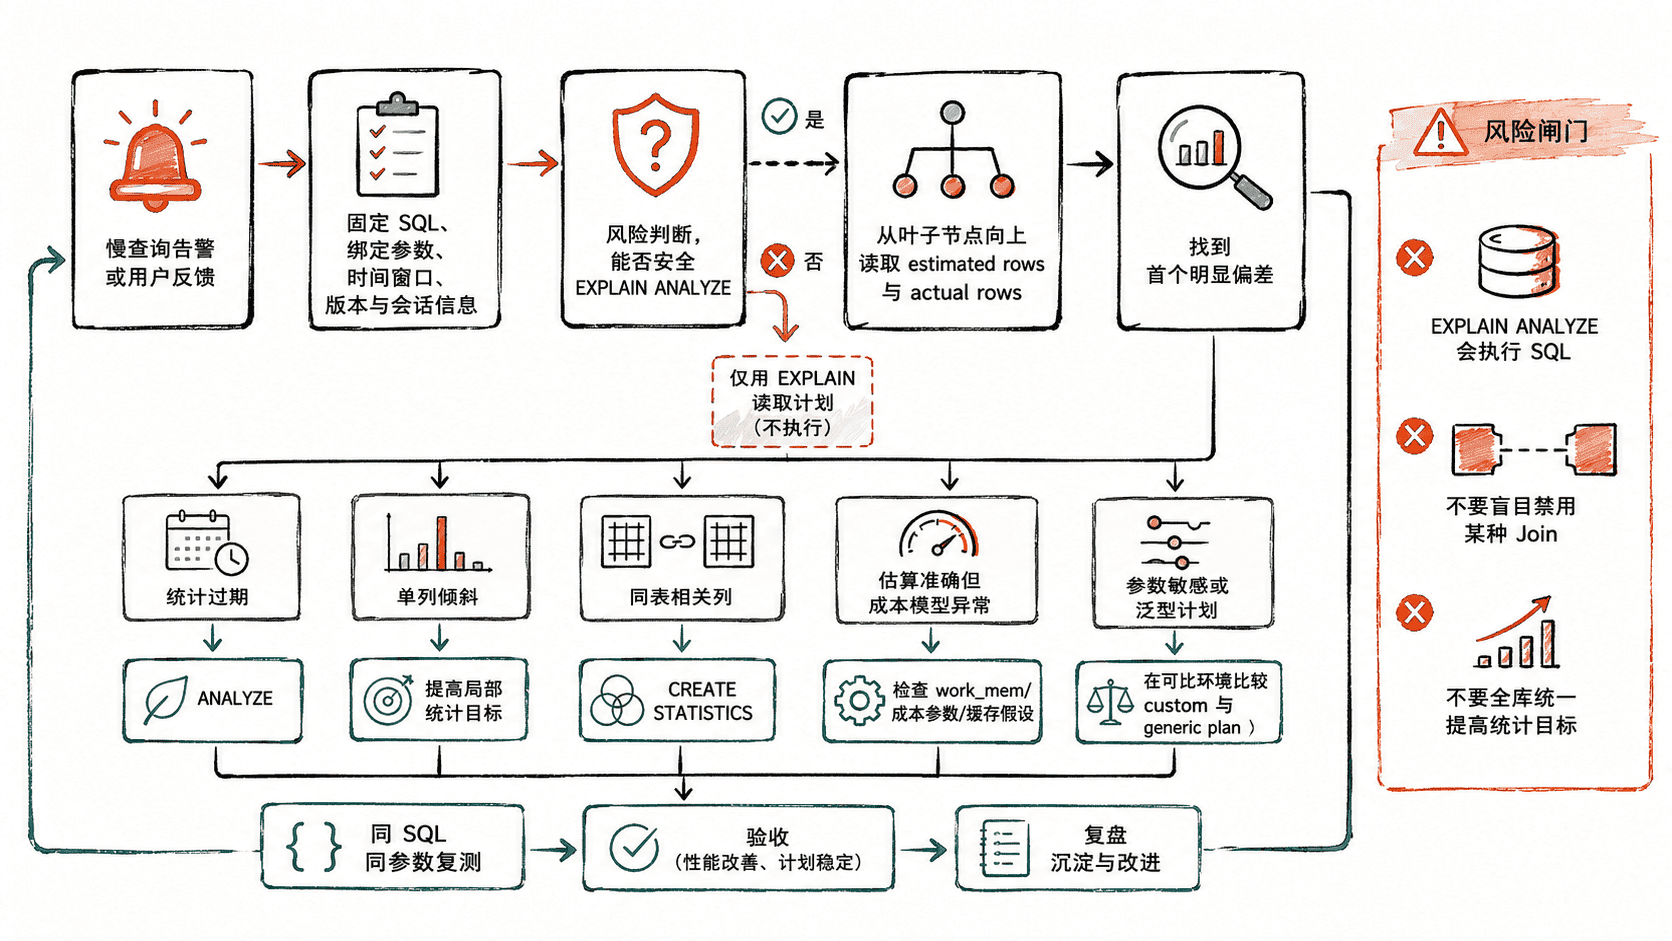
用证据选择修复手段
Runbook 应把“看到什么证据”与“允许做什么动作”绑定起来,避免经验式调参。
| 证据 | 优先动作 | 不应先做 |
|---|---|---|
| 单表叶子节点估算明显错误,统计更新时间落后于数据变化 | 对目标表执行 ANALYZE,再复测 |
直接改全局成本参数 |
| 单列热点或长尾导致估算粗糙 | 仅提高问题列的 statistics target,再 ANALYZE |
全表所有列统一设很高 target |
| 同一表多个条件存在明显相关性 | 建 dependencies、mcv 等扩展统计 |
指望普通多列索引自动修正选择率 |
| estimated rows 已接近 actual rows,但 Join/Sort 仍昂贵 | 检查 work_mem、缓存假设、I/O 成本和数据访问量 |
继续堆统计信息 |
| 同 SQL 因参数不同频繁翻计划 | 固定参数复现,并在可比环境比较 custom/generic plan | 只保存一份无参数执行计划 |
扩展统计只建模同一张表中的列或表达式关系,不能直接描述跨表相关性。若首个偏差出现在 Join 后而两侧输入估算都准确,应继续检查连接键分布、约束、过滤条件传播和数据模型,而不是机械创建 CREATE STATISTICS。
把风险控制写进 Runbook
每个“修复动作”前都应有明确闸门:执行人、影响对象、超时、回滚方法和停止条件。统计信息调整通常比改全局参数安全,但也不是零成本;更高统计目标会增加 ANALYZE 时间、统计目录体积与规划开销。
Runbook 还应明确禁止项:不要用 SET enable_nestloop = off、enable_hashjoin = off 之类开关作为长期修复;不要因为一次慢查询就修改集群级 random_page_cost 或 effective_cache_size;不要在缺少原始参数与基线计划时做不可逆变更。
对统计修复,推荐的变更顺序是“单表 ANALYZE → 局部提高 statistics target → 同表扩展统计 → 再考虑更广泛的配置或查询重写”。每一步都要复测,前一步已解决就停止扩大变更范围。
定义验收与复盘项
一次处置至少要同时满足四个验收条件:同 SQL 同参数可复现;首个估算偏差明显收敛;执行时间与 Buffers 不再异常;修复没有把另一类常用参数推向坏计划。若计划节点改变但估算仍严重错误,不能判定治理完成。
复盘记录应保留故障时间窗、SQL 指纹、关键参数、变更前后计划、首个偏差节点、采取的修复、回滚方式和最终结论。这样下一次遇到相似告警时,工程师可以沿同一证据链复现判断,而不是重新从“要不要加索引”开始猜。