
PostgreSQL / 系统课时
读懂离散度与高频值
读懂离散度与高频值
查看 pg_stats 时,n_distinct 告诉你一列大概有多少种值,most_common_vals 与 most_common_freqs 则指出哪些值明显更热。本课用一组可复现实验把三者连起来,并说明它们如何影响等值条件的行数估算。
学习目标
- 解释
n_distinct正值、负值与-1的含义 - 配对读取
most_common_vals与most_common_freqs - 根据高频值分布判断等值条件为何会得到不同的选择性估算
三个字段分别回答什么
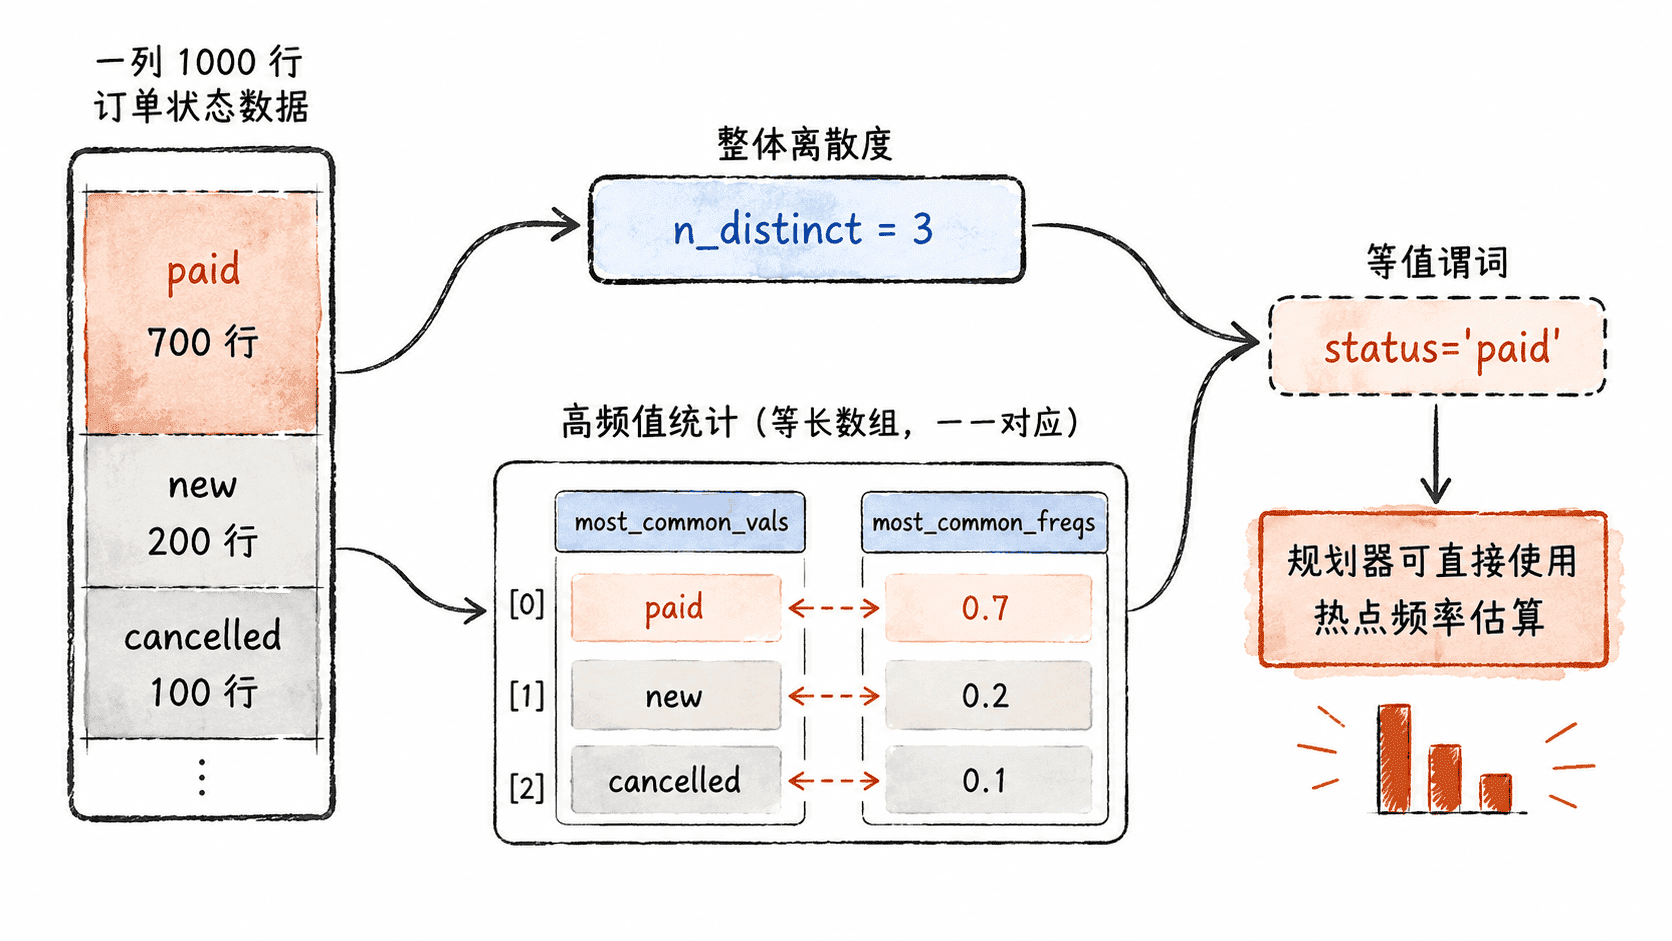
ANALYZE 会抽样列数据并把规划器统计信息写入系统目录,日常排查应优先阅读视图 pg_stats。其中 n_distinct 描述整体离散度,而 MCV(Most Common Values)描述分布中最突出的热点。
n_distinct 为正数时,它表示估计的不同值数量,例如 3 表示这一列大约只有 3 种值。它为负数时,绝对值表示“不同值数量 / 行数”的估计比例;例如 -0.8 表示不同值数量大约会随表规模增长到总行数的 80%。-1 因而接近“每行一个不同值”,但这只是统计估计,不能替代唯一约束。
most_common_vals 与 most_common_freqs 必须按数组位置配对理解:前者保存高频值,后者保存对应值占全表行数的频率。若某个值没有明显高于普通值,它可能不会进入 MCV 列表。
用实验观察热点分布
下面创建一个只有三种状态、但分布明显倾斜的临时表。把列级统计目标设为 1000,可以让这个小表的统计样本充分覆盖数据,再执行 ANALYZE。
CREATE TEMP TABLE mcv_lab AS
SELECT
    g AS id,
    CASE
        WHEN g <= 700 THEN 'paid'
        WHEN g <= 900 THEN 'new'
        ELSE 'cancelled'
    END AS status
FROM generate_series(1, 1000) AS g;

ALTER TABLE mcv_lab
    ALTER COLUMN status SET STATISTICS 1000;

ANALYZE mcv_lab;

SELECT
    n_distinct,
    most_common_vals,
    most_common_freqs
FROM pg_stats
WHERE schemaname LIKE 'pg_temp_%'
  AND tablename = 'mcv_lab'
  AND attname = 'status';

EXPLAIN
SELECT *
FROM mcv_lab
WHERE status = 'paid';
预期结果
n_distinct = 3
most_common_vals: 包含 paid、new、cancelled
most_common_freqs: 与上述值逐项对应,频率约为 0.7、0.2、0.1

Seq Scan on mcv_lab  (cost=<VALUE>..<VALUE> rows=700 width=<VALUE>)
  Filter: (status = 'paid'::text)
成本和行宽会因版本与环境不同而变化,MCV 数组的展示顺序也不应单独作为语义依据;真正需要读取的是“值数组与频率数组同下标配对”。这个实验中 paid 占 70%,所以规划器能把它与普通状态区别对待,而不是简单按 1 / 3 估算成约 33%。
等值条件怎样使用这些统计
当查询常量命中 MCV 时,规划器可以直接采用该值记录的频率作为选择性的重要依据。例如 status = 'paid' 的频率约为 0.7,在 1000 行表上就对应约 700 行。
当常量不在 MCV 中时,规划器会把扣除空值和 MCV 后的剩余概率质量,分摊到剩余不同值上,再估算这个普通值的命中比例。因此,n_distinct 决定“剩余值大概有多少种”,MCV 则先把最不均匀的热点从平均分摊中单独拿出来。
这也解释了为什么高偏斜列只看 n_distinct 会误判。两列都可能有 100 个不同值,但一列近似均匀,另一列可能有一个值占 60%;对于等值查询,两者的真实选择性完全不同。
排查时避免三个误区
不要把 n_distinct = -1 当作唯一性证明。统计信息来自 ANALYZE 的估计,约束语义应由 PRIMARY KEY、UNIQUE 等数据库对象保证。
不要把 most_common_freqs 当成独立排序后的频率表。它与 most_common_vals 是成对数组,脱离对应位置就失去“哪个频率属于哪个值”的含义。
也不要因为 MCV 中没有某个业务值,就断言这个值不存在。MCV 只保留统计目标允许范围内、足够突出的常见值;普通值仍可能存在,只是由剩余离散度和其他统计信息估算。