
PostgreSQL / 系统课时
区分估算、代价与执行问题
区分估算、代价与执行问题
慢查询出现坏计划时,最容易犯的错误是把所有问题都归结为“优化器选错了”。本课把诊断拆成估算、代价、访问结构和运行期四类证据,让你能从 EXPLAIN (ANALYZE, BUFFERS) 出发,先判断问题属于哪一层,再选择下一步验证。
学习目标
- 用估算行数与实际行数识别基数估算问题
- 区分代价模型偏差与缺少可用访问路径
- 在计划形状合理时继续定位 I/O、临时文件和等待问题
先把慢计划拆成三层证据
EXPLAIN 里的 rows 和 cost 都是规划阶段的预测,EXPLAIN ANALYZE 才会补上 actual rows、实际时间和循环次数。诊断时不要把它们混成一个指标:估算回答“会有多少行”,代价回答“候选计划谁更便宜”,执行证据回答“实际运行时资源花在哪里”。
| 现象 | 优先归类 | 下一步 |
|---|---|---|
rows 与 actual rows 相差一个或多个数量级 |
估算问题 | 查统计新鲜度、数据倾斜、列相关性 |
| 行数估算基本合理,但没有合适索引或谓词无法利用索引 | 访问结构问题 | 查索引、谓词、连接条件与 SQL 形态 |
| 行数估算合理,也存在可用候选路径,但稳定选择更慢方案 | 代价问题 | 对照缓存、存储与 planner cost 参数做受控实验 |
| 计划与估算都合理,实际时间、读块或等待显著上升 | 执行问题 | 查 I/O、临时文件、并发等待与资源限制 |
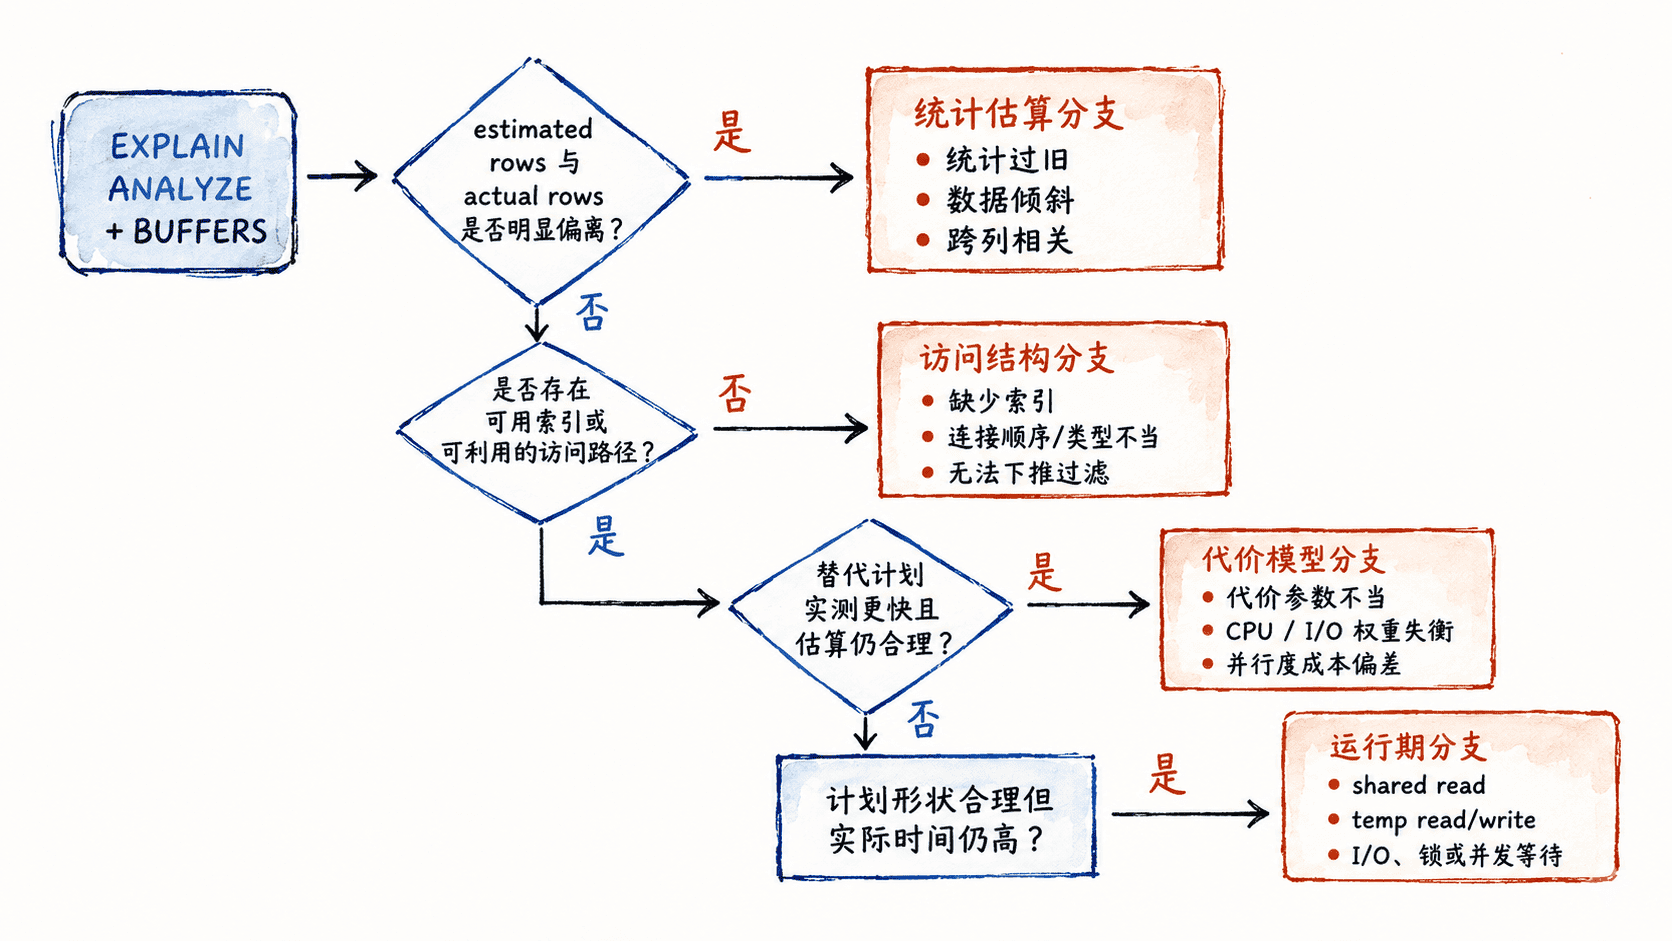
这张分流图的关键不是给每种慢查询贴永久标签,而是规定证据顺序:先看行数估算,再看候选访问路径和代价,最后看运行期资源。顺序反过来,常会出现“统计明明错了,却先调 random_page_cost”之类的误修。
用估算误差做第一道分流
下面的实验故意让统计信息落后于数据分布。首次 ANALYZE 时 paid 与 pending 各占一半,随后把绝大多数 paid 改成 pending,但不刷新统计,再观察规划行数和实际行数。
CREATE TEMP TABLE planner_diag (
    id integer PRIMARY KEY,
    status text NOT NULL,
    payload text NOT NULL
);

INSERT INTO planner_diag (id, status, payload)
SELECT g,
       CASE WHEN g <= 5000 THEN 'paid' ELSE 'pending' END,
       repeat('x', 100)
FROM generate_series(1, 10000) AS g;

ANALYZE planner_diag;

-- 制造统计信息与当前数据分布不一致:paid 实际只剩 100 行。
UPDATE planner_diag
SET status = 'pending'
WHERE id <= 4900;

EXPLAIN (ANALYZE, BUFFERS)
SELECT count(*)
FROM planner_diag
WHERE status = 'paid';
预期输出(代价、耗时和块数量会因环境不同而变化)
Aggregate  (cost=<VALUE> rows=1 width=8) (actual time=<TIME> rows=1 loops=1)
  ->  Seq Scan on planner_diag  (cost=<VALUE> rows=<ESTIMATED_THOUSANDS> width=0) (actual time=<TIME> rows=100 loops=1)
        Filter: (status = 'paid'::text)
        Rows Removed by Filter: 9900
        Buffers: local <HIT_OR_READ>=<VALUE>
Planning Time: <TIME> ms
Execution Time: <TIME> ms
如果扫描节点仍估算为数千行,而实际只有 100 行,第一结论应是选择率估算失真,而不是“顺序扫描一定错了”。先修正统计,再判断计划选择是否仍有问题。
ANALYZE planner_diag;

EXPLAIN (ANALYZE, BUFFERS)
SELECT count(*)
FROM planner_diag
WHERE status = 'paid';
预期输出(核心观察点是扫描节点的估算行数接近 100)
Aggregate  (cost=<VALUE> rows=1 width=8) (actual time=<TIME> rows=1 loops=1)
  ->  Seq Scan on planner_diag  (cost=<VALUE> rows=<ESTIMATED_NEAR_100> width=0) (actual time=<TIME> rows=100 loops=1)
        Filter: (status = 'paid'::text)
        Rows Removed by Filter: 9900
Planning Time: <TIME> ms
Execution Time: <TIME> ms
单列统计刷新后仍明显错估时,再检查值分布是否极端、统计目标是否过低,以及多个过滤列是否相关。只有确认统计证据不足,才进入提高列统计目标或创建扩展统计的路径。
估算正确后再判断代价与访问结构
“没有走索引”不能直接归类为代价问题。先问数据库是否真的存在可用路径:目标索引是否存在且有效,查询条件是否能匹配索引前导列或表达式,连接条件的数据类型和运算符是否适合索引访问。没有候选路径时,调低随机页代价也不会凭空生成索引。
如果估算已经可靠、索引也可用,但规划器仍稳定选择实测更慢的方案,才考虑代价假设。此时可以在会话级做受控对照,例如临时关闭某类计划节点以验证替代方案是否确实更快;这只是诊断手段,不应把 enable_seqscan=off、enable_nestloop=off 之类的开关当作长期“提示器”。
计划合理时继续看运行期
当估算行数接近实际行数,扫描与连接方式也符合数据规模,但查询仍慢,应转向执行证据。BUFFERS 能帮助区分缓存命中与物理读压力;排序或哈希节点出现磁盘临时文件、较多批次时,要检查内存预算;计划没有明显变化但耗时突然抬升时,还应从观察会话查看等待事件。
观察会话片段示例:将 <PID> 替换为目标后端 PID。
SELECT pid,
       state,
       wait_event_type,
       wait_event,
       now() - query_start AS query_age
FROM pg_stat_activity
WHERE pid = <PID>;
预期输出
 pid  | state  | wait_event_type | wait_event | query_age
------+--------+-----------------+------------+-----------
<PID> | active | <TYPE_OR_NULL>  | <EVENT>    | <TIME>
如果计划形状和估算都没有显著变化,却出现 IO、锁相关等待或临时文件增长,问题已经从“规划为什么这样选”转成“运行时为什么这么慢”。此时继续改统计或索引,往往不能解决根因。
最终可以用一条固定判断链收口:估算错先修统计;估算对但没有好路径则改访问结构或 SQL;候选路径齐全却稳定选错才校准代价;计划本身合理而实际慢,则排查运行期资源和并发等待。