
PostgreSQL / 系统课时
分析过滤选择性估算
分析过滤选择性估算
过滤条件看起来简单,查询计划却可能因为数据分布不同而估错行数。本课用一个可复现表,把 pg_stats 里的 MCV、NDV、null_frac 和直方图与 EXPLAIN ANALYZE 对上,建立“统计信息 → 选择性 → 估算行数”的分析方法。
学习目标
- 能从
pg_stats判断等值、空值和范围条件主要依赖哪类统计信息。 - 能用
EXPLAIN (ANALYZE)对比估算行数与实际行数,并反推选择性偏差。 - 能识别 MCV、NDV、直方图覆盖不足或统计信息过旧导致的估算问题。
先把选择性和估算行数对上
优化器并不是直接猜“会返回多少行”,而是先估算过滤条件的选择性,再乘以表的基数。可以把关系近似理解为:
下面构造一个 10000 行实验表。region 有明显倾斜,score 近似均匀分布,note 则包含 5% 左右的空值。
DROP TABLE IF EXISTS selectivity_lab;

CREATE TABLE selectivity_lab (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    region text NOT NULL,
    score integer NOT NULL,
    note text
);

INSERT INTO selectivity_lab (region, score, note)
SELECT
    CASE
        WHEN g <= 7000 THEN 'east'
        WHEN g <= 9000 THEN 'west'
        ELSE 'north'
    END,
    g % 1000,
    CASE WHEN g % 20 = 0 THEN NULL ELSE 'ok' END
FROM generate_series(1, 10000) AS g;

ANALYZE selectivity_lab;

SELECT
    attname,
    null_frac,
    n_distinct,
    most_common_vals,
    most_common_freqs,
    histogram_bounds IS NOT NULL AS has_histogram
FROM pg_stats
WHERE schemaname = current_schema()
  AND tablename = 'selectivity_lab'
ORDER BY attname;
预期结果:前置命令会创建并填充 10000 行数据;region 的 MCV 会接近 east=0.7、west=0.2、north=0.1;score 的 n_distinct 接近 1000,并通常具有直方图;note 的 null_frac 接近 0.05。统计采样和显示精度可能让具体数值略有差异。
DROP TABLE
CREATE TABLE
INSERT 0 10000
ANALYZE
 attname | null_frac | n_distinct | most_common_vals      | most_common_freqs    | has_histogram
---------+-----------+------------+-----------------------+----------------------+---------------
 id      | 0         | -1         | <VALUE>               | <VALUE>              | t
 note    | ~0.05     | 1          | {ok}                  | {~0.95}              | f
 region  | 0         | 3          | {east,west,north}     | {~0.7,~0.2,~0.1}     | f
 score   | 0         | 1000       | <VALUE>               | <VALUE>              | t
n_distinct 为正数时表示估算的不同值数量;为负数时表示“不同值数量约占表行数的某个比例”,例如接近 -1 通常意味着该列几乎每行都不同。
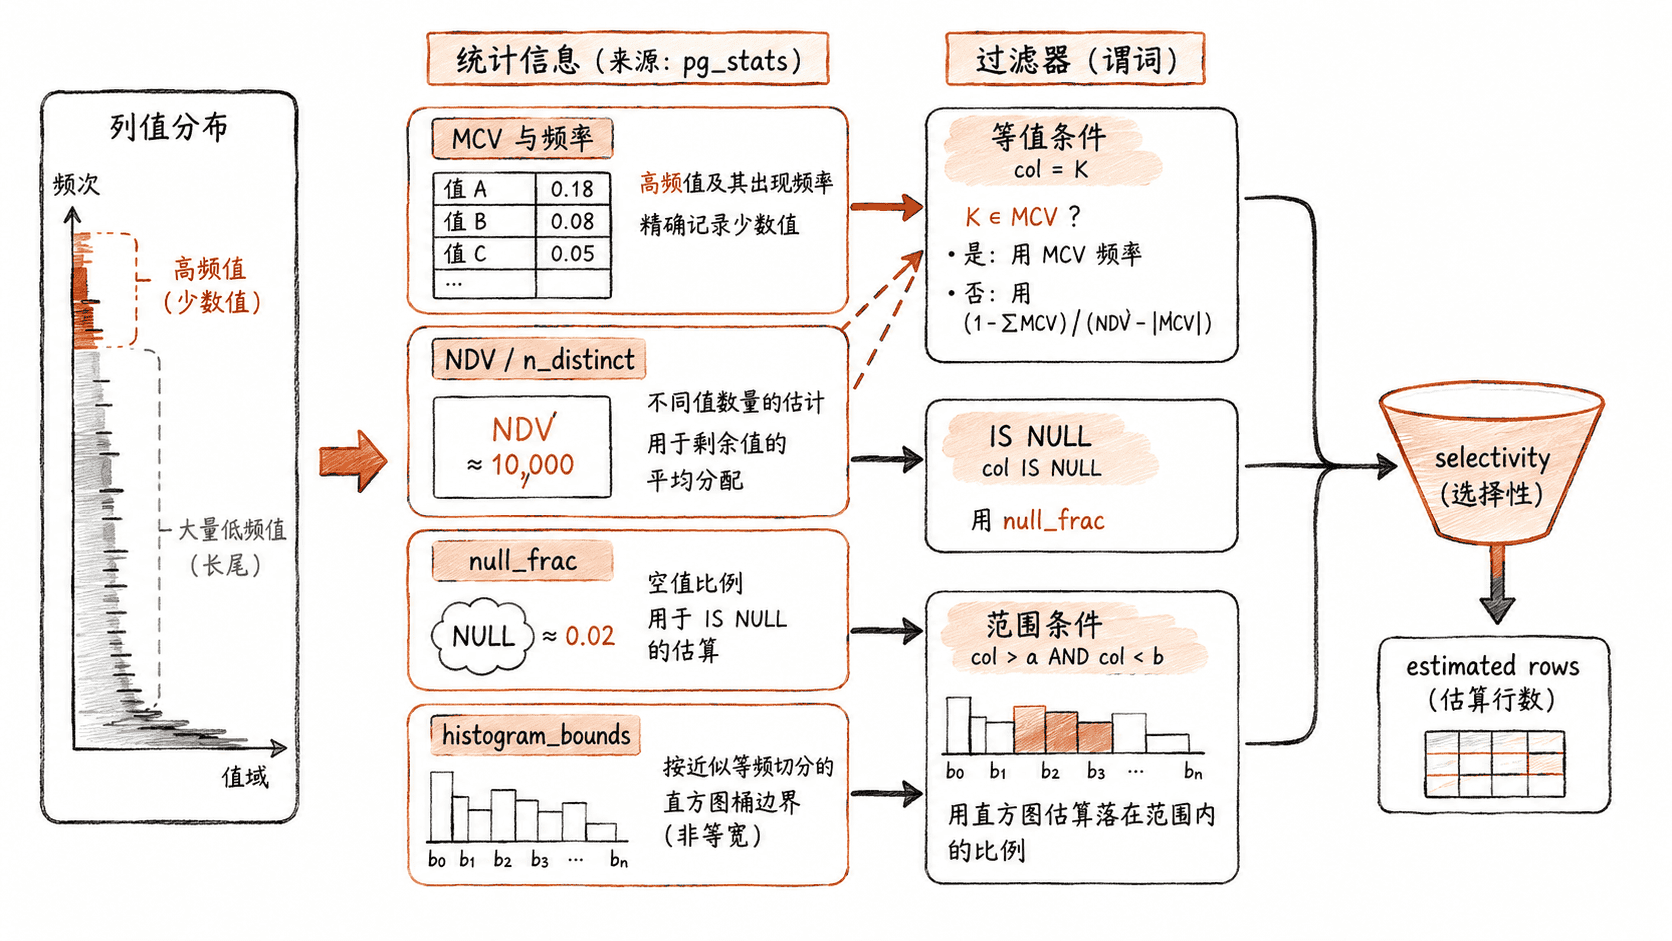
等值和空值条件怎么估
对于 region = 'east',east 已进入 MCV,优化器可以直接使用对应频率,选择性约为 0.7。若查询一个没有进入 MCV 的值,优化器会把“非空且不在 MCV 中的剩余概率质量”平均分配给剩余 NDV,因此数据越倾斜,单靠 NDV 越容易失真。
IS NULL 更直接:主要依据 null_frac。注意 col = NULL 在 SQL 三值逻辑中不会匹配空值,分析空值过滤应使用 IS NULL。
EXPLAIN (ANALYZE, COSTS ON)
SELECT * FROM selectivity_lab WHERE region = 'east';

EXPLAIN (ANALYZE, COSTS ON)
SELECT * FROM selectivity_lab WHERE note IS NULL;
预期输出:第一条计划的估算行数应接近 7000,实际行数也是 7000;第二条估算行数应接近 500,实际行数为 500。扫描方式可能因环境不同而变化,应重点比较 rows= 的估算值和 actual ... rows= 的实际值。
Seq Scan on selectivity_lab  (cost=<VALUE> rows=~7000 width=<VALUE>) (actual time=<TIME> rows=7000 loops=1)
  Filter: (region = 'east'::text)

Seq Scan on selectivity_lab  (cost=<VALUE> rows=~500 width=<VALUE>) (actual time=<TIME> rows=500 loops=1)
  Filter: (note IS NULL)
范围条件主要看直方图
范围过滤不能只靠 NDV。PostgreSQL 会用 histogram_bounds 近似描述非 MCV 数据的分布位置,再估算条件覆盖了多少桶以及桶内的比例。直方图桶追求近似等频,因此它不是把数值区间机械地切成相同宽度。
对均匀的 score 列,100 到 199 大约覆盖 10% 的数据:
EXPLAIN (ANALYZE, COSTS ON)
SELECT *
FROM selectivity_lab
WHERE score BETWEEN 100 AND 199;
预期输出:估算行数应接近 1000,实际行数为 1000;cost 和执行时间会因机器不同而变化。
Seq Scan on selectivity_lab  (cost=<VALUE> rows=~1000 width=<VALUE>) (actual time=<TIME> rows=1000 loops=1)
  Filter: ((score >= 100) AND (score <= 199))
如果某列既有 MCV 又有直方图,范围估算会综合处理:高频值由 MCV 单独计入,剩余分布由直方图近似,避免一个热点值把整段范围“平均掉”。
看到偏差时先检查什么
当 estimated rows 与 actual rows 相差一个数量级以上,不要先调扫描方式。先检查统计信息是否能描述当前分布:统计是否过旧、热点值是否进入 MCV、直方图粒度是否足够、表达式或函数过滤是否缺少可用统计信息。
可以先重新采样,再观察计划是否收敛:
ANALYZE selectivity_lab;

EXPLAIN (ANALYZE, COSTS ON)
SELECT *
FROM selectivity_lab
WHERE region = 'east'
  AND score BETWEEN 100 AND 199;
预期输出:重新 ANALYZE 后,单列统计会刷新;最终估算仍可能因多个条件的组合假设而出现偏差,这属于组合选择性问题,而不是单个 MCV 或直方图本身错误。
ANALYZE
Seq Scan on selectivity_lab  (cost=<VALUE> rows=<VALUE> width=<VALUE>) (actual time=<TIME> rows=<VALUE> loops=1)
  Filter: ((score >= 100) AND (score <= 199) AND (region = 'east'::text))
分析单条件过滤时,最有价值的顺序是:先确认表基数,再定位该谓词依赖的统计类型,最后用估算行数与实际行数验证。只看 EXPLAIN 选了哪个扫描节点,往往会跳过真正的误差来源。