
PostgreSQL / 系统课时
分析排序与聚合节点
分析排序与聚合节点
本课解决执行计划中另一个高频判断题:看到 Sort、Incremental Sort、Aggregate、HashAggregate 或 GroupAggregate 时,如何知道数据正在怎样排列、聚合,以及内存是否可能成为瓶颈。读完后,你能从节点组合判断排序成本和聚合策略。
学习目标
- 区分 Sort 与 Incremental Sort 的排序输入假设
- 识别 Aggregate、HashAggregate 与 GroupAggregate 的工作方式
- 用 EXPLAIN 观察排序方法、分组方式与节点组合
排序节点如何理解
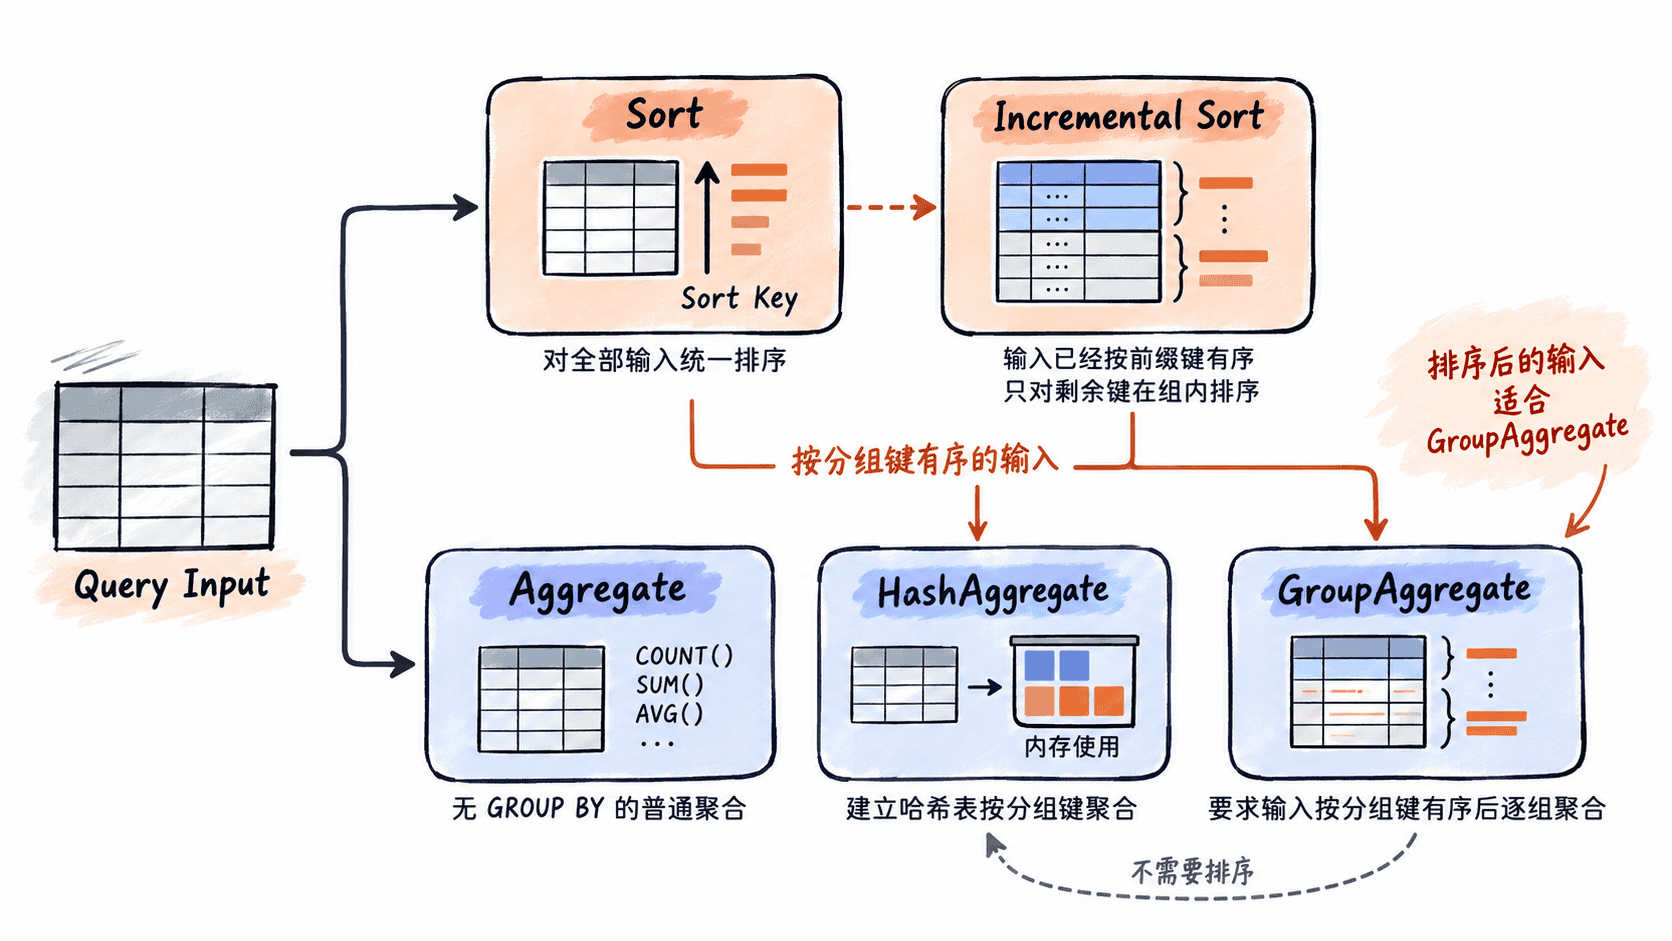
Sort 表示执行器需要把输入整体按指定键排序。计划中常见的 Sort Key 能直接告诉你排序依据;使用 EXPLAIN (ANALYZE) 时还应关注 Sort Method、内存使用以及必要时出现的磁盘临时文件信号。
Incremental Sort 的思路不同:输入已经按排序键的前缀有序,执行器只需要在一个个已经形成的组内继续排序,而不是把全部输入当成一块重新排序。它的价值通常来自“已有部分有序性”,因此阅读时要同时向上看输入节点的排序路径。
三种聚合节点看什么
Aggregate 常见于没有 GROUP BY 的场景,例如计算总数、平均值或最大值。它接收一批输入并产生一个或少数几个聚合结果。真正阅读复杂计划时,不要把它和 GroupAggregate 混为一谈,后者强调按分组顺序处理组。
HashAggregate 以分组键建立哈希表,把属于同一组的行聚合到一起。它通常不要求输入事先排序,但内存压力会影响执行表现。GroupAggregate 则依赖按分组键有序的输入,因此前面经常会出现 Sort,也可能直接利用已经存在的索引顺序。
因此,看到 Sort -> GroupAggregate,应进一步问“排序为什么出现”;看到 HashAggregate,则优先关注分组数量、内存和是否发生批次化处理。节点本身没有绝对的好坏,合理性取决于数据量、排序成本、分组基数和现有路径。
用 SQL 观察节点组合
下面用一个可重复的小实验观察排序和三类聚合。实验通过调整规划开关来稳定展示目标节点,目的是学习读计划的方法,而不是给生产系统提供固定配置。
DROP TABLE IF EXISTS agg_demo;
CREATE TABLE agg_demo (
    id bigint PRIMARY KEY,
    region text NOT NULL,
    amount numeric(10,2) NOT NULL
);

INSERT INTO agg_demo (id, region, amount)
SELECT g,
       CASE WHEN g % 4 = 0 THEN 'east'
            WHEN g % 4 = 1 THEN 'west'
            WHEN g % 4 = 2 THEN 'north'
            ELSE 'south' END,
       (g % 1000) / 10.0
FROM generate_series(1, 10000) AS g;

CREATE INDEX agg_demo_region_idx ON agg_demo (region);
ANALYZE agg_demo;

EXPLAIN (COSTS OFF)
SELECT * FROM agg_demo ORDER BY amount DESC;

SET enable_hashagg = on;
EXPLAIN (COSTS OFF)
SELECT region, count(*)
FROM agg_demo
GROUP BY region;

SET enable_hashagg = off;
EXPLAIN (COSTS OFF)
SELECT region, count(*)
FROM agg_demo
GROUP BY region;

EXPLAIN (COSTS OFF)
SELECT count(*) FROM agg_demo;
预期结果
Sort
  Sort Key: amount DESC
  -> Seq Scan on agg_demo

HashAggregate
  Group Key: region
  -> Seq Scan on agg_demo

GroupAggregate
  Group Key: region
  -> Sort
       Sort Key: region
       -> Seq Scan on agg_demo

Aggregate
  -> Seq Scan on agg_demo
真实环境中的节点组合可能因统计信息、索引、成本参数和数据规模不同而变化。实验中的 enable_hashagg 等设置只是为了观察节点,不应把它们当成常规调优手段。
排查排序和聚合的实际成本
排序出现时,先看它是否真的必要:查询是否要求 ORDER BY、上游是否已经提供所需顺序、是否存在可利用的索引路径。再看 EXPLAIN (ANALYZE, BUFFERS) 的实际执行证据,尤其留意排序方法和是否出现磁盘相关信号,因为超出可用内存后,排序成本会明显上升。
聚合出现时,先确认分组键与预期一致,再比较 HashAggregate 和 GroupAggregate 的输入条件。前者更依赖哈希结构的内存空间,后者更依赖输入顺序。若看到 Sort -> GroupAggregate,可以进一步检查排序是否能够由索引顺序消除;若看到 HashAggregate,则应关注分组数量是否远高于估算,以及实际执行是否出现多批次处理。
读计划时不要孤立解释某一个节点。排序、索引顺序和聚合策略经常互相影响:一个能够提供既定顺序的访问路径,可能减少独立排序;而一个不需要排序的聚合路径,又可能改变优化器对整体成本的判断。真正有价值的判断,是从当前节点一路向上追到输入,再结合实际行数与资源消耗验证。