
PostgreSQL / 系统课时
演练错误基数估算故障
演练错误基数估算故障
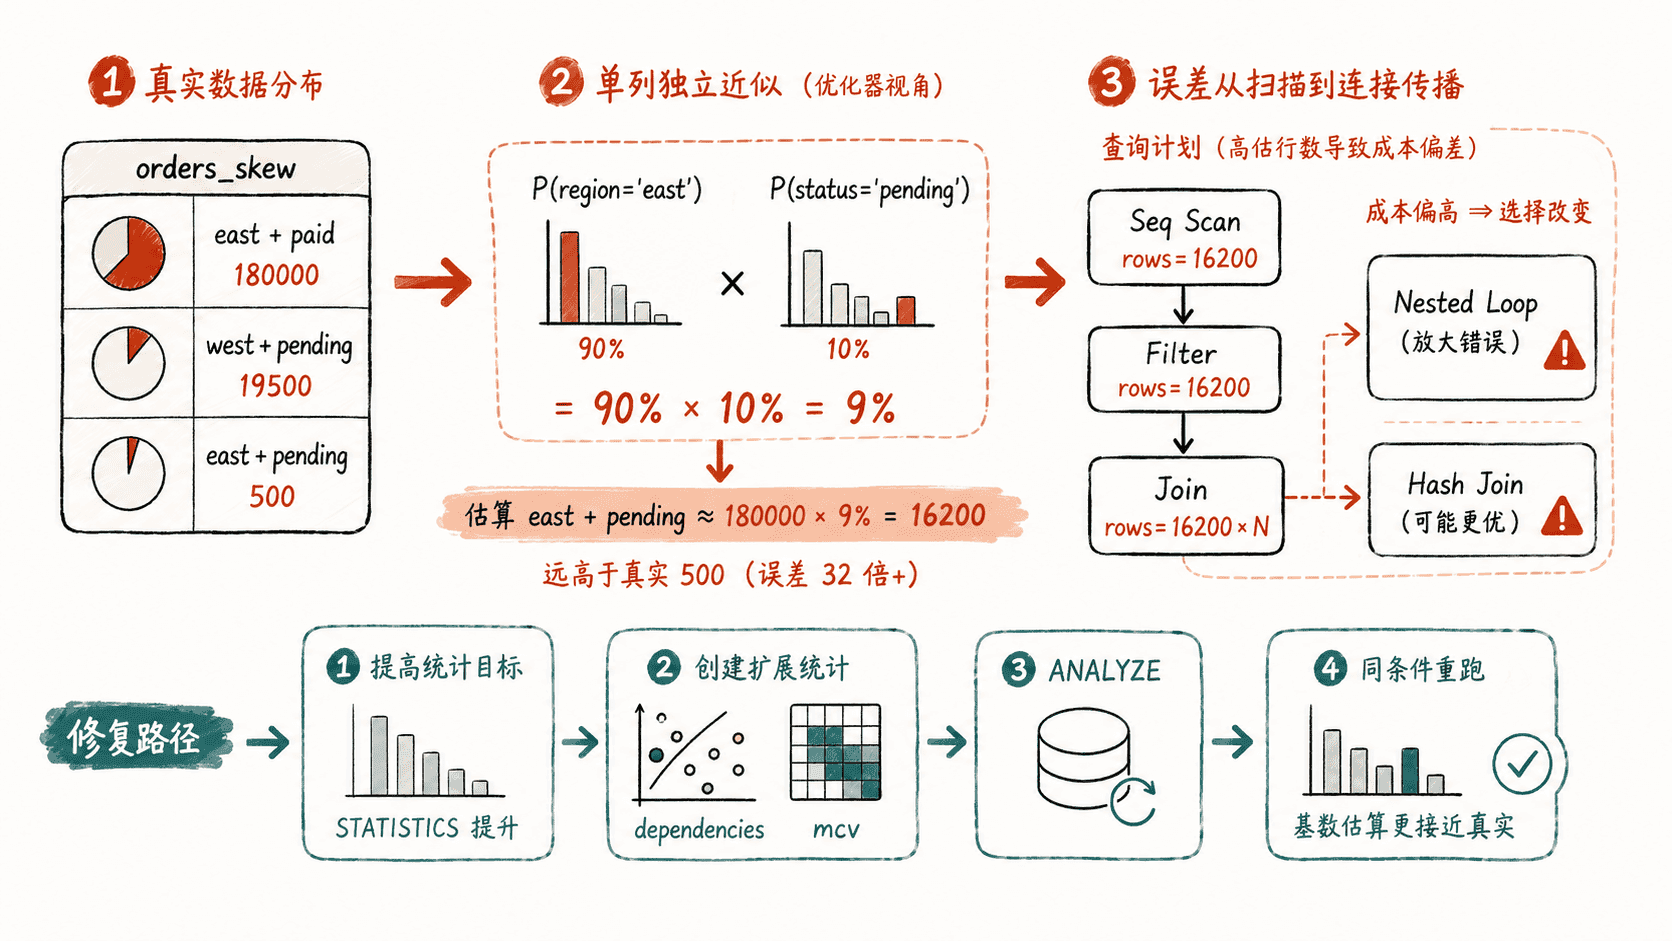
这次演练专门处理一种很容易误判为“索引失效”的慢查询:单列统计看起来都正常,但相关列与数据倾斜让优化器把 500 行估成上万行,错误一路放大到连接策略。目标是从执行计划找到首个偏差节点,再用统计信息修复并做同条件验证。
学习目标
- 构造并识别“单列分布合理、组合分布异常”的基数估算故障。
- 从
EXPLAIN ANALYZE中按数据流定位第一个明显的 estimated rows / actual rows 偏差。 - 使用更高统计目标与扩展统计修复相关列估算,并验证计划是否稳定。
构造相关列与倾斜数据
在空白实验库中建立两张表。orders_skew 共 20 万行,其中 east + pending 只有 500 行;但单看 region 和 status,east 很常见、pending 也不算罕见。如果优化器近似按独立事件相乘,就会把这个组合严重高估。
CREATE SCHEMA cardinality_lab;
SET search_path = cardinality_lab, public;

CREATE TABLE orders_skew (
    id bigint PRIMARY KEY,
    region text NOT NULL,
    status text NOT NULL,
    payload text NOT NULL
);

INSERT INTO orders_skew (id, region, status, payload)
SELECT
    g,
    CASE
        WHEN g <= 180000 THEN 'east'
        WHEN g <= 199500 THEN 'west'
        ELSE 'east'
    END,
    CASE
        WHEN g <= 180000 THEN 'paid'
        ELSE 'pending'
    END,
    repeat('x', 200)
FROM generate_series(1, 200000) AS g;

CREATE TABLE order_events (
    event_id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    order_id bigint NOT NULL,
    event_type text NOT NULL
);

INSERT INTO order_events (order_id, event_type)
SELECT o.id, v.event_type
FROM orders_skew AS o
CROSS JOIN (VALUES ('created'), ('validated'), ('settled')) AS v(event_type);

CREATE INDEX orders_skew_region_status_idx
    ON orders_skew (region, status);
CREATE INDEX order_events_order_id_idx
    ON order_events (order_id);

ANALYZE orders_skew;
ANALYZE order_events;
预期输出
CREATE SCHEMA
SET
CREATE TABLE
INSERT 0 200000
CREATE TABLE
INSERT 0 600000
CREATE INDEX
CREATE INDEX
ANALYZE
ANALYZE
先确认真实组合基数,避免把后续判断建立在猜测上。
SELECT region, status, count(*) AS rows
FROM orders_skew
WHERE region = 'east' AND status = 'pending'
GROUP BY region, status;
预期输出
 region | status  | rows
--------+---------+------
 east   | pending |  500
从执行计划找首个估算偏差
执行目标查询时,不要先盯最上面的总耗时,而要从叶子扫描节点沿数据流向上比较 rows= 与 actual rows=。如果最早的扫描节点已经错了几十倍,后面的 Join、Aggregate 只是继承并放大偏差。
EXPLAIN (ANALYZE, BUFFERS, SUMMARY, TIMING OFF)
SELECT e.event_type, count(*)
FROM orders_skew AS o
JOIN order_events AS e
  ON e.order_id = o.id
WHERE o.region = 'east'
  AND o.status = 'pending'
GROUP BY e.event_type
ORDER BY e.event_type;
预期结果
<SCAN orders_skew> ... rows=<EST_ROWS> ... actual rows=500 loops=1
<JOIN NODE>       ... rows=<EST_JOIN_ROWS> ... actual rows=1500 loops=1
Planning Time: <TIME> ms
Execution Time: <TIME> ms
实际节点类型、成本和时间会随 PostgreSQL 版本、硬件与参数不同。这里真正要记录的是:orders_skew 扫描节点的估算是否远高于 500,以及这个误差是否继续传到 Join。可用 max(estimated / actual, actual / estimated) 作为误差倍数;通常先处理最靠近数据源、且误差最大的节点。
判断应该补哪类统计信息
这类故障不能只靠“再建一个索引”解决。单列 MCV 已能分别看到 east 和 pending 的频率,问题在于它不知道两列组合并不独立。修复时应先按证据选择统计手段,而不是把所有列的统计目标一起拉高。
同一张表内的等值条件存在相关性时,优先考虑 CREATE STATISTICS ... (dependencies, mcv);单列本身有大量热点值或长尾值时,再提高该列的统计目标。跨表相关性不会被扩展统计直接建模,此时要继续检查 Join 输入、约束、查询写法和数据模型。
修复统计并重新采样
对本例同时提高两个关键列及扩展统计对象的统计目标,然后重新 ANALYZE。更高目标意味着更大的样本和更细的统计信息,但也会增加分析时间、统计目录体积和规划成本,因此只应施加在确有估算问题的对象上。
ALTER TABLE orders_skew
    ALTER COLUMN region SET STATISTICS 1000;
ALTER TABLE orders_skew
    ALTER COLUMN status SET STATISTICS 1000;

CREATE STATISTICS orders_region_status_stats
    (dependencies, mcv)
    ON region, status
    FROM orders_skew;

ALTER STATISTICS orders_region_status_stats
    SET STATISTICS 1000;

ANALYZE orders_skew;

SELECT
    statistics_name,
    kinds,
    most_common_vals IS NOT NULL AS has_mcv,
    dependencies IS NOT NULL AS has_dependencies
FROM pg_stats_ext
WHERE schemaname = 'cardinality_lab'
  AND statistics_name = 'orders_region_status_stats';
预期输出
ALTER TABLE
ALTER TABLE
CREATE STATISTICS
ALTER STATISTICS
ANALYZE
       statistics_name        | kinds | has_mcv | has_dependencies
------------------------------+-------+---------+-----------------
 orders_region_status_stats   | {f,m} | t       | t
kinds 中 f 表示 functional dependencies,m 表示 multivariate MCV。若视图输出格式略有差异,以 has_mcv = true、has_dependencies = true 为验收重点。
用同一查询完成闭环验收
修复后必须用相同 SQL、相同参数和可比环境重新执行计划,不能只以“已经 ANALYZE”作为完成标志。重点比较首个偏差节点的估算是否靠近 500,以及上游 Join 估算是否随之收敛;计划节点是否更换只是结果,不是唯一成功标准。
EXPLAIN (ANALYZE, BUFFERS, SUMMARY, TIMING OFF)
SELECT e.event_type, count(*)
FROM orders_skew AS o
JOIN order_events AS e
  ON e.order_id = o.id
WHERE o.region = 'east'
  AND o.status = 'pending'
GROUP BY e.event_type
ORDER BY e.event_type;
预期结果
<SCAN orders_skew> ... rows=<EST_ROWS_NEAR_500> ... actual rows=500 loops=1
<JOIN NODE>       ... rows=<EST_JOIN_ROWS_NEAR_1500> ... actual rows=1500 loops=1
Planning Time: <TIME> ms
Execution Time: <TIME> ms
如果估算已经明显收敛但执行仍慢,就应把调查方向转向 I/O、缓存命中、work_mem、连接算法成本或下游节点,而不是继续无上限提高统计目标。真正完成闭环的标准是“首个错误假设被证据定位、修复后误差收敛、同条件计划与执行表现可解释”。