
PostgreSQL / 系统课时
理解计划树与数据流
理解计划树与数据流
执行计划真正难读的地方,不是节点名称,而是父子关系和运行时数据方向。读懂缩进、子树与逐层返回的元组后,就能区分“顶层总耗时”与“真正制造大量工作量的下层节点”。
学习目标
- 根据缩进准确识别父节点、子节点和兄弟节点
- 理解执行器“父节点取数、子节点产出”的数据流方向
- 结合
actual rows、loops与Buffers定位异常子树
从缩进识别计划树
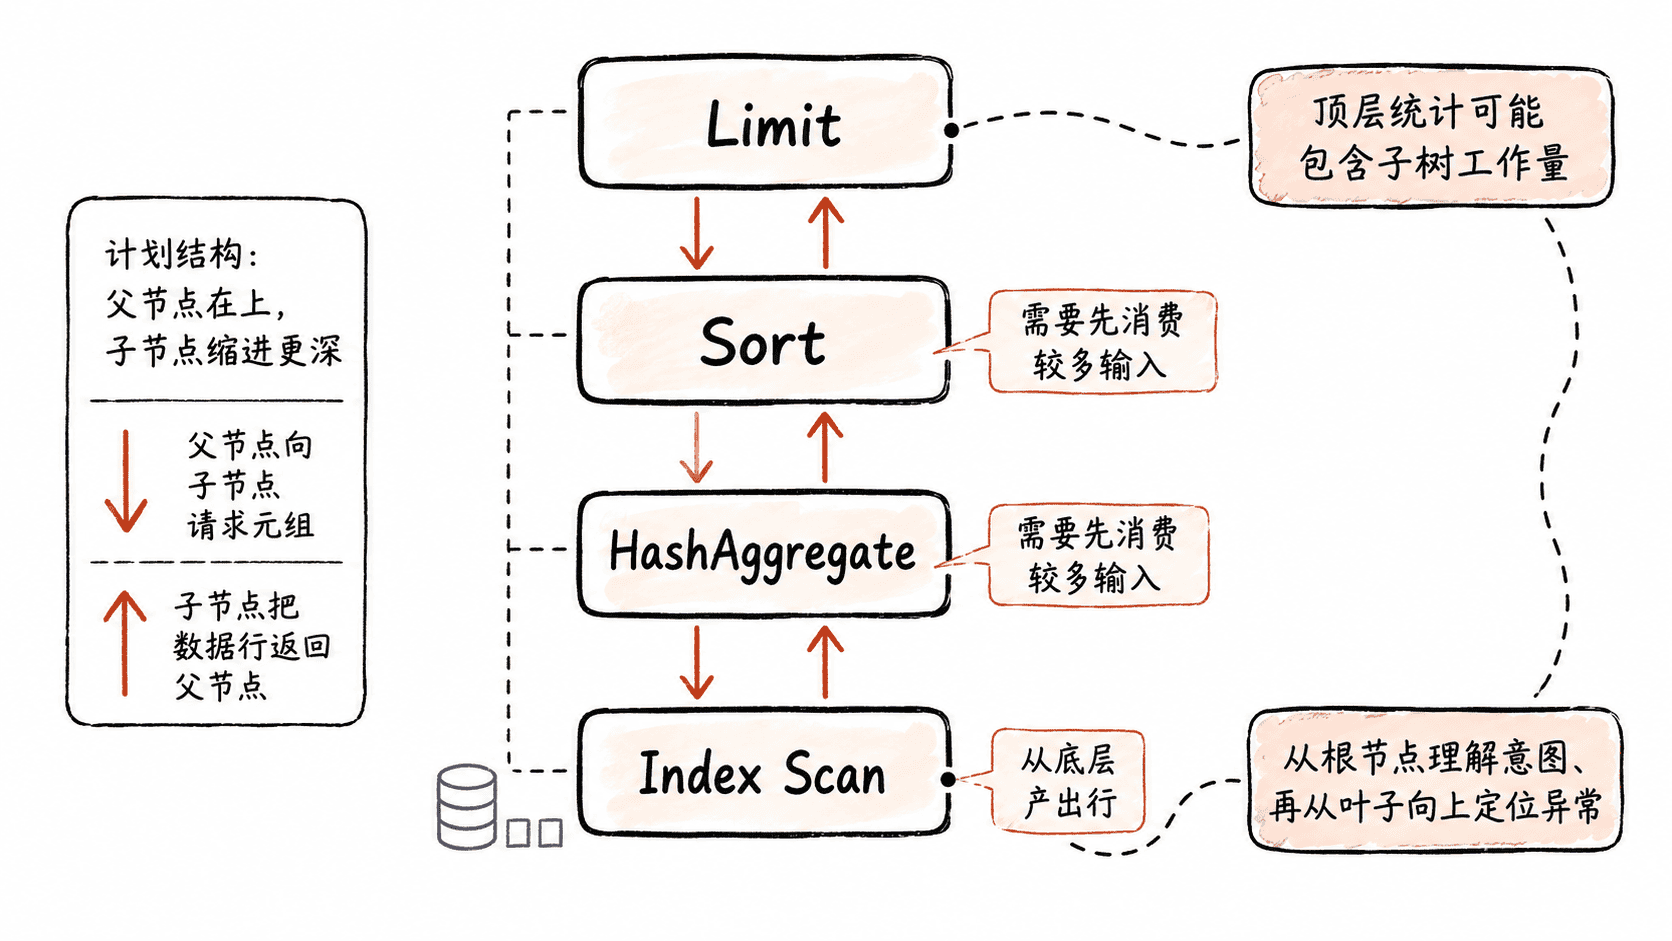
EXPLAIN 的第一行是根节点,缩进更深并带 -> 的行是它的子节点。一个父节点可以有一个或多个子节点;例如 Sort 通常只有一个输入,而 Hash Join 会同时依赖外侧输入与用于构建哈希表的内侧输入。
计划树适合分两次读:先从根节点向下理解“这条 SQL 最终要完成什么”,再从叶子节点向上追踪“底层扫描产生了多少行,经过哪些节点后被放大、过滤或聚合”。不要把文本顺序误解成严格的执行先后。
用一条计划观察层级
下面创建临时表并执行一个“范围扫描 → 聚合 → 排序 → 限制”的查询。临时表只在当前会话存在,适合实验;计划中的代价、缓冲区和个别节点选择可能因 PostgreSQL 版本与环境不同而变化。
CREATE TEMP TABLE plan_tree_demo (
    id integer PRIMARY KEY,
    category integer NOT NULL,
    amount numeric(10, 2) NOT NULL
);

INSERT INTO plan_tree_demo
SELECT g, g % 10, (g % 1000)::numeric / 10
FROM generate_series(1, 100000) AS g;

ANALYZE plan_tree_demo;

EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT category, sum(amount) AS total
FROM plan_tree_demo
WHERE id BETWEEN 1000 AND 1100
GROUP BY category
ORDER BY total DESC
LIMIT 3;
预期输出(结构片段,缓冲区数字等实际值可能不同):
Limit (actual rows=3 loops=1)
  ->  Sort (actual rows=3 loops=1)
        Sort Key: (sum(amount)) DESC
        ->  HashAggregate (actual rows=10 loops=1)
              Group Key: category
              ->  Index Scan using plan_tree_demo_pkey on plan_tree_demo (actual rows=101 loops=1)
Index Cond: ((id >= 1000) AND (id <= 1100))从缩进可知,Limit 不是“先执行”的第一步,而是整棵子树的消费者。它向 Sort 要结果,Sort 又依赖 HashAggregate,最终数据由最深处的扫描节点产生并逐层向上交付。
理解运行时的拉取模型
PostgreSQL 执行器可以把多数节点理解为迭代器:父节点请求下一行,子节点完成必要工作后返回一行或一批结果。因此存在两个方向:控制请求向下传递,数据元组向上返回。
并非所有节点都能立刻产出第一行。Index Scan 通常可以边扫描边返回;Sort 往往需要先消费全部输入再输出有序结果;普通 HashAggregate 也需要先读取输入并构建聚合状态。正因为存在这种差异,只看根节点的结束时间无法判断工作量到底在哪一层形成。
用运行统计定位异常子树
开启 ANALYZE 后,重点不要只盯根节点。actual rows 表示节点每次执行平均产出的行数,loops 表示该节点被执行多少次;当 loops 大于 1 时,应把两者结合起来判断总产出规模。嵌套循环连接的内侧扫描尤其容易出现“单次不大,但被重复执行很多次”的问题。
Buffers 能补充 I/O 证据,但父节点显示的统计可能包含其子树造成的工作量,所以应沿树向下寻找首次明显增加的位置。若某个叶子扫描估计几十行却实际返回几十万行,后续 Sort 或 HashAggregate 很慢往往只是结果,不一定是最初原因。
实际排查可以保持一个稳定顺序:先从根节点向下确认 SQL 的逻辑结构,再从叶子向上核对扫描行数和循环次数,最后判断排序、聚合、连接等上层节点是在制造成本,还是只是在承接下层已经产生的大量数据。