
PostgreSQL / 系统课时
理解 ANALYZE 采样与刷新
理解 ANALYZE 采样与刷新
ANALYZE 不是把整张表的每个值都记录下来,而是通过采样更新规划器所需的近似统计。本课把“数据变化、采样、统计目录、计划估算”串起来,并用一个小实验观察统计在刷新前后为何会滞后。
学习目标
- 说明
ANALYZE如何通过采样生成列统计与表级行数估算 - 解释统计为什么会随数据变化而变旧,以及自动分析为何不等于实时刷新
- 用
pg_class与pg_stats验证分析前后的统计变化
ANALYZE 到底刷新什么
对普通表执行 ANALYZE 时,PostgreSQL 会读取样本行,计算空值比例、不同值数量、最常见值、直方图等列统计,并更新规划器使用的目录信息。pg_stats 提供对列统计的可读视图,pg_class.reltuples 和 relpages 则保存表规模的估算值。
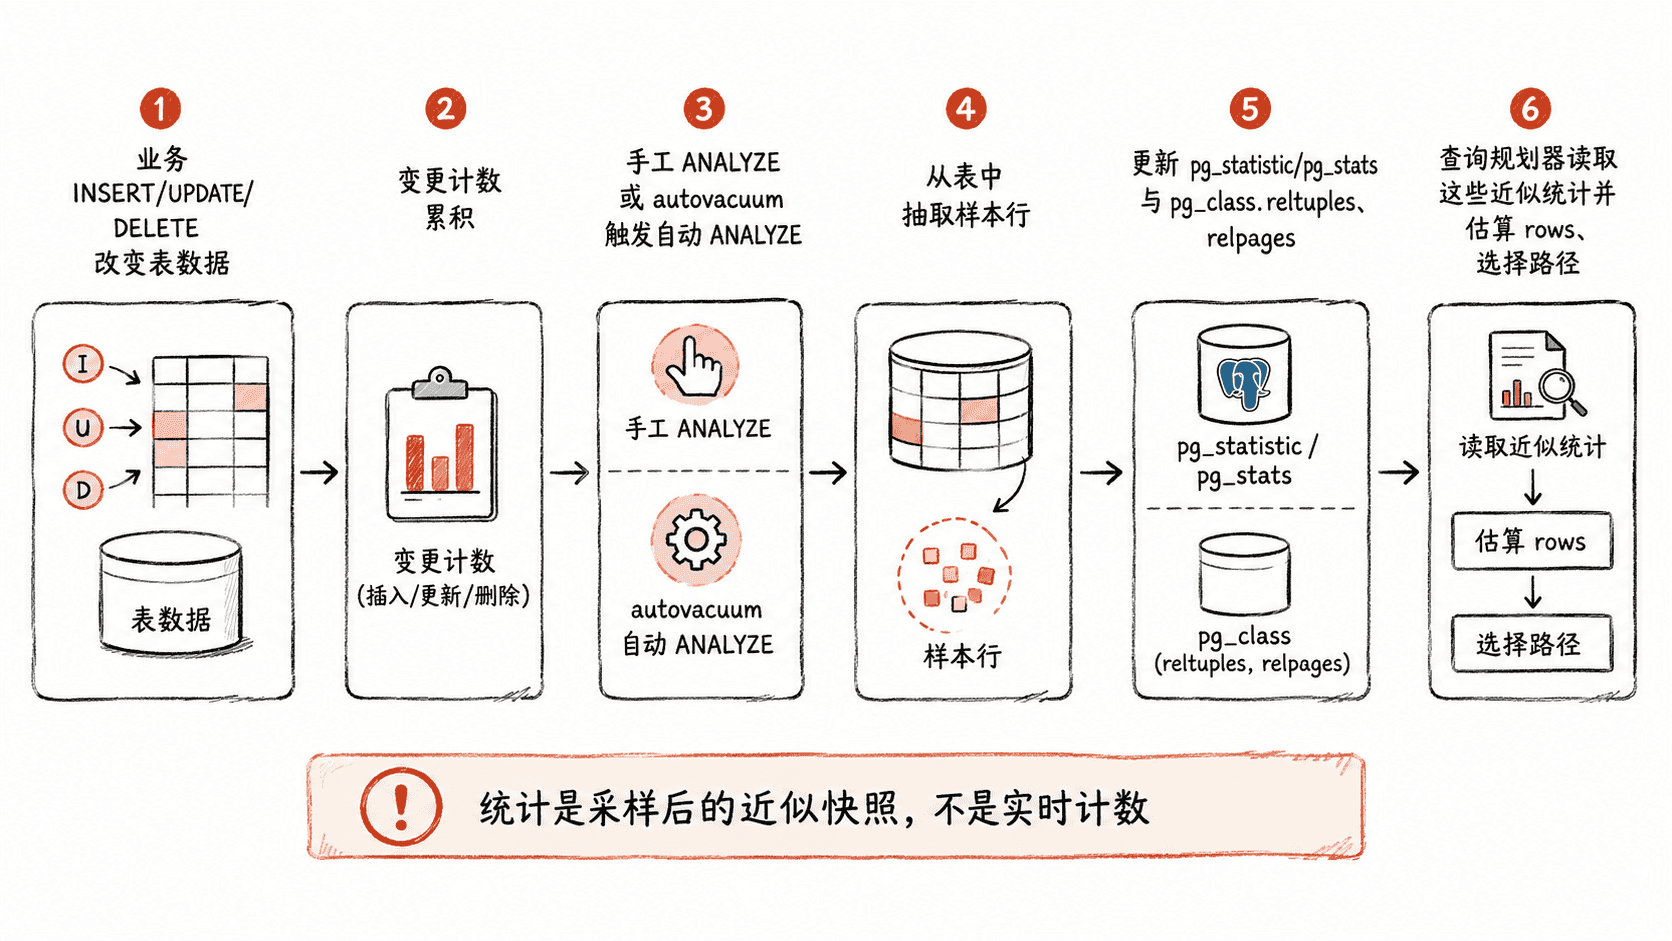
统计目录不会在每次 DML 后同步重算。自动分析会依据累计变更量和表规模决定何时运行,因此数据已经变化而统计尚未刷新,是正常的中间状态。
采样为什么天然是近似值
大表如果每次分析都全表扫描,维护成本会很高,所以 ANALYZE 会按统计目标选择样本规模。default_statistics_target 决定默认统计精度,每列也可以通过 ALTER TABLE ... ALTER COLUMN ... SET STATISTICS 单独提高或降低目标。
统计目标越高,最常见值列表和直方图通常越细,采样成本与统计目录体积也会上升。对于高基数、强偏斜或关键过滤列,提高目标可能改善估算;对于本来分布简单的列,盲目提高目标通常只会增加分析成本。
用实验观察统计滞后
下面的临时表规模较小,便于直接观察 reltuples 在 ANALYZE 前后如何变化。第二次插入 9000 行后故意不立即分析,因此表中已经有 19000 行,但目录中的行数估算仍保持旧值。
CREATE TEMP TABLE analyze_lab (
    id integer,
    category text
);

ALTER TABLE analyze_lab
ALTER COLUMN category SET STATISTICS 1000;

INSERT INTO analyze_lab
SELECT g,
       CASE WHEN g <= 9000 THEN 'hot' ELSE 'cold' END
FROM generate_series(1, 10000) AS g;

ANALYZE analyze_lab;

SELECT reltuples::bigint AS estimated_rows
FROM pg_class
WHERE oid = 'analyze_lab'::regclass;

INSERT INTO analyze_lab
SELECT g, 'cold'
FROM generate_series(10001, 19000) AS g;

SELECT reltuples::bigint AS estimated_rows
FROM pg_class
WHERE oid = 'analyze_lab'::regclass;

ANALYZE analyze_lab;

SELECT reltuples::bigint AS estimated_rows,
       (
           SELECT n_distinct
           FROM pg_stats
           WHERE schemaname LIKE 'pg_temp_%'
             AND tablename = 'analyze_lab'
             AND attname = 'category'
       ) AS category_distinct
FROM pg_class
WHERE oid = 'analyze_lab'::regclass;
预期结果
-- 第一次 ANALYZE 后
 estimated_rows
----------------
          10000

-- 又插入 9000 行但尚未 ANALYZE
 estimated_rows
----------------
          10000

-- 第二次 ANALYZE 后
 estimated_rows | category_distinct
----------------+------------------
19000 | 2这个实验说明两件事:reltuples 是维护时更新的估算,不是实时 count(*);列统计也只有在分析后才反映新的分布。生产环境的大表通常使用采样,因此即使刚执行过 ANALYZE,统计值也应理解为近似值。
什么时候应该主动刷新
常规业务表通常交给 autovacuum 的自动分析即可,但下面几类变化值得主动执行 ANALYZE:
- 批量导入、回填或大规模更新刚完成,接下来马上有依赖新分布的关键查询
- 某些列的分布发生剧烈变化,但总行数变化并不大
- 修改统计目标或创建扩展统计后,需要重新分析以生成对应统计
- 临时表会参与复杂连接或过滤;autovacuum 无法替会话中的临时表完成自动分析
ANALYZE 的目标不是得到实时精确计数,而是在可接受的维护成本下给规划器提供足够好的近似分布。治理重点应放在“估算是否足以支撑稳定计划”,而不是追求统计值与每一刻的数据完全一致。