
PostgreSQL / 系统课时
读懂直方图边界
读懂直方图边界
histogram_bounds 不是把数值范围机械地等宽切段,而是在排除高频值后,用若干边界把剩余可排序数据划成“每桶行数大致相近”的区间。理解这一点,才能正确解释范围条件为什么会得到某个选择性估算。
学习目标
- 解释
histogram_bounds的等深分桶含义 - 理解 MCV 与直方图为什么要分开统计
- 根据边界位置判断范围谓词的估算思路和常见误读
直方图不是等宽区间
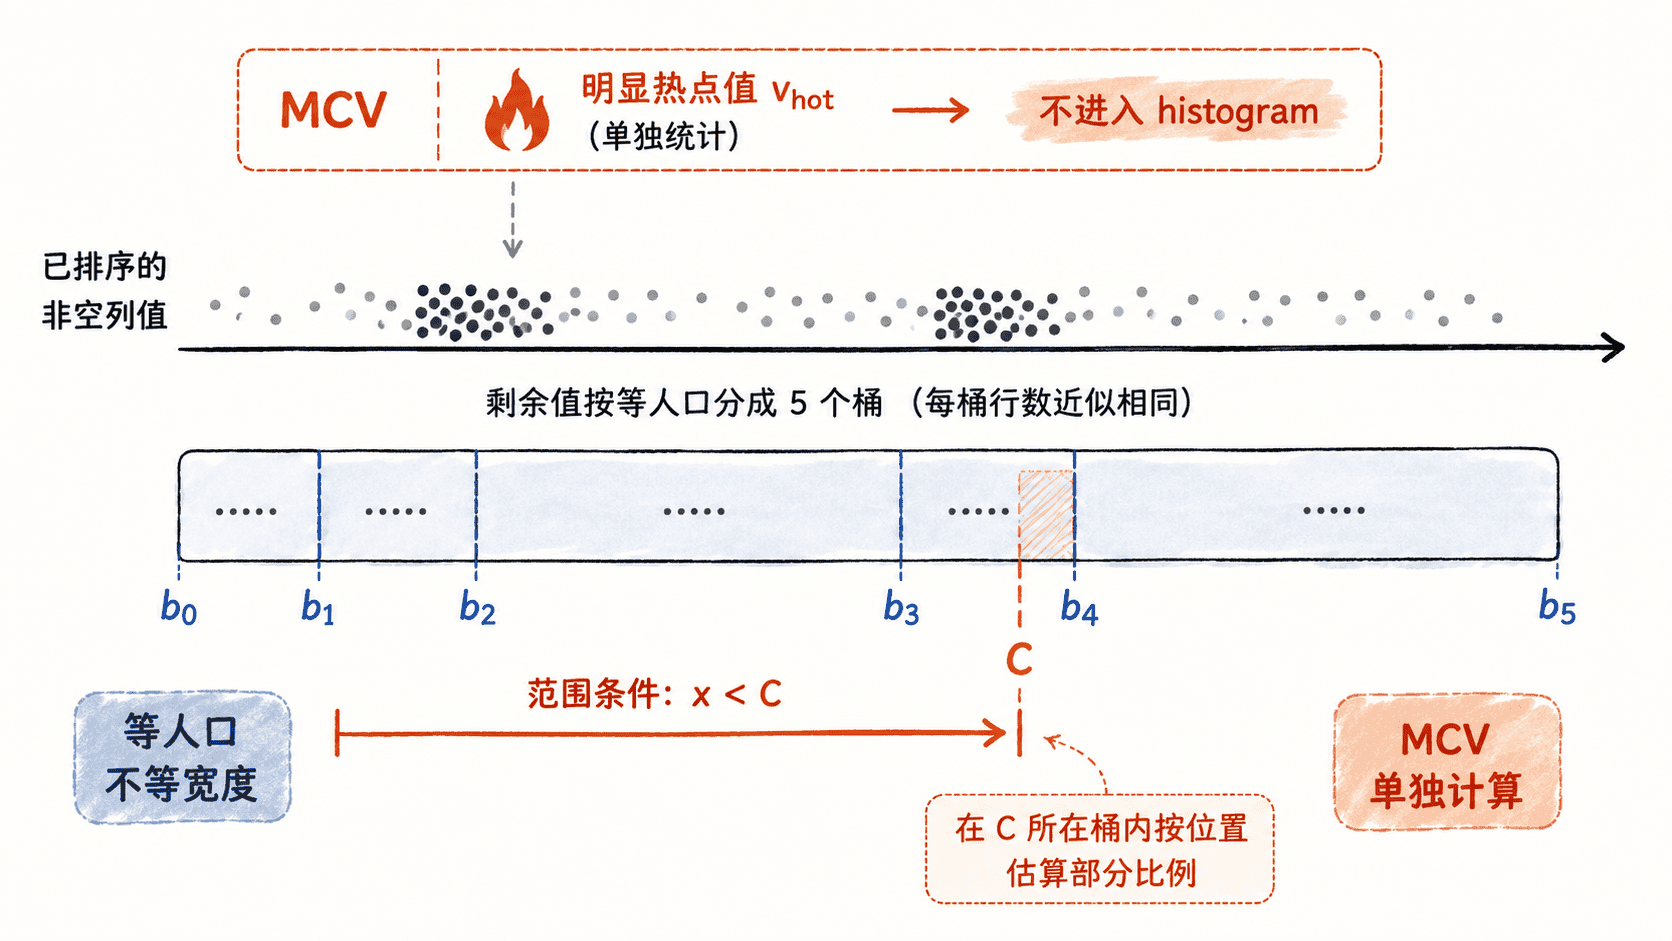
对于存在 < 排序语义的列,PostgreSQL 可以保存 histogram_bounds。这些边界先对剩余值排序,再把它们划成大致等人口的桶;如果某些值已经进入 most_common_vals,它们不会再参与直方图的构造。
因此,两个相邻边界的数值差可能完全不同。数据密集的区域需要更窄的数值区间才能容纳一桶,数据稀疏的区域则可能跨度很大。直方图表达的是累计数据量的位置,而不是固定数值宽度。
用唯一数值观察边界
下面构造 1 到 1000 的唯一整数。由于没有重复热点,MCV 通常为空,直方图可以集中表达整列的范围分布。把统计目标设为 10 后,可观察到大约 11 个边界值形成约 10 个桶。
CREATE TEMP TABLE histogram_lab AS
SELECT
    g AS id,
    g AS score
FROM generate_series(1, 1000) AS g;

ALTER TABLE histogram_lab
    ALTER COLUMN score SET STATISTICS 10;

ANALYZE histogram_lab;

SELECT
    n_distinct,
    most_common_vals,
    array_length(histogram_bounds, 1) AS bound_count,
    histogram_bounds
FROM pg_stats
WHERE schemaname LIKE 'pg_temp_%'
  AND tablename = 'histogram_lab'
  AND attname = 'score';

EXPLAIN
SELECT *
FROM histogram_lab
WHERE score BETWEEN 201 AND 400;
预期结果
n_distinct 接近 -1
most_common_vals 为 NULL
bound_count 通常为 11
histogram_bounds 从接近 1 延伸到接近 1000,相邻边界大致覆盖相近数量的行

Seq Scan on histogram_lab  (cost=<VALUE>..<VALUE> rows=<VALUE> width=<VALUE>)
  Filter: ((score >= 201) AND (score <= 400))
EXPLAIN 中的估算行数应接近实际的 200 行,但具体边界值和估算值允许因 PostgreSQL 版本、采样与舍入略有差异。这里要观察的是边界覆盖关系,而不是背诵某一组固定数组。
范围条件怎样使用边界
对 <、<=、>、>= 或 BETWEEN 这类范围条件,规划器会先判断常量落在直方图的哪个位置。常量之前完整覆盖的桶可以按整桶计入,常量所在桶再根据它在相邻边界中的位置估算一部分比例。
如果列还有 MCV,范围条件不能只看直方图。规划器还需要判断哪些高频值满足该范围,并把这些 MCV 频率与直方图所代表的剩余数据合并。也就是说,MCV 负责“离群热点”,直方图负责“其余可排序分布”。
这套方法依赖桶内分布近似,因此统计目标过低、数据分布剧烈变化或 ANALYZE 长期未更新时,范围估算可能偏离真实结果。发现 EXPLAIN 的估算行数与 EXPLAIN ANALYZE 的实际行数差距很大时,直方图是否足够细、统计是否新鲜,就是应优先检查的证据。
正确解读边界数组
不要把边界个数当成不同值个数。histogram_bounds 只是一组分位位置,真正的离散度仍看 n_distinct;一个桶里可以包含大量不同值。
不要假设相邻边界之间有相同数值跨度。等深直方图追求的是每桶数据量接近,而不是每桶宽度相等,所以偏斜分布恰恰会表现为宽窄不一。
当 histogram_bounds 为 NULL 时也不一定有异常:数据类型缺少可用的 < 排序操作,或 MCV 已经覆盖可统计的全部值时,都可能没有直方图。排查范围估算时,应把 histogram_bounds、MCV、n_distinct 与 null_frac 放在同一列统计上下文中阅读。