
PostgreSQL / 系统课时
比较扫描路径代价
比较扫描路径代价
同一条过滤查询既可能走顺序扫描,也可能走索引扫描或位图扫描。本节用选择性、表页数和 PostgreSQL 的代价参数拆解这次选择,并通过 EXPLAIN 观察“少量命中”和“大量命中”时访问路径为什么会切换。
学习目标
- 读懂扫描节点的
cost=startup..total,区分页读取成本与 CPU 成本 - 解释选择性、表规模、数据相关性和缓存假设如何改变扫描路径
- 用同一组数据验证 Index/Bitmap/Seq Scan 的切换,而不是只凭“有索引就该走索引”判断
扫描代价到底在比较什么
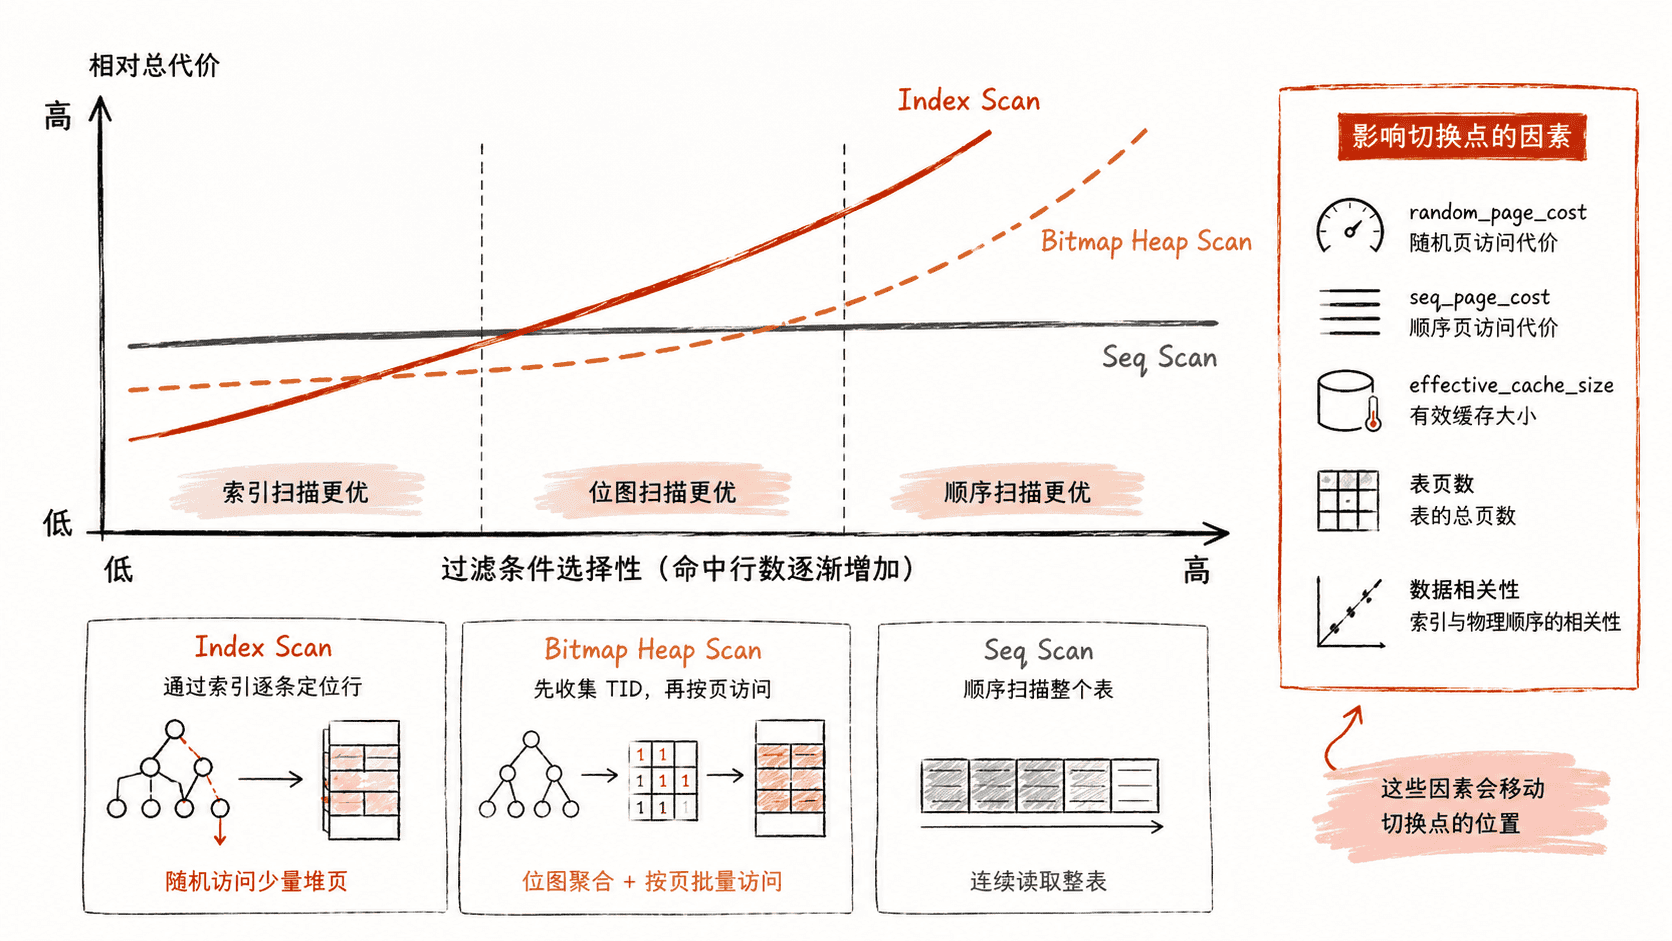
PostgreSQL 的 cost 不是毫秒,而是规划器内部用于比较候选路径的相对单位。简化理解,顺序扫描主要承担“读完整张表的页 + 检查每一行”的成本;索引扫描则承担“访问索引 + 定位命中元组 + 读取对应堆页”的成本。
对顺序扫描,可以把总成本近似看成:
索引扫描更依赖命中比例和堆页分布。命中行很少时,它避免读取大量无关页;命中行越来越多时,随机访问堆页的成本会迅速累积,顺序扫描反而更便宜。位图扫描位于两者之间:先从索引收集 TID,再按堆页批量访问,适合“命中不少,但还没多到值得全表扫”的区间。
seq_page_cost、random_page_cost、cpu_tuple_cost 等参数决定规划器如何给这些工作计价;effective_cache_size 则是缓存可用性的估计,不会真的为查询分配这么多内存。
用一组数据观察路径切换
下面建立 10 万行实验表,其中 category 只有 100 个不同值,并为它创建 B-tree 索引。先查看当前代价参数,再分别解释约 1% 命中与大范围命中的查询。
DROP TABLE IF EXISTS planner_scan_lab;

CREATE TABLE planner_scan_lab (
    id bigint PRIMARY KEY,
    category integer NOT NULL,
    payload text NOT NULL
);

INSERT INTO planner_scan_lab (id, category, payload)
SELECT g, g % 100, repeat('x', 80)
FROM generate_series(1, 100000) AS g;

CREATE INDEX planner_scan_lab_category_idx
ON planner_scan_lab (category);

ANALYZE planner_scan_lab;

SELECT name, setting
FROM pg_settings
WHERE name IN (
    'seq_page_cost',
    'random_page_cost',
    'cpu_tuple_cost',
    'effective_cache_size'
)
ORDER BY name;

EXPLAIN (COSTS ON)
SELECT *
FROM planner_scan_lab
WHERE category = 1;

EXPLAIN (COSTS ON)
SELECT *
FROM planner_scan_lab
WHERE category <= 80;
预期输出
name                 | setting
---------------------+----------
cpu_tuple_cost       | <VALUE>
effective_cache_size | <VALUE>
random_page_cost     | <VALUE>
seq_page_cost        | <VALUE>

-- category = 1:通常会看到 Index Scan 或 Bitmap Heap Scan
<INDEX_OR_BITMAP_SCAN_NODE> on planner_scan_lab  (cost=<START>..<TOTAL> rows=<ROWS> width=<WIDTH>)
<OPTIONAL_CHILD_NODES>

-- category <= 80:通常会看到 Seq Scan
Seq Scan on planner_scan_lab  (cost=<START>..<TOTAL> rows=<ROWS> width=<WIDTH>)
  Filter: (category <= 80)
实际 cost、估算行数以及稀疏查询究竟选择 Index Scan 还是 Bitmap Heap Scan,会受 PostgreSQL 版本、表物理布局、统计信息和当前参数影响;关键是比较同一环境中候选路径的相对总代价,而不是记住某个固定节点。
哪些条件会移动切换点
选择性是最直接的因素。条件越稀疏,索引越容易只触碰少量页;条件越宽,索引命中的堆页逐渐接近整表,顺序扫描优势上升。
表规模和相关性也很重要。小表即使有高选择性条件,全表扫描也可能便宜;如果索引键与堆表物理顺序高度相关,索引扫描访问堆页更接近顺序 I/O,其估算成本会下降。pg_stats.correlation 可以帮助解释这种现象。
I/O 与缓存假设决定随机页和顺序页的相对价格。SSD 或高缓存命中环境常会使用比机械盘时代更低的随机 I/O 成本,但参数必须基于实际工作负载校准。单纯把 random_page_cost 调低来“逼索引”,可能让大量查询同时偏向错误路径。
用代价而不是节点名称做判断
看到 Seq Scan 不等于查询有问题。对于高命中比例、窄表或缓存友好的工作负载,它往往就是最便宜的路径。反过来,看到 Index Scan 也不代表一定快:如果估算严重偏小,执行时可能产生大量随机堆页访问。
排查时应把 EXPLAIN 的估算行数、扫描节点总代价和实际数据选择性放在一起看;需要确认估算是否准确时再使用 EXPLAIN (ANALYZE, BUFFERS),并在可控环境执行。真正要治理的是“规划器为什么认为这条路更便宜”,而不是把某一种扫描节点当成目标答案。