
PostgreSQL / 系统课时
理解查询规划与执行边界
理解查询规划与执行边界
这节课解决一个基础但关键的问题:一条 SQL 从进入 PostgreSQL 到返回结果,哪些阶段只是在“理解与选择”,哪些阶段真正访问数据。掌握这条边界后,你才能正确解读 EXPLAIN,也能解释为什么相同 SQL 在不同条件下会拿到不同计划。
学习目标
- 区分解析、重写、规划与执行四个阶段的职责
- 理解
EXPLAIN与EXPLAIN ANALYZE分别跨到哪一层 - 说清同一 SQL 产生不同执行计划的常见原因
一条 SQL 经历了什么
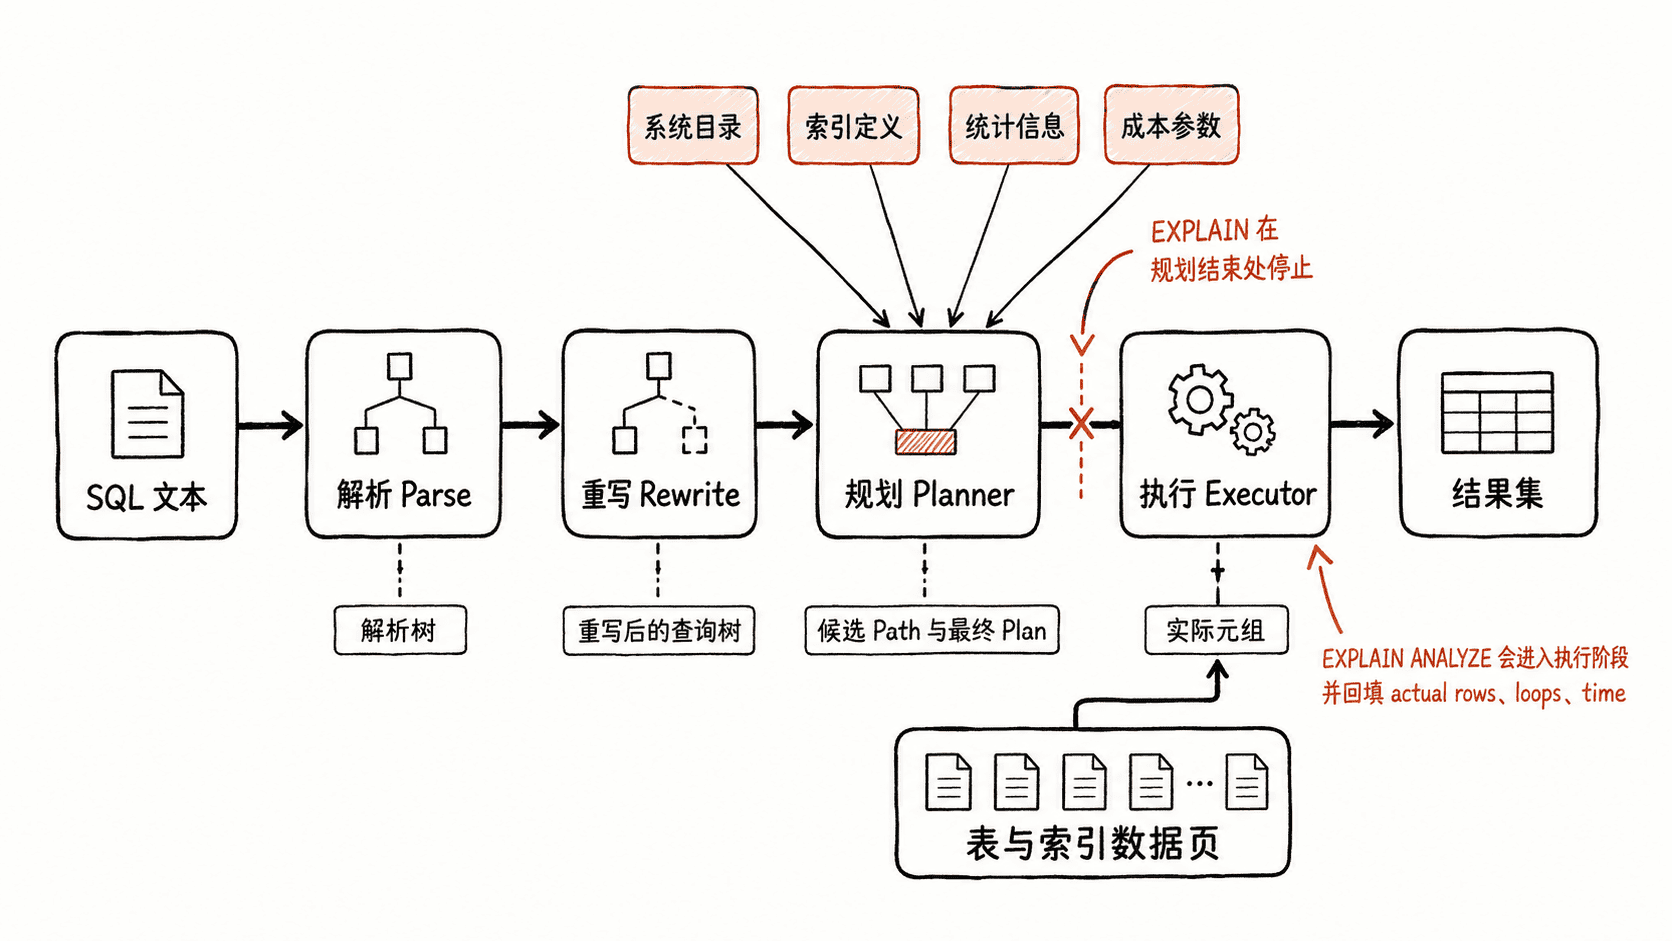
PostgreSQL 接收到 SQL 文本后,先由解析阶段完成语法和名称解析,形成内部语法树;随后重写阶段把视图、规则等转换为规划器真正处理的查询树。规划阶段并不读取业务结果集,而是基于表结构、索引、统计信息与成本参数枚举候选路径,选择预计成本最低的执行计划。
执行器拿到计划树后,才按节点真正取数据、连接、排序、聚合并返回结果。这里要特别区分“估算”和“实测”:规划器输出的是估算行数与估算成本,执行器才能产生实际行数、实际循环次数和真实执行耗时。
用 EXPLAIN 看清边界
下面两条语句查询内容相同,但第二条会真正执行计划。TIMING OFF 只是关闭逐节点计时,仍会执行 SQL。
EXPLAIN (COSTS OFF)
SELECT 1;

EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF)
SELECT 1;
预期输出
QUERY PLAN
Result

QUERY PLAN
Result (actual rows=1 loops=1)
Planning Time: <TIME> ms
Execution Time: <TIME> ms
实际时间会因版本和机器不同而变化。第一条只有计划节点,没有 actual rows;第二条出现实际行数和执行时间,说明它已经跨过规划与执行的边界。
为什么同一 SQL 的计划会变化
SQL 文本相同,并不意味着规划输入完全相同。只要规划器看到的条件发生变化,最优路径就可能变化。
常见原因包括统计信息更新后选择率估算改变、表数据量增长、索引新增或删除、成本参数和 enable_* 开关变化,以及预备语句在自定义计划与通用计划之间切换。参数值本身也可能让“返回极少行”和“返回大量行”成为两种完全不同的成本问题。
因此,比较两次计划时不能只盯 SQL 文本,还要同时记录统计信息是否新鲜、对象定义、关键参数与会话环境。后续做计划波动排查时,这些就是建立可比基线的最小证据集合。
读计划时先问哪一层
看到一个异常计划时,先判断问题属于哪一层:如果估算行数已经明显错误,优先检查统计信息与选择率估算;如果估算合理但实际耗时异常,再检查执行阶段的 I/O、缓存、并发等待和数据分布。
这条分界能避免一个常见误区:把执行器遇到的慢 I/O 当成“规划器选错”,或把严重的基数误估只当成“机器太慢”。规划阶段负责做选择,执行阶段负责兑现这个选择;排查时必须分别取证。