
PostgreSQL / 系统课时
定位首个估算分叉点
定位首个估算分叉点
一份执行计划里,根节点出现巨大估算误差并不等于根因就在根节点。更有效的做法是从计划树底部向上逐层比较 estimated rows 与 actual rows,找到第一个由“基本准确”突然变成“数量级偏差”的节点,再针对该节点检查统计或选择性模型。
学习目标
- 能统一读取计划节点的估算行数与实际行数
- 能从叶子节点向根节点定位第一个显著估算分叉点
- 能区分“本节点产生的误差”和“从子节点继承的误差”
先固定比较口径
在文本计划中,计划阶段的 rows 表示该节点预计输出多少行,执行阶段的 actual rows 表示每次循环实际输出多少行。节点执行多次时,还要结合 loops 理解总工作量;定位基数误差时,先比较同一节点的单次 rows 与单次 actual rows,不要把不同层级的数字混在一起。
判断“是否值得追”不要只看差几行。10 行估成 20 行通常影响有限,100 行估成 10000 行则可能让 Join 顺序、Join 算法和扫描方式全部改变。实践中可以把“相差约 10 倍以上”作为优先调查信号,但它只是排查阈值,不是 PostgreSQL 的硬规则。
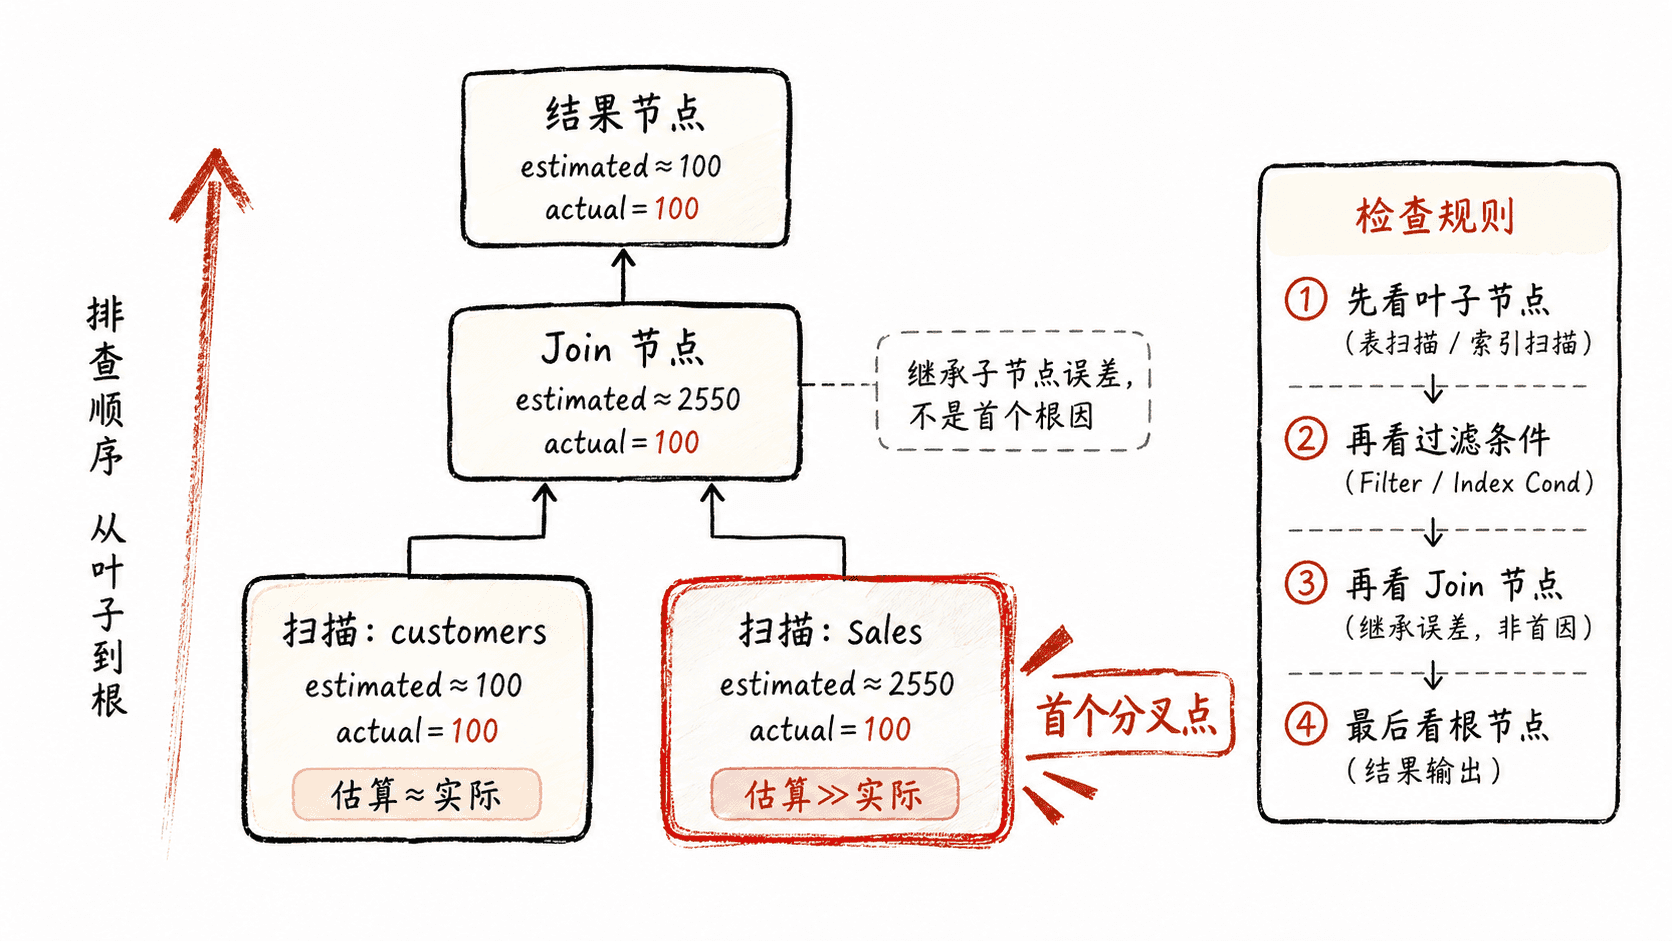
构造一个相关性导致的分叉
下面的数据故意让 channel 与 device 强相关。单列看,web 约占一半、pos 也约占一半;但两者同时出现只有 100 行。如果只有单列统计,优化器可能按近似独立关系估算二者交集,从而把 100 行高估到约 2500 行。
DROP STATISTICS IF EXISTS estimate_sales_channel_device_mcv;
DROP TABLE IF EXISTS estimate_sales;
DROP TABLE IF EXISTS estimate_customers;

CREATE TABLE estimate_customers (
    id integer PRIMARY KEY
);

CREATE TABLE estimate_sales (
    id integer PRIMARY KEY,
    customer_id integer NOT NULL,
    channel text NOT NULL,
    device text NOT NULL
);

INSERT INTO estimate_customers
SELECT id
FROM generate_series(1, 1000) AS g(id);

INSERT INTO estimate_sales
SELECT id,
       ((id - 1) % 1000) + 1,
       CASE WHEN id <= 5000 OR id > 9900 THEN 'web' ELSE 'store' END,
       CASE WHEN id <= 5000 THEN 'desktop' ELSE 'pos' END
FROM generate_series(1, 10000) AS g(id);

ANALYZE estimate_customers;
ANALYZE estimate_sales;

SELECT
    count(*) FILTER (WHERE channel = 'web') AS web_rows,
    count(*) FILTER (WHERE device = 'pos') AS pos_rows,
    count(*) FILTER (
        WHERE channel = 'web' AND device = 'pos'
    ) AS both_rows
FROM estimate_sales;
预期结果
 web_rows | pos_rows | both_rows
----------+----------+----------
     5100 |     5000 |      100
真实交集只有 100 行,而按两个单列选择性粗略相乘,10000 × 0.51 × 0.50 约为 2550 行。这正是适合用来练习“首个分叉点”的场景。
从叶子向上找第一处数量级偏差
执行带连接的查询,让过滤误差继续向上影响 Join。阅读计划时不要从最上面开始猜,而是先看两个最底层输入节点。
EXPLAIN (ANALYZE, VERBOSE, TIMING OFF, SUMMARY OFF)
SELECT s.id, c.id
FROM estimate_sales AS s
JOIN estimate_customers AS c
  ON c.id = s.customer_id
WHERE s.channel = 'web'
  AND s.device = 'pos';
预期输出
<JOIN_NODE>  (... rows=<EST_JOIN_ROWS> ...)
  (actual rows=100 loops=1)
  ...
  ->  <SALES_SCAN>  (... rows=<EST_AROUND_2550> ...)
        (actual rows=100 loops=1)
        Filter: ((channel = 'web'::text) AND (device = 'pos'::text))
  ->  <CUSTOMER_SCAN>  (... rows=<EST_AROUND_1000> ...)
        (actual rows=1000 loops=1)
具体 Join 与 Scan 类型可能变化,但判断路径不变:客户扫描估算与实际大致一致;销售表过滤节点从约 2500 行突然掉到实际 100 行,因此它是首个估算分叉点。上层 Join 即使也出现约 25 倍偏差,首先应视为继承了错误输入,而不是先去怀疑 Hash Join 或 Nested Loop 本身。
如果叶子扫描都准确、到了 Join 才首次偏离,再转向检查连接键 NDV、热点值、NULL、唯一性和两侧 MCV。这样可以把“过滤选择性问题”和“连接选择性问题”分开,不会在错误层级上调参数。
用扩展统计验证根因判断
本例的根因是同一张表中 channel 与 device 的组合分布不能由两个独立单列统计准确表达。创建多列 MCV 扩展统计后重新 ANALYZE,再看同一个过滤节点是否明显靠近 100 行。
CREATE STATISTICS estimate_sales_channel_device_mcv (mcv)
ON channel, device
FROM estimate_sales;

ANALYZE estimate_sales;

EXPLAIN (ANALYZE, VERBOSE, TIMING OFF, SUMMARY OFF)
SELECT s.id, c.id
FROM estimate_sales AS s
JOIN estimate_customers AS c
  ON c.id = s.customer_id
WHERE s.channel = 'web'
  AND s.device = 'pos';
预期结果
<JOIN_NODE>  (... rows=<EST_JOIN_ROWS_AFTER_STATS> ...)
  (actual rows=100 loops=1)
  ...
  ->  <SALES_SCAN>  (... rows=<EST_FILTER_ROWS_AFTER_STATS> ...)
(actual rows=100 loops=1)扩展统计建好后,<EST_FILTER_ROWS_AFTER_STATS> 应比原来的约 2550 明显接近 100,具体数字受 PostgreSQL 版本和统计采样影响。若首个分叉点被修正,上层节点的估算通常也会同步改善,这就是对根因判断最有力的验证。
定位计划误差时,核心不是找“偏差最大的节点”,而是找“最早开始偏的节点”。一旦把首个分叉点钉住,后续调查范围通常会从整棵计划树缩小到一个过滤条件、一组列统计或一个连接关系。