
PostgreSQL / 系统课时
分析组合条件估算
分析组合条件估算
这篇解决多个 WHERE 条件一起出现时,优化器为什么可能系统性低估或高估结果集。核心不是某一个条件统计错了,而是多个列之间存在相关性,而基础估算通常需要假设它们彼此独立。
学习目标
- 理解组合条件下的独立性假设与选择率相乘思路
- 能用真实数据区分“单列统计正确”和“组合估算错误”
- 能识别列相关造成的系统性低估或高估,并知道何时使用扩展统计信息
独立性假设如何产生偏差
假设条件 的选择率为 ,条件 的选择率为 。在近似独立的情况下,两个条件同时成立的概率可以估算为 。问题在于业务列经常不是独立的,例如 country 与 currency、tenant_id 与分区键,甚至两列本身就是同一业务属性的不同表示。
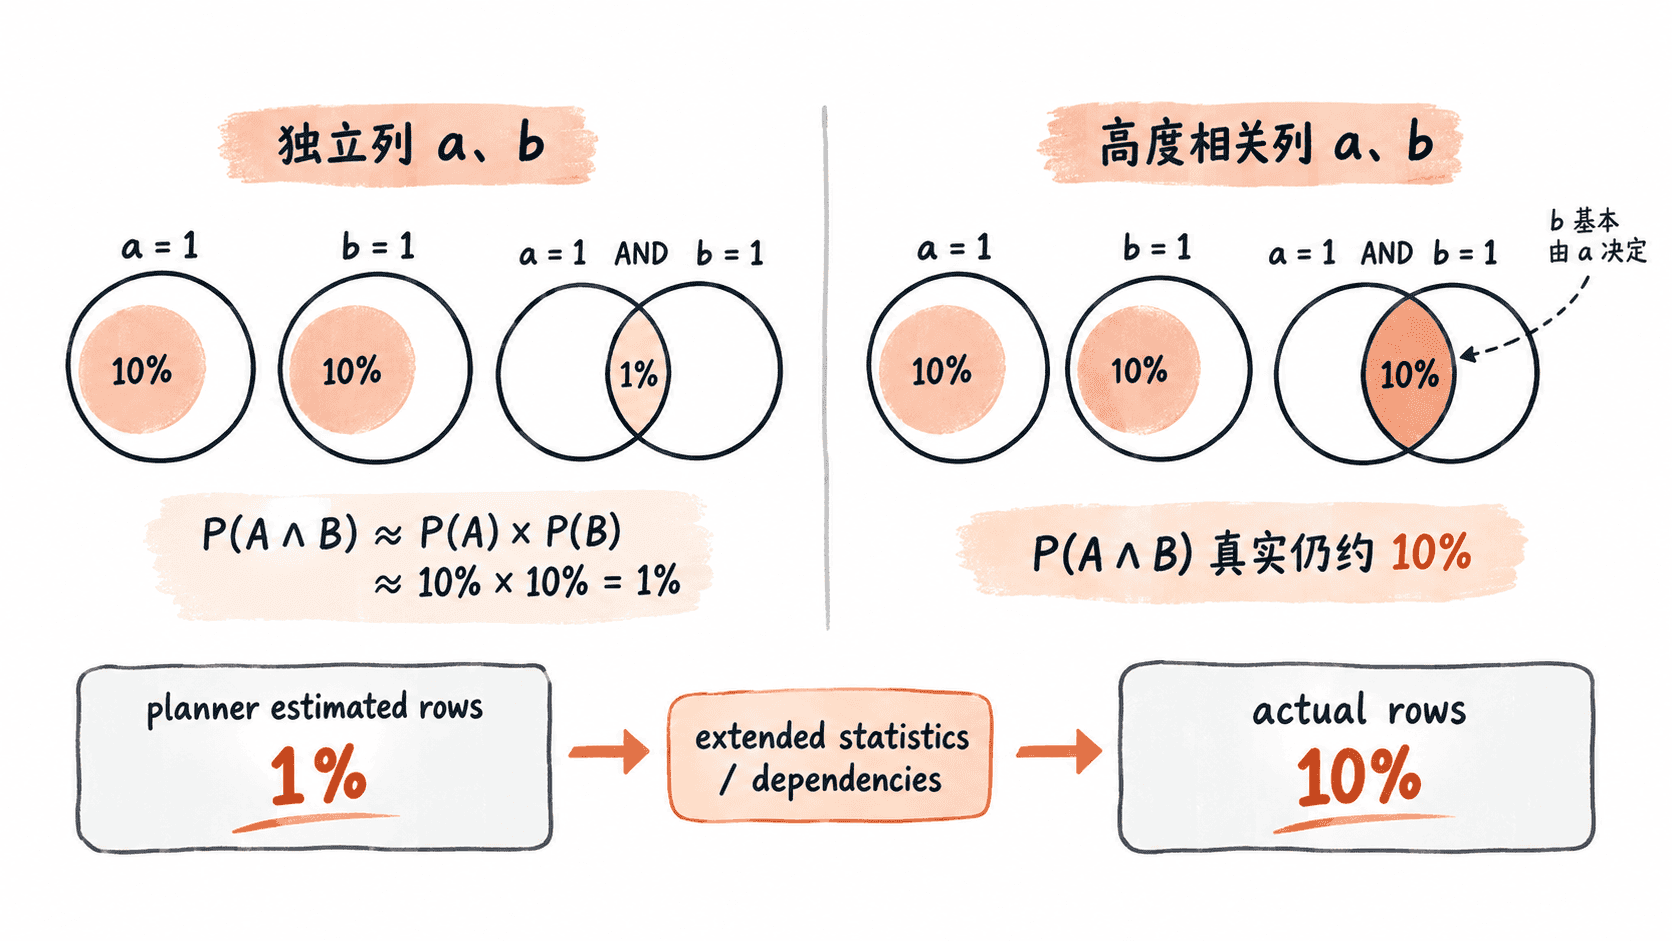
当两个列高度相关时,单列统计本身可能都没有问题:优化器知道 a = 1 大约命中 10%,也知道 b = 1 大约命中 10%。但如果直接按独立性相乘,就会得到大约 1% 的组合选择率,而真实交集仍可能接近 10%。这类偏差会进一步影响连接顺序、Join 算法、排序与聚合成本。
用确定性数据复现低估
下面创建两列完全同步的数据:a 与 b 都由同一个取模结果生成,因此每个值都各占约 10%,但两列高度相关。示例只负责复现估算现象,执行环境中的具体成本数字可能不同。
DROP TABLE IF EXISTS correlated_columns_demo;

CREATE TABLE correlated_columns_demo AS
SELECT
    g AS id,
    g % 10 AS a,
    g % 10 AS b
FROM generate_series(1, 100000) AS s(g);

CREATE INDEX correlated_columns_demo_a_idx
    ON correlated_columns_demo (a);

CREATE INDEX correlated_columns_demo_b_idx
    ON correlated_columns_demo (b);

ANALYZE correlated_columns_demo;

SELECT count(*) AS actual_rows
FROM correlated_columns_demo
WHERE a = 1
  AND b = 1;

EXPLAIN (COSTS OFF)
SELECT *
FROM correlated_columns_demo
WHERE a = 1
  AND b = 1;
预期结果:
actual_rows
-----------
10000
EXPLAIN 中的估算行数通常会明显低于 10000,因为基础组合选择率容易把两个约 10% 的条件近似成约 1%。具体计划节点和估算数字取决于 PostgreSQL 版本、统计采样及其他代价参数,因此不要把某个固定成本值当作正确答案。
什么时候会高估
列相关不只会导致低估。若两个条件在数据中具有互斥或负相关关系,简单独立性假设也可能高估交集。例如某状态列与另一业务分类列在实际数据中几乎不会同时取某些值,但优化器仍根据各自边际分布计算交集,就可能认为存在比真实更多的行。
因此排查组合条件时,最有价值的信号不是“估算错了一次”,而是同一类 SQL 在多个参数下持续出现相似方向的偏差。持续低估通常会让优化器倾向选择看起来便宜但实际输出很大的路径;持续高估则可能促使它提前采用不适合真实小结果集的计划。
用扩展统计信息表达列关系
当查询经常依赖多个相关列时,可以为这些列建立扩展统计信息,帮助优化器学习普通单列统计之外的关系。最常见的方向包括 dependencies、ndistinct 和 mcv,分别适合不同类型的多列分布特征。
CREATE STATISTICS correlated_columns_demo_stats
    (dependencies, ndistinct, mcv)
ON a, b
FROM correlated_columns_demo;

ANALYZE correlated_columns_demo;

EXPLAIN (COSTS OFF)
SELECT *
FROM correlated_columns_demo
WHERE a = 1
  AND b = 1;
预期结果:
估算行数应明显向真实结果 10000 靠近,
相较建立扩展统计信息前,组合条件的低估通常会显著减轻。这里不能要求优化器输出某个固定行数,因为扩展统计信息是在采样基础上生成的,实际估算仍会受数据、统计目标和版本实现影响。正确的验证方式是比较创建统计信息前后估算值与真实值的距离。
排查组合估算的顺序
先分别检查每个条件的单列选择性,再确认多个列是否存在业务上的强依赖关系,最后把估算行数与真实结果进行对照。若偏差只在特定组合出现,而且方向稳定,就应优先考虑列相关性,而不是立即增加普通索引或调大成本参数。
组合条件估算的关键不是追求每条 SQL 都得到精确行数,而是让优化器掌握足够接近真实数据分布的信息。单列统计回答“每列各自长什么样”,扩展统计则帮助回答“这些列放在一起时会怎样”,两者解决的是不同层面的估算问题。