
PostgreSQL / 系统课时
排查计划回归并选择修复
排查计划回归并选择修复
计划回归不是“今天比昨天慢”这么简单,而是同一类查询在可比参数和数据条件下,执行计划或关键估算发生变化并导致性能退化。本课建立一条可回退的排查链:先固定回归事实,再找第一个计划分叉点,最后把统计、索引、SQL、配置修复绑定到证据。
学习目标
- 对齐回归前后的 SQL、参数、统计、索引、配置和执行计划
- 从第一个计划分叉节点判断最可能的变化来源
- 为统计、扩展统计、索引、SQL 与代价校准设置验证和回退点
先固定什么真的发生了变化
排查前先确保比较对象可比。相同 SQL 文本如果绑定参数不同、返回行数不同或数据量增长明显,计划变化可能是合理适配;真正要追的是“为什么在相近输入下,当前计划比已知良好基线差”。
至少保存两份证据:良好基线与当前现场。两边都记录代表性参数、EXPLAIN (ANALYZE, BUFFERS, SETTINGS)、相关表统计时间、索引定义与状态,以及影响规划的关键配置。对于有副作用的语句,不要直接在生产执行 EXPLAIN ANALYZE;应使用安全副本或能完整回滚的受控环境。
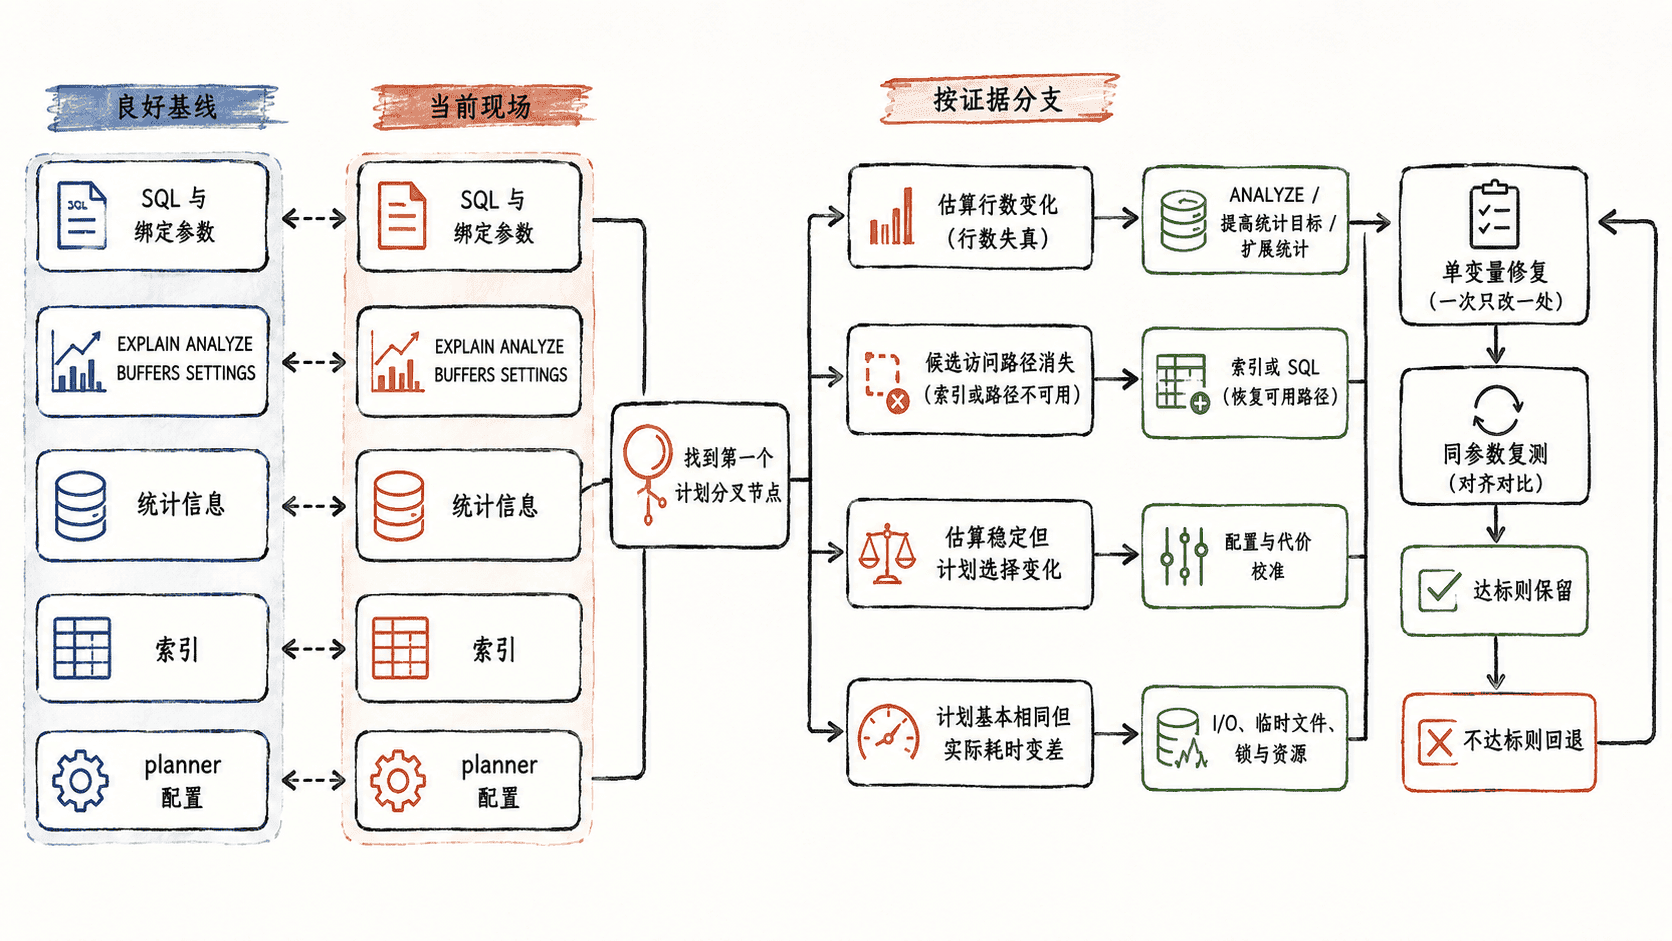
现场记录的价值在于让修复可证伪。没有基线时,任何一次 ANALYZE、加索引或改参数都可能“碰巧变快”,却无法说明根因,也无法判断下一次计划变化是否会再次回归。
从第一个计划分叉节点找原因
对比两棵计划树时,不要先盯总耗时,先找从根向下第一个明显不同的节点。这个位置通常最接近触发回归的决策点。
如果同一节点的估算行数先发生巨大变化,再带动 Nested Loop、Hash Join、扫描方式或连接顺序改变,优先调查统计信息和参数选择率。如果估算接近,但原先可用的索引路径消失,检查索引是否被删除、失效、谓词不再匹配,或 SQL 改写让表达式失去可索引性。
如果估算和索引都基本一致,却在配置变更后切换计划,重点比较 planner 相关 GUC 和硬件假设。反过来,如果计划几乎不变,只是 shared read、临时读写或等待时间增加,就不要把“执行环境变慢”误判成“计划回归”。
用相关列示例验证扩展统计修复
下面的实验构造两个高度相关的过滤列:region 与 zone 总是取相同编号。单列统计只能分别看到每个值约占 1%,规划器若把两个条件近似当作独立条件,组合选择率就可能被严重低估。
DROP TABLE IF EXISTS planner_regression_lab;

CREATE TABLE planner_regression_lab (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    region text NOT NULL,
    zone text NOT NULL,
    amount integer NOT NULL
);

INSERT INTO planner_regression_lab (region, zone, amount)
SELECT 'r' || (((g - 1) % 100) + 1)::text,
       'r' || (((g - 1) % 100) + 1)::text,
       (g % 1000)::integer
FROM generate_series(1, 100000) AS g;

ANALYZE planner_regression_lab;

EXPLAIN (ANALYZE, BUFFERS)
SELECT count(*)
FROM planner_regression_lab
WHERE region = 'r1'
  AND zone = 'r1';
预期输出(具体代价和时间会变化,重点看扫描节点的估算值明显低于实际 1000 行)
Aggregate  (cost=<VALUE> rows=1 width=8) (actual time=<TIME> rows=1 loops=1)
  ->  Seq Scan on planner_regression_lab
        (cost=<VALUE> rows=<ESTIMATED_NEAR_10> width=0)
        (actual time=<TIME> rows=1000 loops=1)
        Filter: ((region = 'r1'::text) AND (zone = 'r1'::text))
        Rows Removed by Filter: 99000
Planning Time: <TIME> ms
Execution Time: <TIME> ms
这类证据指向“跨列相关性没有进入估算”,适合先验证扩展统计,而不是改全局 cost 参数。对接近函数依赖的等值条件,可创建 dependencies 统计对象,再重新 ANALYZE。
CREATE STATISTICS planner_regression_dep (dependencies)
ON region, zone
FROM planner_regression_lab;

ANALYZE planner_regression_lab;

EXPLAIN (ANALYZE, BUFFERS)
SELECT count(*)
FROM planner_regression_lab
WHERE region = 'r1'
  AND zone = 'r1';
预期输出(扫描节点估算应明显接近实际 1000 行)
Aggregate  (cost=<VALUE> rows=1 width=8) (actual time=<TIME> rows=1 loops=1)
  ->  Seq Scan on planner_regression_lab
        (cost=<VALUE> rows=<ESTIMATED_NEAR_1000> width=0)
        (actual time=<TIME> rows=1000 loops=1)
        Filter: ((region = 'r1'::text) AND (zone = 'r1'::text))
Planning Time: <TIME> ms
Execution Time: <TIME> ms扩展统计不会创建索引,也不会强制某种连接算法;它修的是规划器对数据关系的认知。dependencies 适合函数依赖式相关,特定值组合导致的偏差可评估 MCV 统计,分组基数问题则可评估 ndistinct。
把修复动作绑定到证据
| 证据 | 优先修复 | 验收重点 |
|---|---|---|
| 大批数据变更后估算突然失真 | ANALYZE |
estimated rows 是否恢复到合理区间 |
| 单列分布复杂、采样不足 | 提高相关列统计目标后 ANALYZE |
高频值与范围选择率是否改善 |
| 多列明显相关 | CREATE STATISTICS 后 ANALYZE |
组合条件估算是否改善 |
| 缺少真正可用的访问路径 | 新增或调整索引、改写谓词 | 候选路径是否出现且整体代价下降 |
| SQL 改写导致过滤或连接放大 | 修 SQL | 中间结果行数和 loops 是否下降 |
| 估算可靠但代价排序长期不符实测 | 校准 cost 参数 | 代表性工作负载是否整体改善 |
| 计划基本不变但实际资源变差 | 修运行期资源或并发问题 | 读块、临时文件、等待是否恢复 |
不要一次同时刷新统计、加索引、改 SQL 和调参数。多变量一起变化时,即使性能恢复,也无法知道哪个动作真正有效,更无法制定可靠回退方案。
设置回退点并完成验收
每次只改一个因素,并在变更前保存基线计划、关键配置和对象定义。SQL 发布要能回退版本;新增索引要记录删除路径;新建扩展统计要记录对象名;代价参数要记录原值。ANALYZE 本身不应靠直接修改系统统计目录来“回滚”,如果新统计仍导致估算不稳,应调整统计目标或统计对象后重新采样。
修复后的验收必须使用与基线可比的参数集,而不是只挑一个最有利样本。至少确认三件事:关键节点估算误差缩小,计划变化与预期修复方向一致,执行时间和缓冲区读写在多次运行中稳定改善。
完成实验后可清理示例对象。
DROP TABLE planner_regression_lab;预期输出
DROP TABLE计划回归治理的核心不是“找一个更快的计划”,而是建立可重复的证据链:基线与现场对齐 → 找到第一个分叉点 → 单变量修复 → 同条件复测 → 不达标立即回退。这样统计、索引、SQL 和参数调整才是可控工程动作,而不是一次性的碰运气。