
PostgreSQL / 系统课时
读懂 loops 与实际行数
读懂 loops 与实际行数
EXPLAIN (ANALYZE) 里的 rows 和 loops 很容易被当成“总行数”和“重复次数”分开看,结果会低估嵌套循环的真实工作量。本课用一个可复现实验说明如何把单次指标还原成累计行数,并正确理解节点时间。
学习目标
- 解释
actual rows、loops与actual time在重复执行节点中的含义。 - 用
rows × loops估算节点的累计输出行数。 - 从 Nested Loop 的内层节点识别真实放大倍数,而不误加整棵计划树的时间。
先把单次指标和累计工作量分开
当某个计划节点显示 loops=1 时,actual rows 基本可以直接理解为该节点本次执行输出的行数。真正容易误读的是 loops>1:PostgreSQL 在文本计划里把 actual rows 和 actual time 按每次执行取平均后展示,因此它们不是整个查询生命周期内的累计值。
例如一个内层节点显示 actual rows=2 loops=3,含义是它平均每次返回 2 行,一共被启动 3 次。累计输出约为 6 行。若不同循环实际返回行数不完全一致,文本格式中的平均值还可能经过取整,因此乘积应视为用于定位放大效应的近似量。
actual time=a..b 也按每次执行平均展示:a 是从启动到产生第一行的平均时间,b 是从启动到完成该节点的平均时间。可以用 b × loops 估算这个节点累计经历的时间,但节点时间包含其子节点工作,不能把整棵树所有节点的时间再相加。
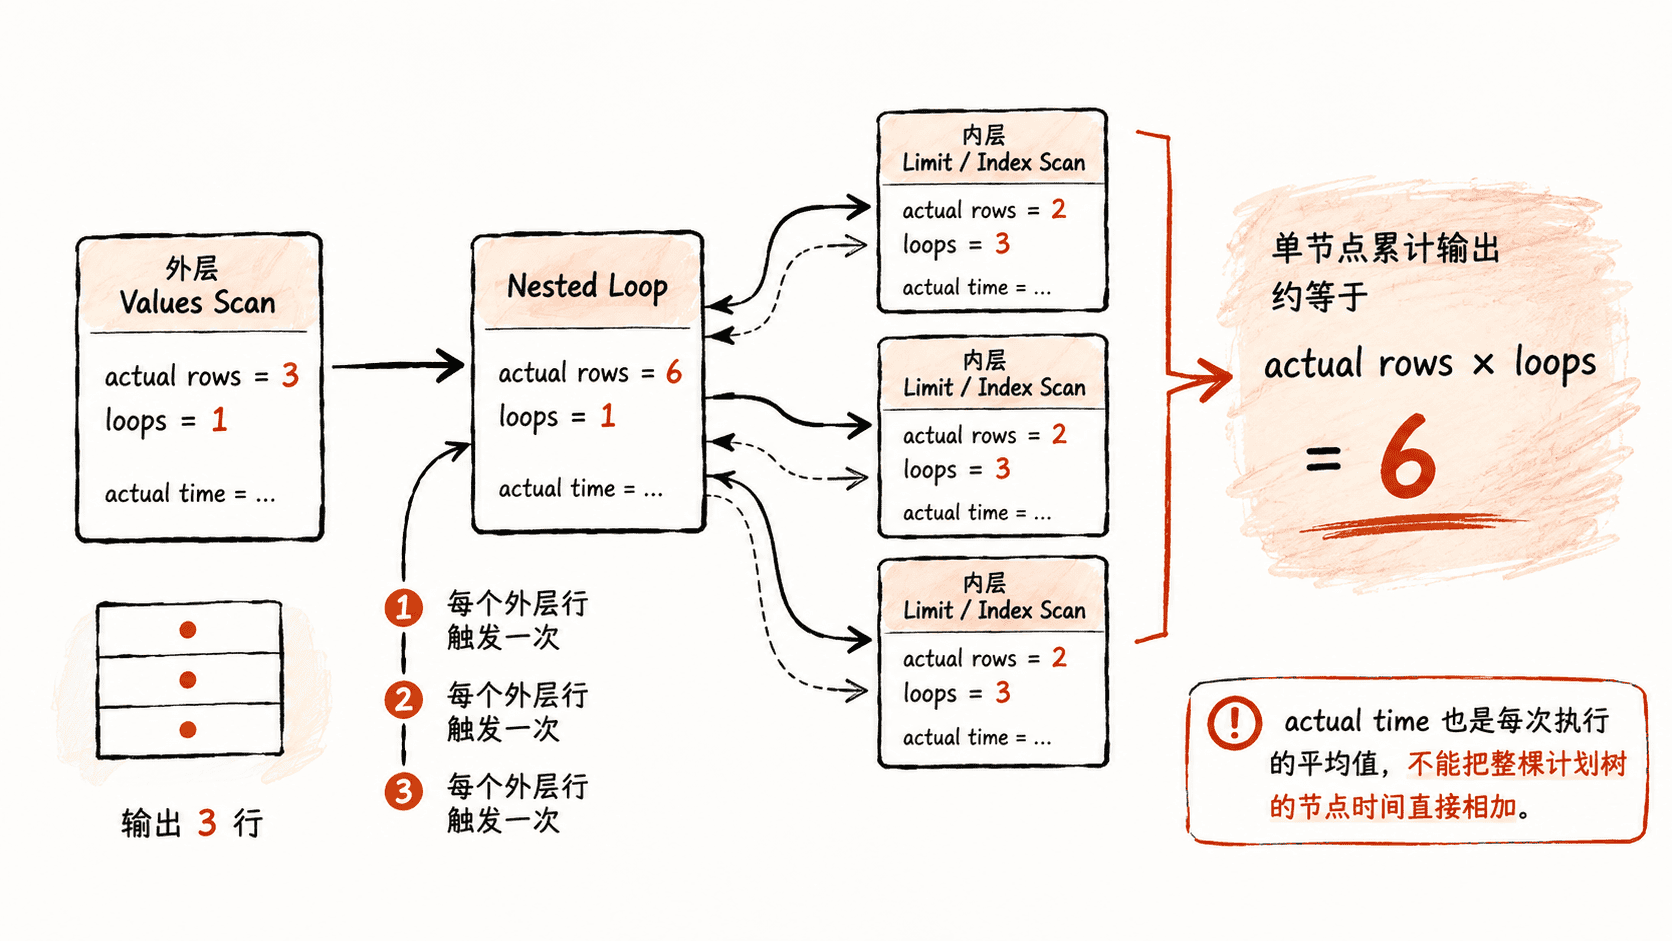
用可重复实验观察 loops
下面在临时表中放入 3 组数据,并通过相关 LATERAL 子查询让内层索引扫描对每个外层值执行一次。关闭其他连接方法只是为了稳定演示计划形态,不代表生产环境应该长期这样设置。
BEGIN;

CREATE TEMP TABLE loop_child (
    parent_id integer NOT NULL,
    payload text NOT NULL
);

CREATE INDEX loop_child_parent_id_idx
    ON loop_child (parent_id);

INSERT INTO loop_child (parent_id, payload) VALUES
    (1, 'a'), (1, 'b'),
    (2, 'c'), (2, 'd'),
    (3, 'e'), (3, 'f');

ANALYZE loop_child;

SET LOCAL enable_hashjoin = off;
SET LOCAL enable_mergejoin = off;
SET LOCAL enable_seqscan = off;
SET LOCAL enable_bitmapscan = off;
SET LOCAL jit = off;

EXPLAIN (ANALYZE, COSTS OFF, SUMMARY OFF)
SELECT p.id, c.payload
FROM (VALUES (1), (2), (3)) AS p(id)
CROSS JOIN LATERAL (
    SELECT payload
    FROM loop_child
    WHERE parent_id = p.id
    LIMIT 10
) AS c;

ROLLBACK;
预期输出中,执行时间会因机器而异,但关键的行数与循环关系应呈现为下面的结构:
Nested Loop (actual time=<TIME>..<TIME> rows=6 loops=1)
  -> Values Scan on "*VALUES*" (actual time=<TIME>..<TIME> rows=3 loops=1)
  -> Limit (actual time=<TIME>..<TIME> rows=2 loops=3)
        -> Index Scan using loop_child_parent_id_idx on loop_child (actual time=<TIME>..<TIME> rows=2 loops=3)
              Index Cond: (parent_id = "*VALUES*".column1)
实际节点名称的细节可能随 PostgreSQL 版本略有差异,但这里应重点核对两件事:外层共有 3 行,内层节点因此执行 3 次;内层每次返回 2 行,所以父级 Nested Loop 最终输出 6 行。
用乘积判断真实放大倍数
读 Nested Loop 时,应优先沿着“外层输出多少行,内层因此执行多少次”这条链路计算。若内层索引扫描显示 rows=2 loops=3,累计输出约为 2 × 3 = 6;若线上计划变成 rows=1000 loops=500,则意味着该节点累计向上游产生约 50 万行,这通常比单看 rows=1000 更能解释 CPU、缓存访问和执行时间为什么突然放大。
loops 大本身不等于坏计划。典型的主键点查可能执行数千次,但每次只返回 1 行且代价很低。真正需要警惕的是“大 loops × 大 rows”,或者内层每次都做高成本扫描、排序、函数计算。
避免三种常见误读
首先,不要把内层的 rows 当作整条查询的总行数;只要 loops>1,就必须先考虑乘积。其次,不要把父节点和所有子节点的 actual time 逐项相加,因为父节点的时间已经覆盖了等待子节点产生数据的过程。最后,不要只盯着顶层返回行数:查询最终可能只返回几十行,但内部节点经过重复循环后已经处理了数十万行。
判断 Nested Loop 是否真的发生了放大,最可靠的读法是把每个重复执行节点的 actual rows 与 loops 放在一起看,再结合其访问方式判断“每次循环贵不贵”。这样才能把单次平均指标还原为查询真正做过的工作量。