
PostgreSQL / 系统课时
识别数据分布漂移
识别数据分布漂移
数据分布漂移不是“很久没 ANALYZE”的同义词。一次分析刚完成,后续批量写入、热点键迁移或业务周期切换仍可能让统计信息迅速失真。本课建立一套从变化量、列分布到计划估算误差的识别顺序。
学习目标
- 用表级变更量判断哪些对象最值得优先检查。
- 从
pg_stats识别热点值、基数和数据顺序的变化。 - 区分一次性批量变更、热点迁移与周期性波动,并选择合适的统计维护动作。
为什么只看最后分析时间会漏判
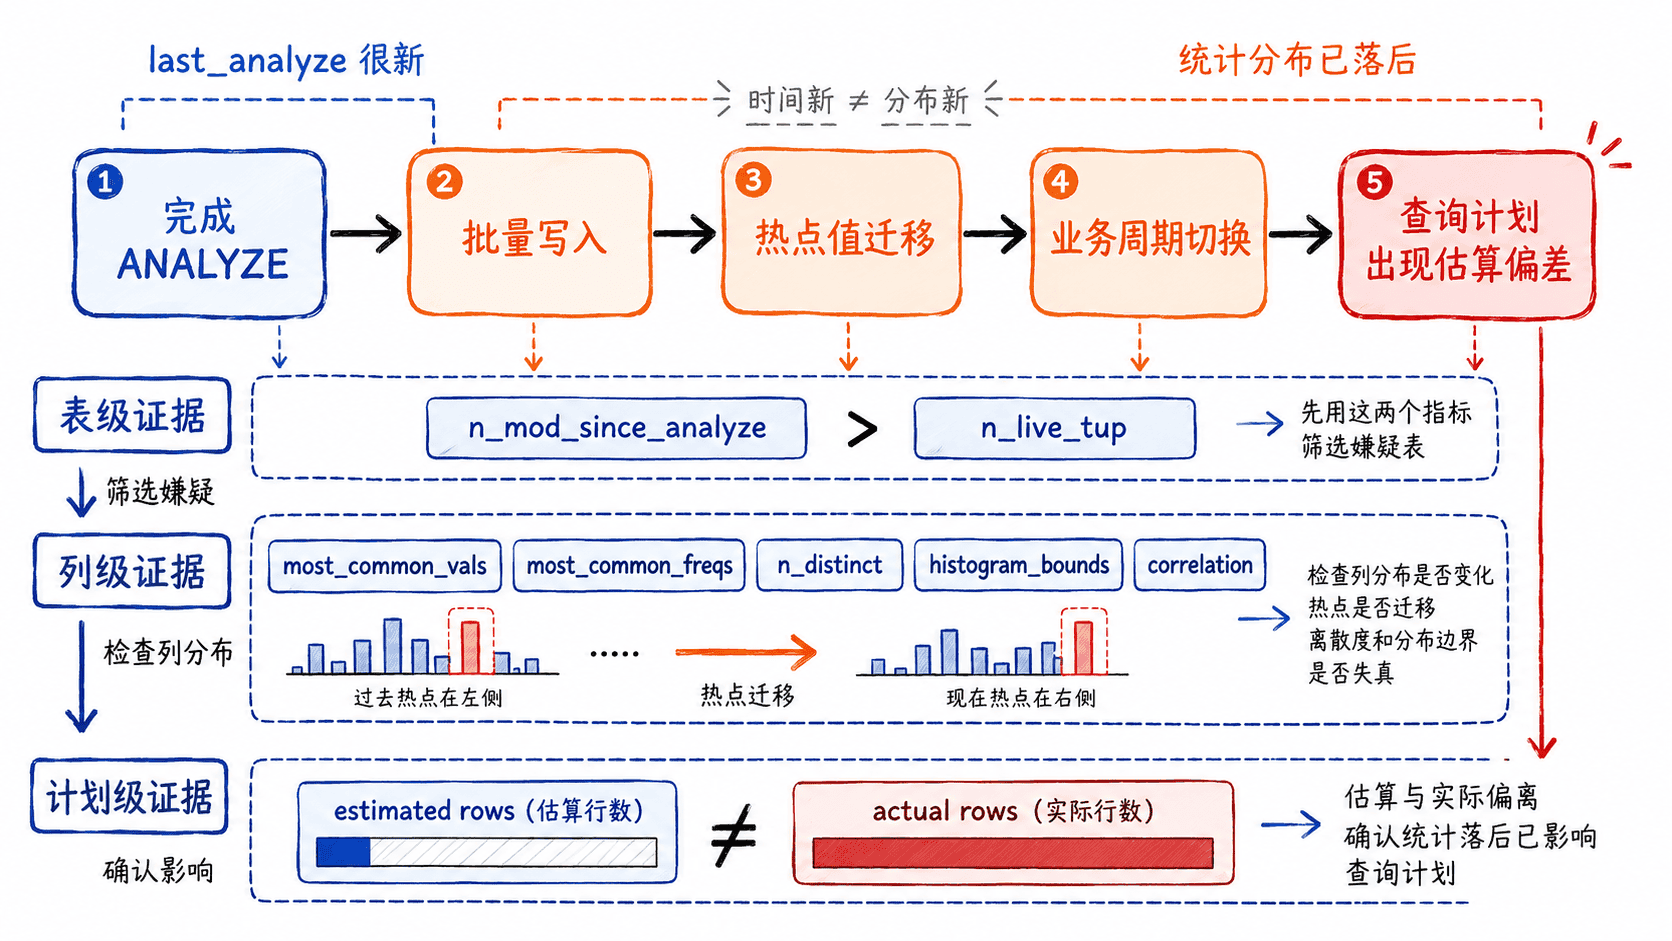
last_analyze 和 last_autoanalyze 只说明最近一次统计信息生成的时间,不能回答“生成后数据分布变了多少”。例如凌晨刚完成自动分析,上午促销把大量订单集中到一个状态或地区,时间戳仍然很新,但优化器看到的频率分布已经落后。
识别漂移要同时观察三层证据:表发生了多少变更、关键列的分布形状是否改变、真实执行时估算行数是否持续偏离实际行数。前两层用于筛选嫌疑对象,第三层用于确认它已经影响查询计划。
先找变化量异常的表
先做数据库级只读筛查。n_mod_since_analyze 是自上次分析以来修改行数的估计值,把它与 n_live_tup 对照,可以快速发现“小表改了一大半”和“大表改了很多行”这两类风险。
SELECT
    schemaname,
    relname,
    n_live_tup,
    n_mod_since_analyze,
    round(
        100.0 * n_mod_since_analyze / NULLIF(n_live_tup, 0),
        2
    ) AS modified_pct,
    last_analyze,
    last_autoanalyze
FROM pg_stat_user_tables
WHERE n_live_tup > 0
ORDER BY modified_pct DESC NULLS LAST,
         n_mod_since_analyze DESC
LIMIT 20;
预期输出
 schemaname | relname | n_live_tup | n_mod_since_analyze | modified_pct | last_analyze | last_autoanalyze
------------+---------+------------+---------------------+--------------+--------------+------------------
public | <TABLE> | <VALUE> | <VALUE> | <VALUE> | <TIME> | <TIME>实际表名、计数和时间会不同。modified_pct 只是排查排序指标,不是自动 ANALYZE 的精确触发比例;大表即使比例不高,绝对变更量也可能已经足以改变热点值或选择性。
再确认关键列的分布是否变了
对嫌疑表继续检查参与过滤、连接和分组的关键列。下面是只读检查模板,执行前把 public.orders 和列名替换为真实对象。
SELECT
    attname,
    n_distinct,
    most_common_vals,
    most_common_freqs,
    histogram_bounds,
    correlation
FROM pg_stats
WHERE schemaname = 'public'
  AND tablename = 'orders'
  AND attname IN ('status', 'region', 'customer_id')
ORDER BY attname;
预期输出
 attname     | n_distinct | most_common_vals | most_common_freqs | histogram_bounds | correlation
-------------+------------+------------------+-------------------+------------------+------------
 customer_id | <VALUE>    | <VALUE>          | <VALUE>           | <VALUE>          | <VALUE>
 region      | <VALUE>    | <VALUE>          | <VALUE>           | <VALUE>          | <VALUE>
 status      | <VALUE>    | <VALUE>          | <VALUE>           | <VALUE>          | <VALUE>
热点迁移最容易反映在 most_common_vals 与 most_common_freqs:热门值发生替换或频率明显改变,通常比单看总行数更能解释选择性变化。n_distinct 明显改变说明基数模型需要重新学习;histogram_bounds 的范围变化反映非热点值分布移动;correlation 大幅变化则可能影响索引扫描成本估计。
业务周期要和“同周期基线”比较。工作日与周末、日间与夜间本来就可能有不同热点,如果只拿相邻两个时点比较,很容易把正常周期误判为异常漂移。
用计划误差确认是否已经影响查询
当变化量和列统计都指向漂移时,再针对真实慢查询检查执行计划。重点不是节点名称有没有变化,而是过滤或连接节点的估算行数与实际行数是否长期出现数量级偏差;如果偏差集中在刚刚发生热点迁移的列上,证据链就闭合了。
对一次性大批量导入或批量更新,业务已知变更结束后可以主动执行 ANALYZE,不必等待自动阈值。对持续热点迁移,则应把关键列统计快照、变更速率和估算误差纳入监控。提高统计目标可以增加分布细节,但它不能解决“统计信息刷新得太晚”的问题。
识别分布漂移的核心不是追逐一个时间戳,而是回答三个问题:数据改了多少、分布形状怎么变、这种变化是否已经让优化器估错。只有三者结合,才能决定是立即分析、调整自动分析策略,还是把变化视为正常业务周期。