
PostgreSQL / 系统课时
设计关键表统计策略
设计关键表统计策略
本课解决“所有表都交给默认 ANALYZE”为什么经常不够,以及如何按表规模、变更比例和数据倾斜设计统计目标与维护窗口,让统计信息跟得上业务变化,又避免无意义的频繁分析。
学习目标
- 判断关键表什么时候适合依赖自动
ANALYZE,什么时候需要补充手动维护。 - 根据表规模、变更比例和列分布选择统计目标,而不是盲目提高全局配置。
- 为高变更表建立可执行的统计维护窗口和验证方法。
先判断默认自动 ANALYZE 是否够用
自动 ANALYZE 的触发依据包含固定阈值与表规模相关的比例。当前 PostgreSQL 的默认 autovacuum_analyze_threshold 为 50,autovacuum_analyze_scale_factor 为 0.1,因此小表和大表在相同业务变更量下得到的触发节奏并不一样。
这意味着“大表每天变很多行”与“小表偶尔改几百行”不能用同一维护策略。更重要的是,表总行数并不等于统计信息价值:一张只有几十万行但某个状态列高度倾斜、且每天集中写入热点值的表,可能比一张更大的均匀分布表更需要主动刷新统计。
用业务变化划分维护策略
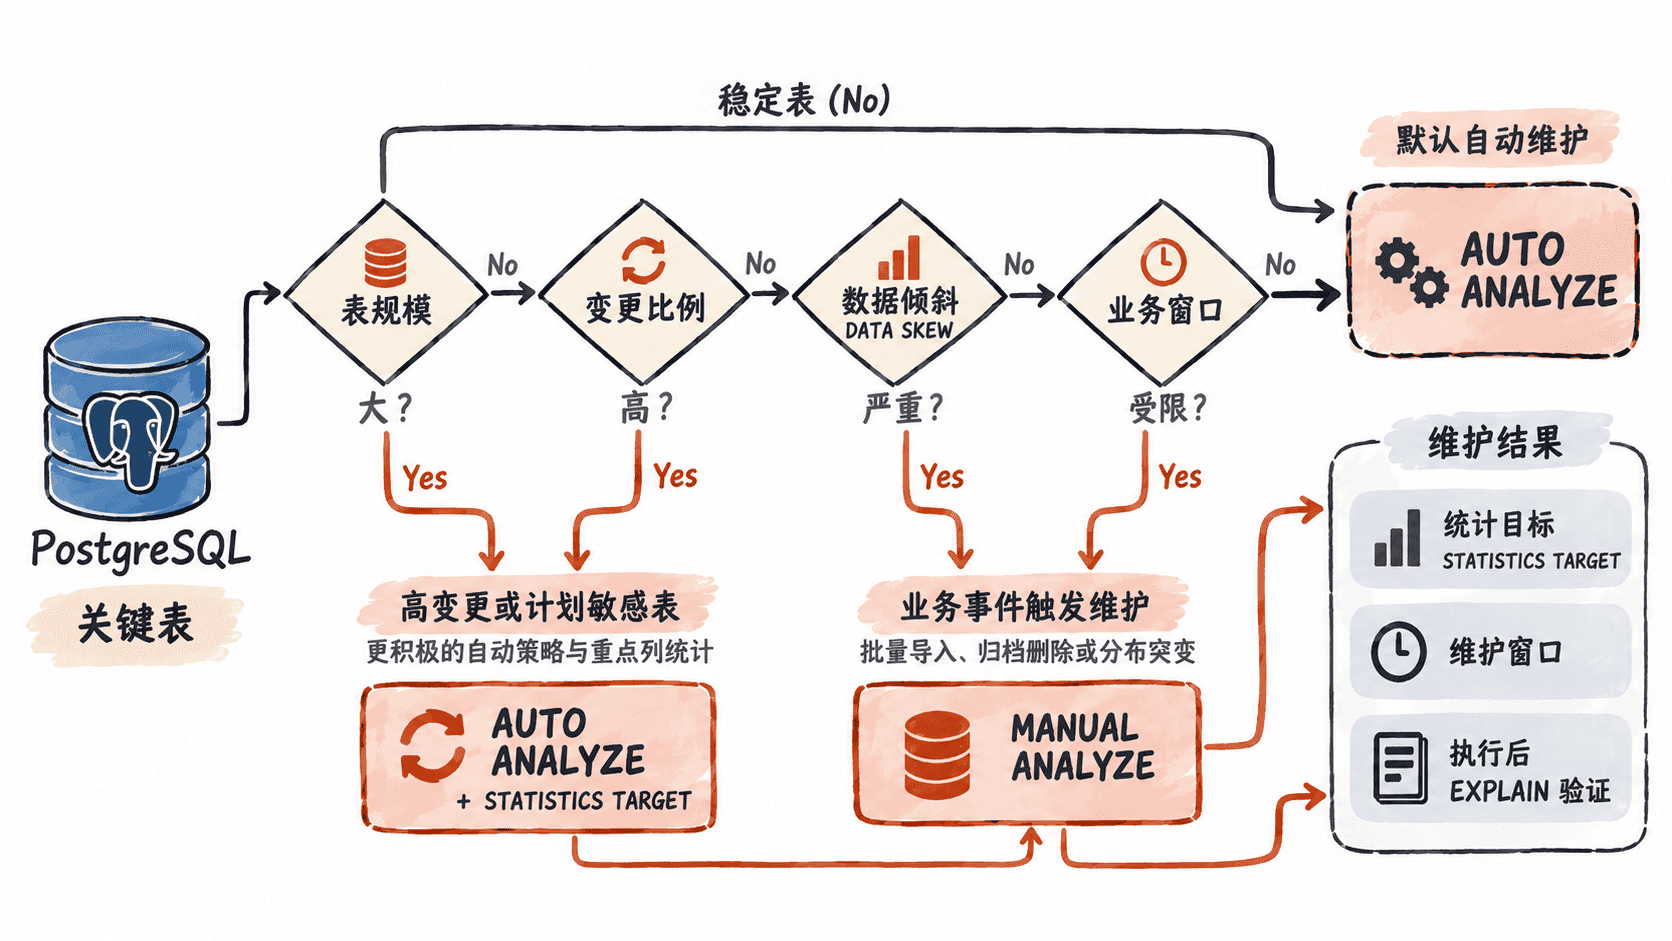
关键表可以先分成三类。变化平缓、数据分布稳定的表优先依赖自动 ANALYZE;高频写入且计划高度依赖准确选择率的表,需要缩短统计陈旧窗口;批量导入、归档删除或数据重分布之后,则应把手动 ANALYZE 作为变更流程的一部分。
统计策略不应该只看“多久跑一次”,还要看“什么变化会让旧统计失效”。例如每天固定追加少量均匀数据,自动分析通常足够;一次批量导入把某个类别从 5% 变成 60%,即使距离上次分析没有多久,也可能已经改变优化器应该采用的访问路径。
只对真正敏感的列提高统计目标
default_statistics_target 决定默认统计目标;单列还可以通过 ALTER TABLE ... ALTER COLUMN ... SET STATISTICS 单独设置。提升统计目标可能让分布估计更细,但也意味着统计信息收集成本上升,所以不适合把全局值“一刀切”调得很高。
更实用的做法是先找出对选择率最敏感的列,例如订单状态、租户标识、地域、业务类型或其他明显存在长尾与热点的列,再只提高这些列的统计目标。修改后执行 ANALYZE,最后用代表性 SQL 的 EXPLAIN 检查估算是否改善。
ALTER TABLE orders
    ALTER COLUMN customer_id SET STATISTICS 500;

ANALYZE orders;

SELECT attname, n_distinct, most_common_vals, most_common_freqs
FROM pg_stats
WHERE schemaname = 'public'
  AND tablename = 'orders'
  AND attname = 'customer_id';
预期结果
    attname    | n_distinct | most_common_vals | most_common_freqs
---------------+------------+------------------+-------------------
 customer_id   |       ...  | {...}            | {...}
其中 ... 与具体数据有关。验证重点是 pg_stats 中该列的统计信息已经刷新,并能看到当前数据分布的代表性结果,而不是追求某个固定数值。
把统计维护放进变更窗口
统计维护最好和业务变更绑定,而不是完全依赖固定星期几。大批量导入完成后、历史数据归档后、分布发生明显变化后,可以安排目标表的手动 ANALYZE。对高峰敏感的系统,则把执行时间放进低负载窗口,并在维护后抽样验证关键 SQL。
一个实用的维护记录至少保留四项:触发原因、目标表、关键列、执行后的计划变化。这样下一次遇到计划波动时,可以判断是统计过期、数据分布变化,还是 SQL 与索引本身发生了变化,而不是重复尝试提高统计目标。
用计划验证统计策略是否真的有效
统计维护完成后,验证不能停在“ANALYZE 执行成功”。应该选一条真实且典型的慢 SQL,对比维护前后的估算行数、实际行数和主要执行节点;如果估算误差明显收敛,说明统计策略产生了价值。若估算改善但计划仍然错误,就需要继续检查索引、相关列相关性或 SQL 结构。
最终策略应满足一个简单原则:稳定表依赖自动维护,高变更表缩短统计陈旧时间,分布突变由业务事件触发手动 ANALYZE,真正敏感的列再单独提高统计目标。 这样统计治理才是在控制计划风险,而不是单纯增加维护次数。