
Linux 与服务器运维 / 系统课时
找到异常进程和资源消耗点
找到异常进程和资源消耗点
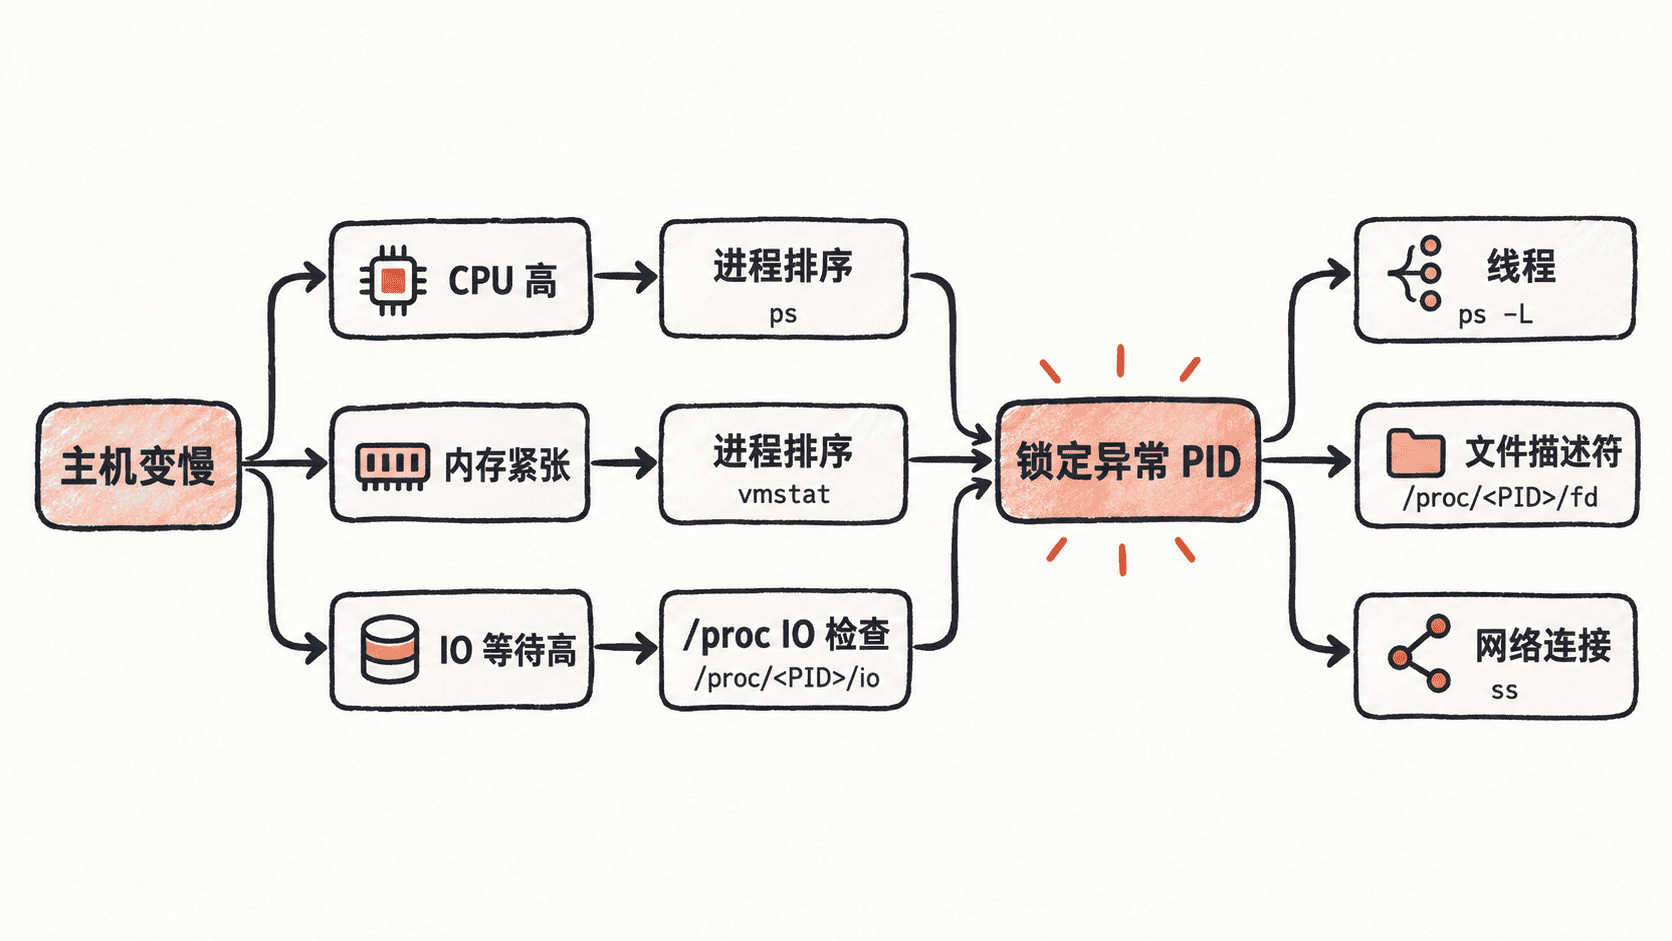
线上主机出现卡顿时,先确认压力落在 CPU、内存还是 IO,再把系统级指标收敛到具体进程。找到进程后还要继续判断是某个线程、文件描述符还是网络连接在消耗资源,避免只凭一个高百分比就贸然重启服务。
学习目标
- 能按 CPU、内存和 IO 三条路径定位高消耗进程
- 能把异常进程继续下钻到线程、文件或网络资源
- 能用多项证据区分真正瓶颈与伴随现象
先判断资源压力落在哪里
不要一开始就盯着某个进程。CPU 高、内存紧张和 IO 等待高的处理路径不同,先用系统级指标确定方向,再进入进程级排查。
uptime
vmstat 1 5
预期输出
 <TIME> up <TIME>,  <N> users,  load average: <LOAD1>, <LOAD5>, <LOAD15>
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
 <N> <N> <N> <N> <N> <N>        <N>  <N>   <N>   <N>  <N>  <N> <N> <N> <N> <N> <N>
实际数值会随负载变化。重点看 vmstat 的 us、sy、wa、si、so:CPU 忙时 us 或 sy 持续升高;磁盘阻塞常伴随 wa 偏高;内存压力严重时可能看到持续的 swap in/out。单次瞬时值不足以下结论,至少观察几个采样周期。
把系统压力收敛到进程
CPU 路径最直接,可以按 %CPU 排序;内存问题则应同时看 %MEM 与常驻内存 RSS,避免只看百分比。
ps -eo pid,ppid,comm,%cpu,%mem,rss --sort=-%cpu | head -n 8
ps -eo pid,ppid,comm,%cpu,%mem,rss --sort=-rss | head -n 8
预期输出
    PID    PPID COMMAND         %CPU %MEM    RSS
   <ID>    <ID> <PROCESS>      <CPU> <MEM> <KB>
   ...
如果 CPU 榜首进程与业务异常时间一致,就继续查看线程;如果 RSS 持续增长并接近内存上限,要结合 OOM、swap 和应用自身内存指标判断是否泄漏。仅仅看到缓存占用较大,不等于进程真的缺内存。
IO 路径先找出谁在持续读写。已安装 sysstat 时,可以用 pidstat 做短时间采样,而不是只看某个瞬间。
pidstat -d 1 3预期输出
Average:      UID       PID   kB_rd/s   kB_wr/s kB_ccwr/s iodelay  Command
Average:    <UID>      <ID>     <READ>    <WRITE>   <CANCEL> <DELAY> <PROCESS>
实际列宽和数值会随系统变化。若某个 PID 的读写速率持续突出,再读取它的累计 IO 计数确认。把 <ID> 替换为真实 PID。
cat /proc/<ID>/io预期输出
rchar: <BYTES>
wchar: <BYTES>
syscr: <COUNT>
syscw: <COUNT>
read_bytes: <BYTES>
write_bytes: <BYTES>
cancelled_write_bytes: <BYTES>
连续两次观察时,若 read_bytes 或 write_bytes 增长很快,说明该进程确实在产生块设备 IO;只看 rchar、wchar 可能包含页缓存命中的读写,不能直接等同于磁盘吞吐。
下钻到线程、文件和网络
锁定 PID 后,要根据现象继续缩小范围。CPU 高通常先看线程;IO 异常先看打开文件和文件描述符;连接数、超时或重传异常则看 socket。
ps -L -p <ID> -o pid,tid,psr,pcpu,stat,comm --sort=-pcpu | head
ls -l /proc/<ID>/fd | head
ss -tpn | grep "pid=<ID>,"
预期输出
    PID     TID PSR %CPU STAT COMMAND
   <ID>    <ID> <N> <CPU> <STATE> <PROCESS>
total <N>
lrwx------ 1 <USER> <GROUP> <N> <TIME> 0 -> socket:[<ID>]
ESTAB 0 0 <IP>:<PORT> <IP>:<PORT> users:(("<PROCESS>",pid=<ID>,fd=<N>))
实际输出取决于权限、进程类型和连接状态;没有匹配到 ss 结果不代表进程异常,只表示当前没有符合条件的 TCP 连接。若 ps -L 只有一个线程长期占满核心,应转向线程栈或性能分析;若 /proc/<ID>/fd 数量持续增长,则要检查文件、socket 或管道是否泄漏。
用证据链确认根因
一次可靠的定位至少要满足“时间一致、指标一致、资源一致”。例如主机 wa 升高、某进程 write_bytes 快速增长、该进程同时持有大量目标数据文件,这三项可以形成较强的 IO 证据链;反之,若进程 CPU 高但系统仍有大量 id,它可能只是正常使用了一个核心。
最终目标不是找到“最忙的进程”,而是把故障从主机资源压力逐层收敛到可解释、可验证的具体资源消耗点。