
Linux 与服务器运维 / 系统课时
故障时间线应该怎么还原
故障时间线应该怎么还原
故障排查最容易出错的地方,是只盯着最后一条报错。更可靠的方法是围绕故障时刻建立时间窗,把应用、systemd 服务和内核事件按统一时间顺序排列,再判断哪一条是起点、哪一些只是后续连锁反应。
学习目标
- 以故障发生时刻为锚点划定可复核的日志时间窗
- 将应用、服务与内核日志归一到同一时间线
- 区分根因事件、放大事件和结果性报错
先固定时间锚点
先确认故障大约何时开始、持续多久,以及日志使用的时区。截图里的“4 点左右”、监控告警时间和用户反馈时间都只能作为线索,最终要换算成服务器上的统一时间。
可以先确认服务器当前时间和时区:
date --iso-8601=seconds
timedatectl
预期输出
<TIME>
               Local time: <TIME>
           Universal time: <TIME>
                 Time zone: <TIMEZONE>
实际时间与时区会因主机而异。若多台主机时区不同,应先换算后再比较,否则几分钟的“先后关系”就可能被看反。
以故障时刻建立前后时间窗
不要从整天日志里全文搜索。先选择一个覆盖“正常→异常→恢复”过程的窗口,例如故障前 5~10 分钟到故障后 10~20 分钟。窗口太窄会漏掉诱因,太宽则会引入大量无关噪声。
下面分别收集指定服务与内核日志。把 <UNIT> 替换为真实 systemd Unit,把两个 <TIME> 分别替换为窗口起止时间:
journalctl -u "<UNIT>" --since "<TIME>" --until "<TIME>" -o short-iso-precise --no-pager
journalctl -k --since "<TIME>" --until "<TIME>" -o short-iso-precise --no-pager
预期输出
<TIME> <HOST> <PROCESS>[<ID>]: <MESSAGE>
<TIME> <HOST> kernel: <MESSAGE>
输出条数和消息内容取决于机器实际日志;如果时间窗内没有匹配事件,对应命令可能不输出日志。
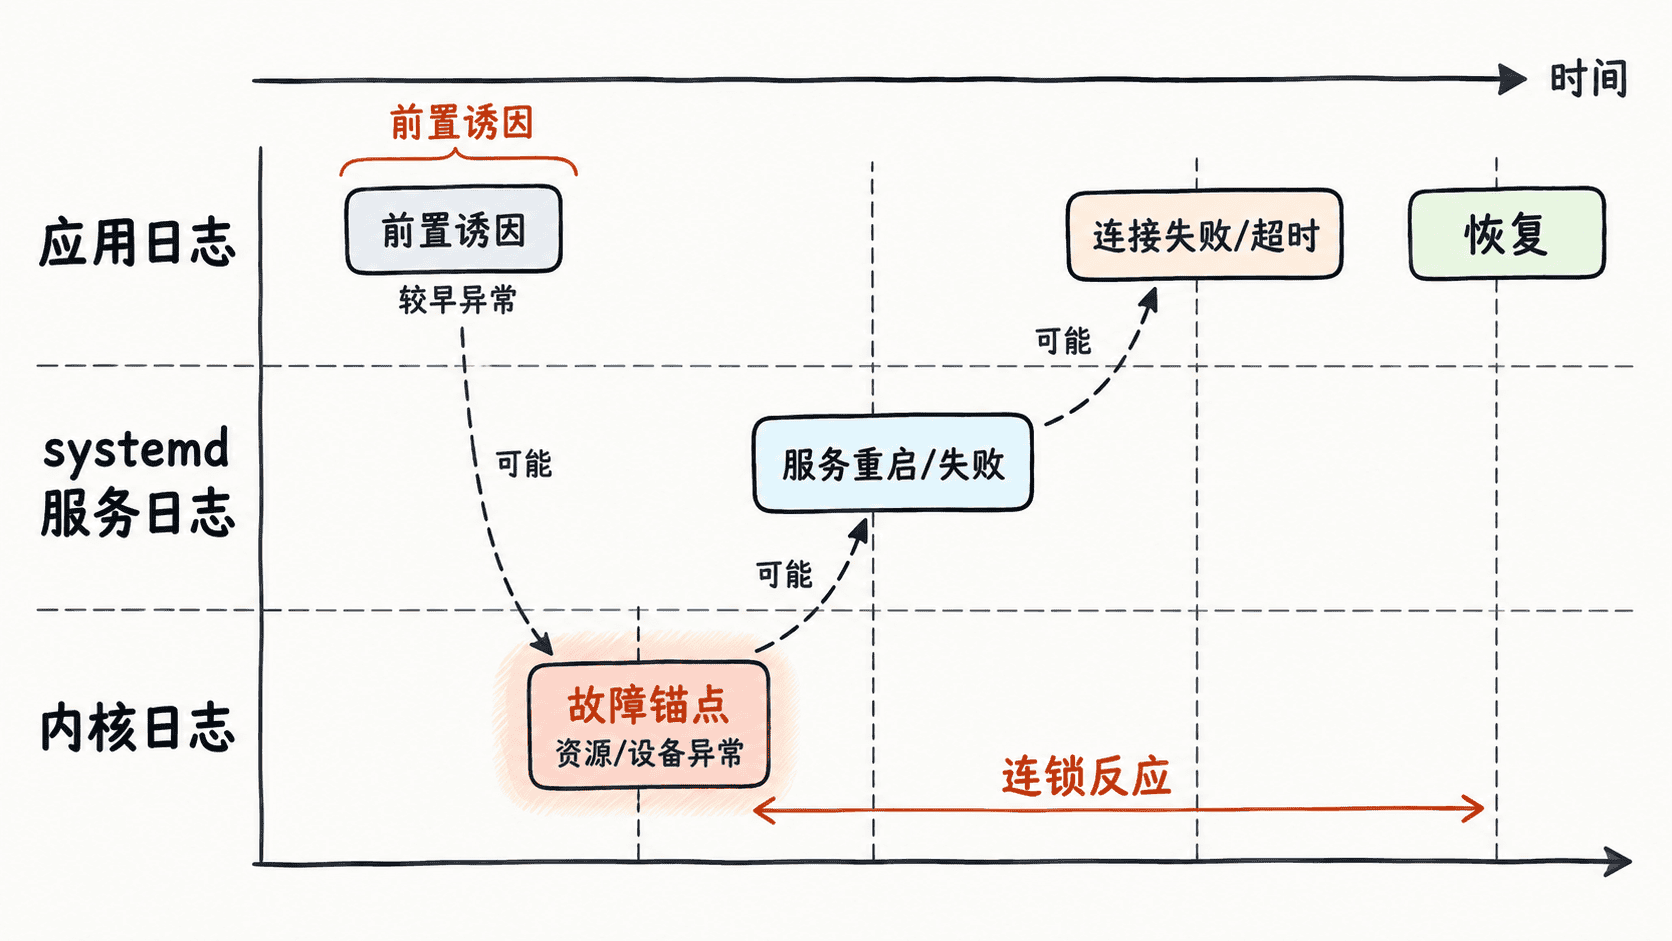
把不同来源排到同一条线上
应用日志如果不在 journal 中,还要从应用自身日志文件取出同一时间窗。关键不是“日志越多越好”,而是每条记录都至少保留时间、主机或实例、来源组件和事件内容。
整理时建议按时间升序记录四类信息:事件时间、来源、观察到的现象、与前后事件的关系。例如先出现内核 OOM,再出现服务被杀,再出现上游请求 502,这条链路就比单独看到 502 更接近根因。
判断哪一条才是起点
还原时间线时可以从“最早出现且能解释后续现象”的事件开始验证。常见顺序是:资源或内核异常 → 服务状态变化 → 应用连接失败 → 用户请求报错,但真实故障也可能从应用配置错误开始,再触发重试风暴和资源耗尽。
判断某条日志是否接近根因,至少检查两点:它是否发生在主要症状之前,以及修复该问题后后续症状是否随之消失。只满足时间先后而不能解释后续现象的记录,应保留为相关事件,而不是直接标记为根因。
用恢复点校验时间线
故障恢复同样重要。找到服务恢复、资源回落或请求重新成功的时刻,再反向检查此前最后一次异常事件。若“异常出现”和“异常消失”都与同一组件状态变化对应,因果判断会更有说服力。
最终时间线不需要记录每一行日志,只保留能解释状态变化的关键节点。这样既能回答“故障从什么时候开始”,也能说明“哪个事件先发生、哪些是连锁反应、恢复为什么发生”。