
Linux 与服务器运维 / 系统课时
CPU 飙高时先看哪些数据
CPU 飙高时先看哪些数据
CPU 飙高时不要先看到某个进程就直接结束它。更可靠的第一步是用 top 同时确认整体 CPU 状态、系统负载和进程排名,区分用户态计算、内核态消耗、I/O 等待,再决定下一步应该查应用还是查系统层。
学习目标
- 能读懂
top中用户态、内核态、空闲和 I/O 等待比例 - 区分系统负载高与 CPU 真正饱和
- 从整体 CPU 指标进一步定位高占用进程
先看整体 CPU,而不是先杀进程
排查顺序应从主机整体状态开始。如果 %id 已接近 0,同时 %us 或 %sy 很高,才说明 CPU 执行时间确实接近耗尽。反过来,如果空闲比例仍然很高,就不能仅凭某个进程瞬间出现较大的 %CPU 断定整台机器 CPU 不够。
在终端执行 top,等待至少一次刷新后再读取 CPU 行,使采样更能反映当前状态。进入界面后可按大写 P 按进程 CPU 使用率排序,按 q 退出。
top -d 1预期输出
top - <TIME> up <UPTIME>,  <USERS> user(s),  load average: <LOAD1>, <LOAD5>, <LOAD15>
Tasks: <TOTAL> total, <RUNNING> running, <SLEEPING> sleeping, <STOPPED> stopped, <ZOMBIE> zombie
%Cpu(s): <US> us, <SY> sy, <NI> ni, <IDLE> id, <WA> wa, <HI> hi, <SI> si, <ST> st
MiB Mem : <TOTAL_MEM> total, <FREE_MEM> free, <USED_MEM> used, <BUFF_CACHE> buff/cache

    PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
   <ID> <USER>    <PR> <NI> <VIRT> <RES> <SHR> R <CPU> <MEM> <TIME> <COMMAND>
这些数值都会随机器和采样时刻变化。重点不是记住具体数字,而是先判断 CPU 时间主要花在哪一类状态,再观察排名靠前的进程是否与整体变化一致。
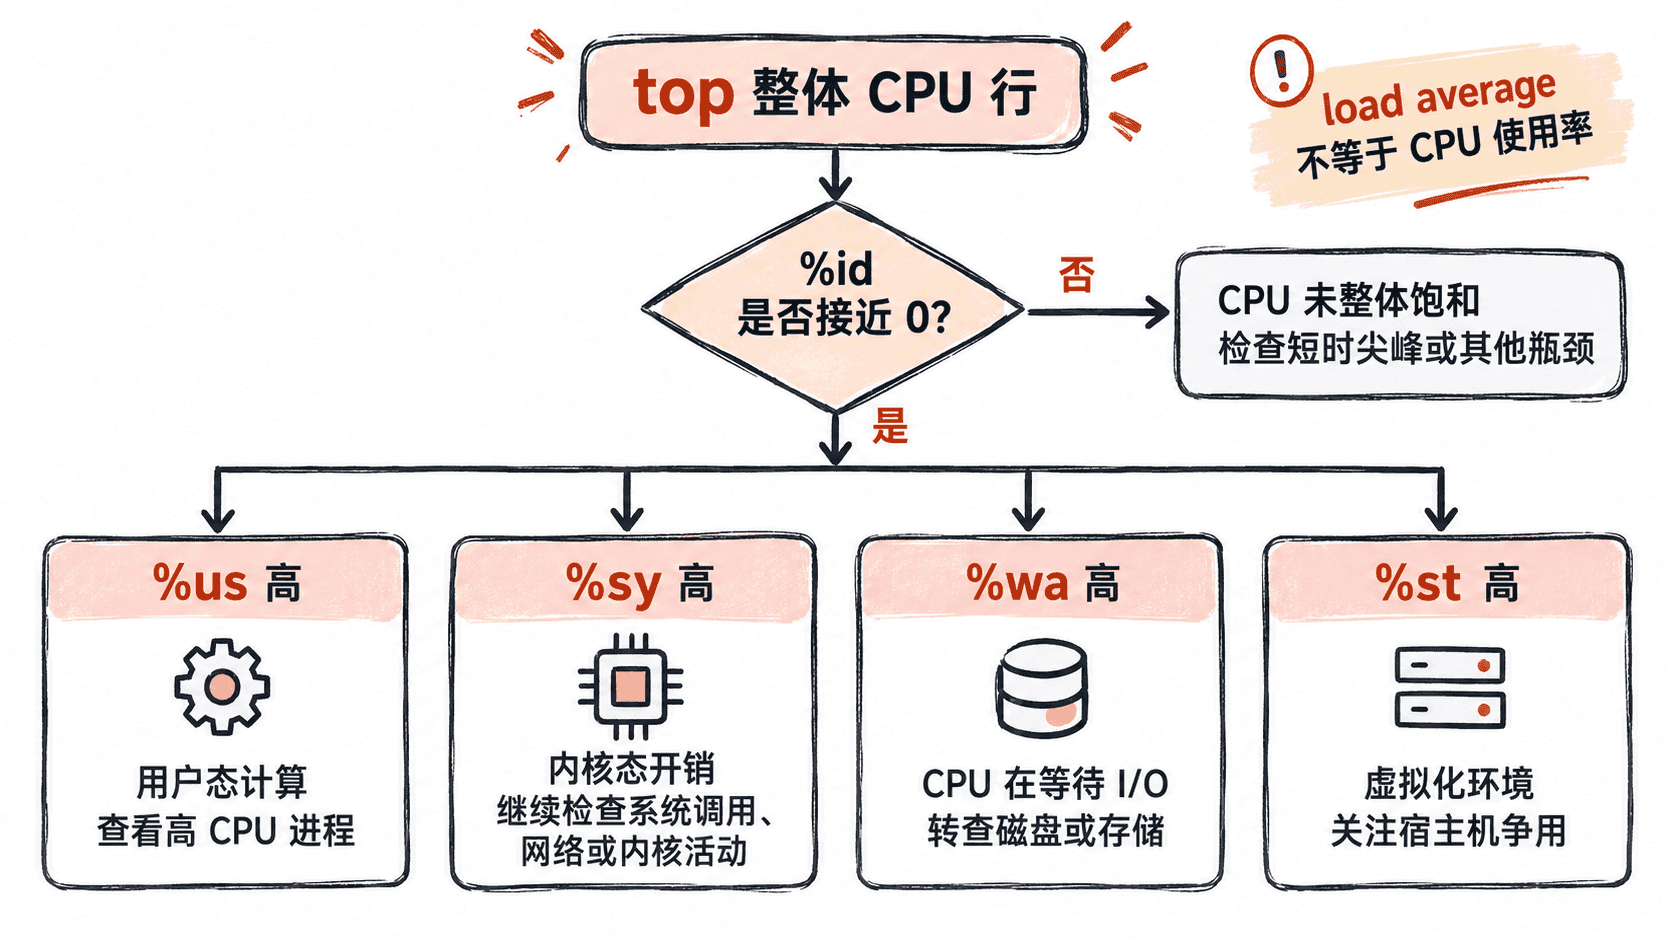
CPU 行里的几个关键比例
us 表示用户态执行时间,应用进行计算、压缩、序列化等工作时通常会增加。sy 表示内核态执行时间,如果它明显升高,应关注系统调用、网络处理、驱动或其他内核活动,而不是只检查业务代码。
id 是空闲比例,是判断整机 CPU 是否真正紧张的重要数据。wa 表示等待 I/O 的时间,高 wa 往往意味着任务在等待磁盘或存储完成,并不等同于 CPU 正在进行大量计算。hi 和 si 分别反映硬中断和软中断处理时间,在网络包量异常等场景中可能升高。
虚拟机环境还要留意 st。它表示虚拟 CPU 本来可以运行,但时间被宿主机调度给了其他虚拟机;因此虚拟机内部看见高 st 时,问题不一定来自本机进程。
不要把 load average 当成 CPU 百分比
top 第一行中的三个 load average 分别反映最近 1、5、15 分钟的系统负载趋势,但它们不是 CPU 使用率。Linux 的负载不仅统计正在使用 CPU 的可运行任务,还包含部分处于不可中断睡眠状态、通常正在等待 I/O 的任务。
因此“load 很高”只能说明等待执行或不可中断的任务较多。判断是不是 CPU 瓶颈,仍要结合 CPU 行中的 us、sy、id、wa 等字段,并结合机器的逻辑 CPU 数量理解负载规模。
再把整体指标映射到具体进程
确认整体 CPU 确实繁忙后,再看 top 下半部分的进程表。重点记录 PID、%CPU、进程状态和命令名,并观察同一个进程是否连续多个采样周期保持高占用。单次冲到前列可能只是正常的短任务,持续高占用才更值得继续深入。
多核系统中,单个多线程进程的 %CPU 可能超过 100%,这并不表示数据错误,而是它同时使用了多个逻辑 CPU。与此同时,TIME+ 是进程累计消耗的 CPU 时间,不能直接当作当前瞬时 CPU 使用率。
定位到进程后也不要立即结束它。先保存 PID、命令、进程状态以及当时的整体 CPU 数据,后续才能判断究竟是业务计算异常、内核开销、I/O 等待,还是虚拟化资源争用。CPU 排障的第一轮目标不是马上修复,而是先把瓶颈类型判断正确。