
Linux 与服务器运维 / 系统课时
进程突然退出从哪里查原因
进程突然退出从哪里查原因
进程“突然没了”时,先不要只盯应用日志。退出可能来自程序主动返回、systemd 管理动作、信号、OOM Killer 或崩溃。把服务状态、服务日志、内核日志和 coredump 按同一时间线对齐,通常能快速区分是哪一层终止了进程。
学习目标
- 建立从 systemd 到应用日志、内核日志和崩溃信息的排查顺序
- 能区分主动退出、收到信号、OOM 和程序崩溃的典型证据
- 知道在证据不足时如何保留现场并避免误判
先锁定退出时间和退出方式
如果进程由 systemd 管理,先看服务当前状态以及主进程的退出信息,再围绕同一时间窗口读取日志。不要一开始就连续重启很多次,否则最关键的一次退出记录可能被后续日志淹没。
下面是一组最小排查命令,其中 <SERVICE> 替换为单元名,例如 myapp.service,<TIME> 替换为接近故障发生时间、可被 journalctl --since 接受的时间表达式:
SERVICE="<SERVICE>"
SINCE="<TIME>"

systemctl status "$SERVICE" --no-pager -l
journalctl -u "$SERVICE" -b --since "$SINCE" --no-pager
journalctl -k -b --since "$SINCE" --no-pager | grep -Ei 'oom|out of memory|killed process' || true
coredumpctl list --since "$SINCE" 2>/dev/null || true
预期输出
systemctl: 显示服务状态,并可能包含主进程的退出码或终止信号
journalctl -u: 显示该服务在 <TIME> 之后的日志,可能包含异常栈或主动退出原因
journalctl -k: 发生 OOM 时可能匹配到 OOM 或 Killed process 相关内核记录;未发生时可能无输出
coredumpctl: 系统保存过崩溃转储时列出相应记录;未启用或没有转储时可能无结果<TIME>、PID、退出码和日志内容都以现场为准。这里的 -b 只查询当前启动周期;如果故障发生在上一次启动,应改查相应 boot 的 journal,而不是据当前 boot 没有记录就判断故障不存在。
四条线索如何串起来
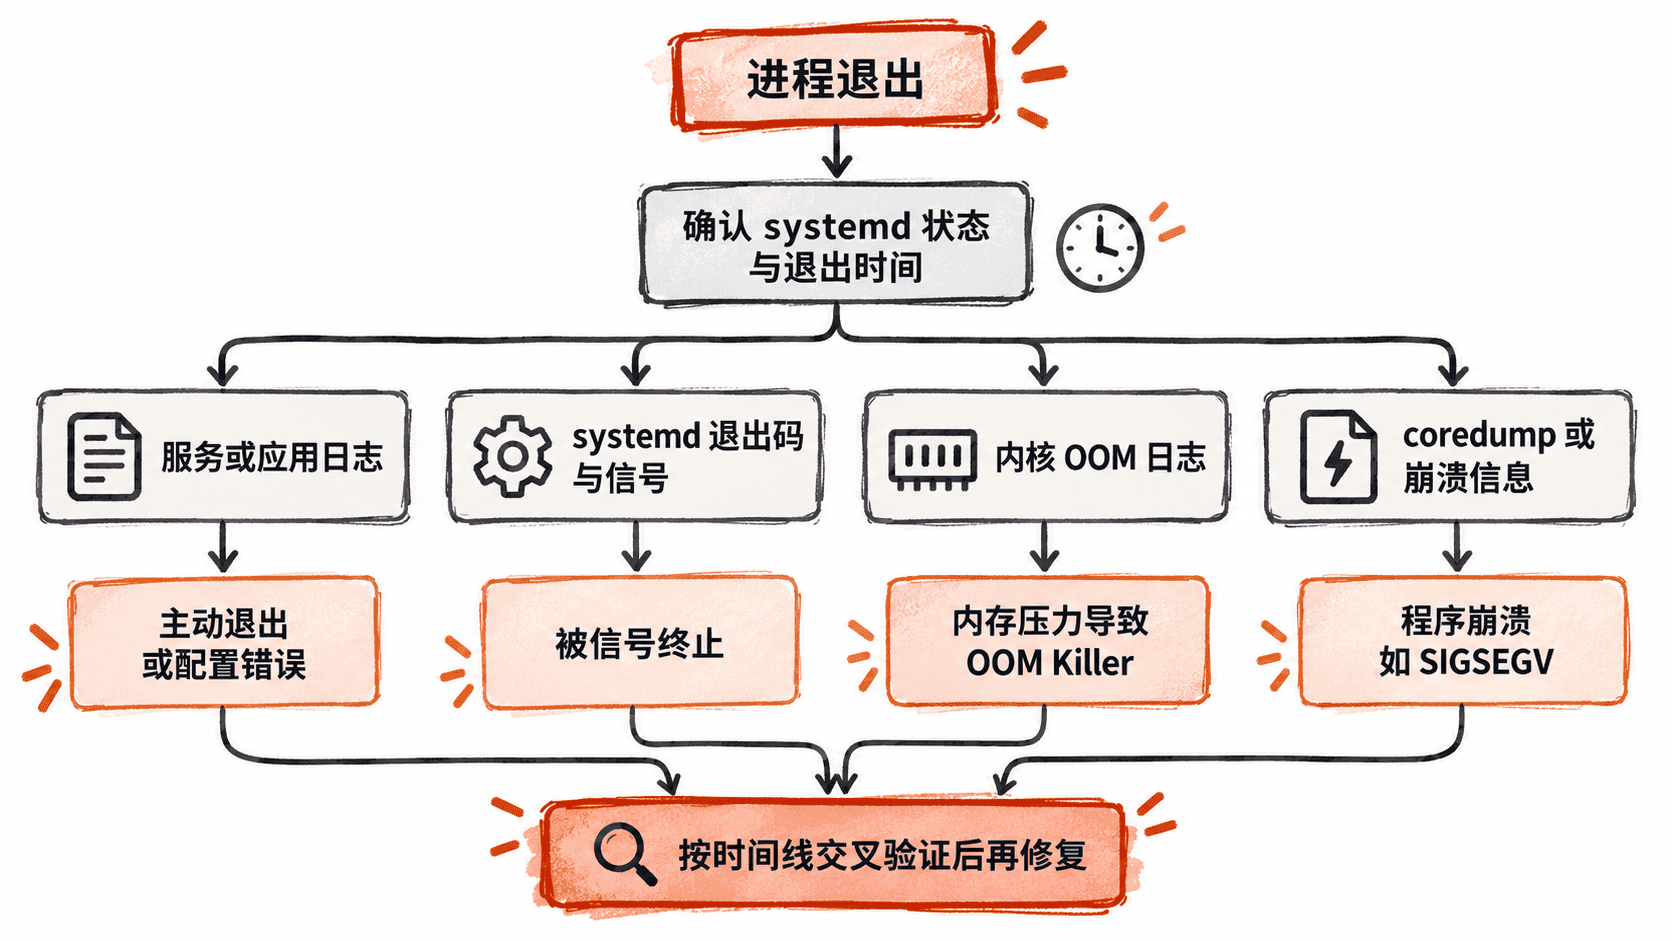
systemd 的退出信息先回答“怎么结束”。如果看到进程以退出码结束,优先查应用为何主动返回;如果记录显示被某个信号终止,就继续追信号来源。SIGSEGV 等信号常与程序崩溃有关,而 SIGTERM 也可能来自正常停止、部署脚本或运维操作。
应用日志回答“退出前做了什么”。重点查看退出前几十秒内最后一批记录,而不是只搜索 ERROR。配置加载失败、依赖异常、未捕获异常、断言失败以及程序主动退出,都可能留下比退出码更直接的上下文。
内核日志主要确认用户态看不到的系统级原因。发生 OOM 时,内核通常会留下内存不足和选择终止进程的相关记录;应用日志则可能突然停止,甚至来不及刷新缓冲区。不能仅凭某个退出码就断言发生了 OOM,应以同一时间附近的内核证据交叉确认。
coredump 适合继续调查非法内存访问、断言触发等崩溃。如果系统启用了 systemd-coredump,可根据列表中的记录继续执行 coredumpctl info 或交给调试器分析;如果没有转储,还应检查转储功能和资源限制,而不是直接认定程序没有崩溃。
常见误判
另一个常见误判是把服务重启后的 active (running) 当成问题已经消失。重启只能证明新进程目前启动成功,不能解释旧进程为什么退出。排障时应保留旧实例的 PID、故障时间、退出信息、最后日志和同期内核事件。
修复后如何验证
修复后至少完成两层验证:第一层确认服务在预期负载下不再异常退出;第二层确认原有证据链也消失,例如不再出现同类 OOM 记录、崩溃信号或重复异常栈。对于偶发故障,还应观察进程重启次数、内存趋势和错误日志覆盖一个有代表性的业务周期。
当 systemd、应用日志、内核日志和 coredump 的时间线能够互相印证时,退出原因就能从猜测收敛为可验证的结论,后续修复也更容易针对真正的根因。