
Linux 与服务器运维 / 系统课时
连接数突然暴涨应该怎么看
连接数突然暴涨应该怎么看
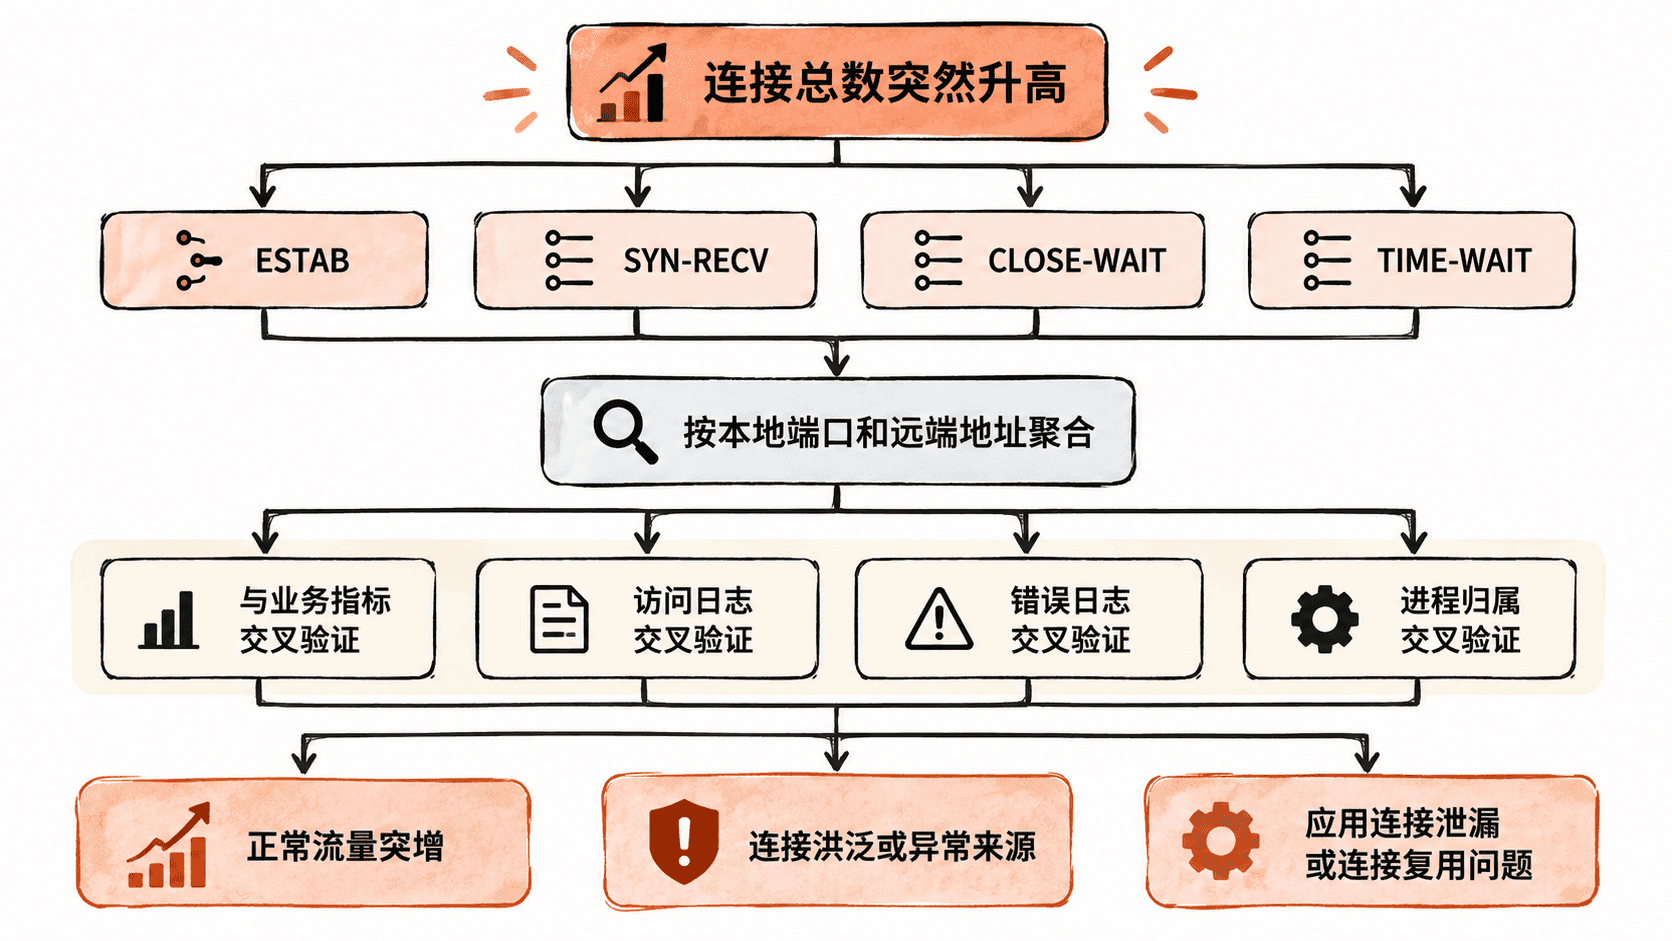
连接数突然升高时,先不要把所有连接都视为攻击。有效的排查顺序是先按 TCP 状态拆分,再看本地端口、远端地址和进程归属,最后与业务流量和错误日志对齐,从而区分正常流量突增、连接洪泛与应用连接泄漏。
学习目标
- 用
ss快速统计 TCP 状态分布,判断增长发生在哪个阶段 - 按远端地址和本地服务端口聚合连接,定位异常流量来源
- 根据状态趋势区分业务流量上涨、攻击迹象和应用连接泄漏
先按状态拆开总连接数
总数只能告诉你“连接多了”,不能告诉你为什么。第一步统计各 TCP 状态:
ss -Htan | awk '{print $1}' | sort | uniq -c | sort -nr预期输出(示例,实际数量会不同):
<COUNT> ESTAB
<COUNT> TIME-WAIT
<COUNT> SYN-RECV
<COUNT> CLOSE-WAIT
<COUNT> 是动态值。观察重点是哪个状态突然抬升:ESTAB 多说明大量连接已经建立;SYN-RECV 多说明大量握手尚未完成;CLOSE-WAIT 持续增长更像本地应用没有释放已被对端关闭的连接;TIME-WAIT 高则常见于大量短连接结束后,不能单凭这一项判定连接泄漏。
再看连接集中到哪里
如果 ESTAB 很高,先看远端地址是否高度集中。下面命令统计已建立连接的对端地址,并去掉末尾端口:
ss -Htan state established | awk '{print $4}' | sed -E 's/:[0-9]+$//' | sort | uniq -c | sort -nr | head预期输出(示例,地址和数量会不同):
<COUNT> <IP>
<COUNT> <IP>
<COUNT> <IP>
如果大量连接集中在少数远端地址,需结合反向代理、负载均衡、NAT 和 CDN 架构解释来源。看到同一个 IP 并不自动等于攻击,因为经过代理后,内核看到的对端可能只是代理节点。
同时查看连接主要打到哪个本地端口:
ss -Htan | awk '{print $4}' | sed -E 's/^.*:([0-9]+)$/\1/' | sort | uniq -c | sort -nr | head预期输出(示例):
<COUNT> <PORT>
<COUNT> <PORT>
若某个 <PORT> 占绝大多数,再回到该端口对应的服务和访问日志继续查。
把状态模式映射到可能根因
ESTAB 与请求量、吞吐量同时上升,而且远端来源分散,通常更符合真实业务流量突增。此时应检查应用 CPU、线程池、连接池、队列长度和响应时间,确认容量是否还能承受。
SYN-RECV 显著升高而成功请求没有同步增加,说明很多连接停在握手阶段。可能是突发扫描、SYN 洪泛、上游网络异常或服务处理能力不足,需要继续结合防火墙、负载均衡和抓包数据确认,不能仅凭一个状态下结论。
CLOSE-WAIT 单向增长并集中到某个进程,优先检查应用是否漏关连接。TIME-WAIT 大量出现时,要先确认是否存在高频短连接;如果是本机主动建立大量出站连接,还应检查客户端是否缺少连接复用。
最后确认进程和趋势
当异常集中在某个服务时,用进程信息确认谁持有这些连接:
sudo ss -Htanp state established | head预期输出(示例,实际地址、端口、PID 和文件描述符会不同):
0 0 <IP>:<PORT> <IP>:<PORT> users:(("nginx",pid=<ID>,fd=<ID>))
0 0 <IP>:<PORT> <IP>:<PORT> users:(("nginx",pid=<ID>,fd=<ID>))
真正有效的结论来自“状态趋势 + 来源分布 + 端口/进程 + 业务指标”四项交叉验证。这样既能避免把正常峰值误判为攻击,也能及时识别连接洪泛和应用自身的连接泄漏。