
Linux 与服务器运维 / 系统课时
服务频繁重启怎么查
服务频繁重启怎么查
服务几秒一次地启动又退出时,先不要把问题简单归因于 systemd。真正需要回答的是:应用为什么退出,以及 Restart= 为什么继续把它拉起。本节用退出状态、重启策略和启动限速三个证据,把“应用持续崩溃”和“策略造成循环”分开。
学习目标
- 从应用退出状态判断主进程为何结束
- 正确解读
Restart=、RestartSec=与启动限速的关系 - 修复后验证服务稳定运行,而不是只看一次
active
先看清重启循环由谁触发
一次循环通常包含“主进程退出 → systemd 判断退出原因 → 匹配 Restart= 策略 → 等待 RestartSec= → 再次启动”。如果短时间内重复启动超过限制,服务还可能进入 failed,此时现象会从“不断重启”变成“启动过于频繁”。
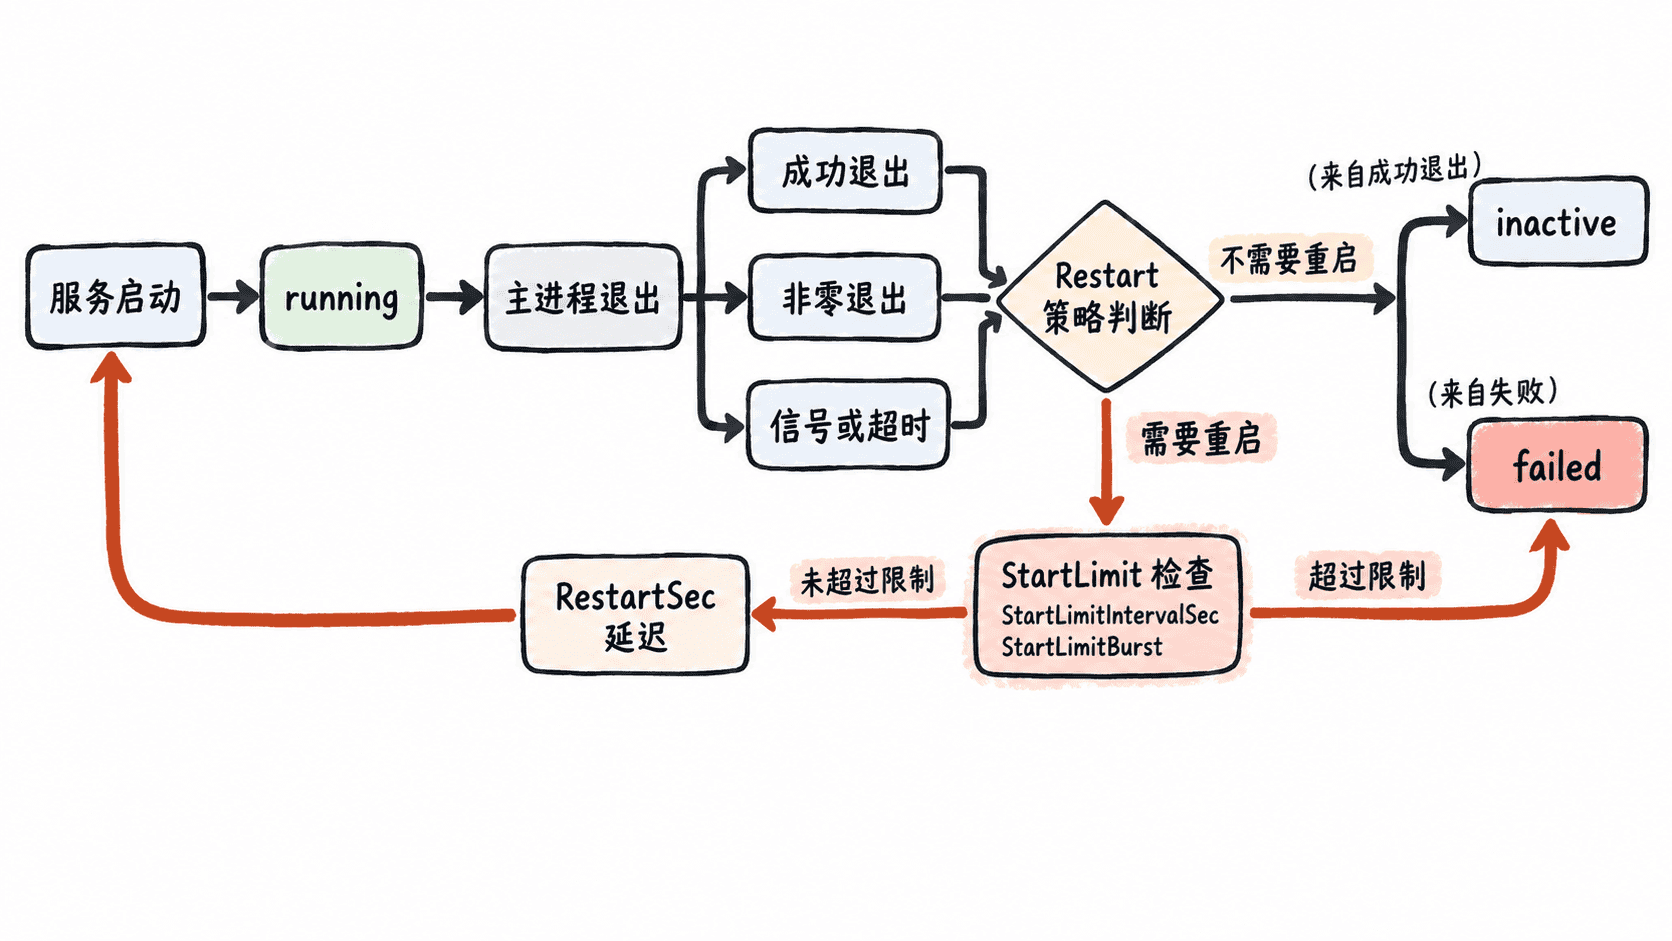
这张图的关键不是背状态名,而是把两个问题拆开:退出原因属于应用层,是否再次启动属于服务策略层。只有两者同时看,才能解释为什么服务会循环。
先抓退出码和当前策略
systemctl status 适合快速观察,但脚本化排查更适合读取重启策略,再结合 journal 看退出原因。下面以 unit 使用 Restart=on-failure、RestartSec=2s,且应用最近一次以状态码 1 退出为例;你的实际值可能不同。
systemctl show myapp.service -p Restart -p RestartUSec -p NRestarts
journalctl -u myapp.service -b -n 80 --no-pager
预期输出
Restart=on-failure
RestartUSec=2s
NRestarts=<COUNT>
<TIME> <HOST> systemd[1]: myapp.service: Main process exited, code=exited, status=1/FAILURE
<TIME> <HOST> systemd[1]: myapp.service: Failed with result 'exit-code'.<COUNT>、<TIME> 和 <HOST> 会随机器与运行次数变化。状态码 1 说明这次主进程以非零状态退出;真正的业务根因通常在这两条 systemd 消息之前,例如配置解析失败、端口占用、依赖不可达或文件权限错误。
再确认 Restart 是否符合预期
常见策略的判断重点如下。
Restart= |
典型行为 | 适合场景 |
|---|---|---|
no |
退出后不自动重启 | 一次性任务或希望人工介入 |
on-failure |
非正常失败时重启 | 大多数长期运行服务 |
on-success |
正常退出后重启 | 特定轮转式进程 |
always |
无论退出原因都尝试重启 | 必须持续驻留且已明确退出语义的进程 |
如果一个本来应该执行一次就正常退出的程序配置成 Restart=always,systemd 会按策略持续拉起它,即使应用没有崩溃。反过来,长期服务使用 Restart=on-failure 时,非零退出就会自然形成循环,直到应用恢复或触发启动限速。
给重启设置合理的缓冲和限速
长期服务可以让 systemd 在暂时性故障后自动恢复,但应保留重试间隔和速率限制,避免毫秒级崩溃造成日志洪泛与 CPU 抖动。
[Unit]
Description=My App
StartLimitIntervalSec=60s
StartLimitBurst=5

[Service]
Type=simple
ExecStart=/usr/local/bin/myapp
Restart=on-failure
RestartSec=5s
这是配置片段,需放入完整 unit 的对应段落。生效前先确认 /usr/local/bin/myapp 存在且可执行;StartLimitIntervalSec=60s 与 StartLimitBurst=5 限制统计窗口内的启动频率,超过限制后新的启动会被拒绝。窗口过去后可再次尝试,systemctl reset-failed 也可清除失败状态并重置启动限速计数。
修改后重新加载并启动服务。
sudo systemctl daemon-reload
sudo systemctl reset-failed myapp.service
sudo systemctl restart myapp.service
systemctl is-active myapp.service
预期输出
activereset-failed 会清除失败状态并重置相关启动限速计数,但它不会修复应用本身。若应用仍立即退出,服务还会再次失败。
验证它是真的稳定了
一次看到 active 只能证明检查瞬间进程在运行。修复后应观察一段符合业务启动时间的窗口,再确认自动重启计数不再增长,并检查 journal 中是否还有新的退出记录。
before=$(systemctl show myapp.service -p NRestarts --value)
sleep 10
after=$(systemctl show myapp.service -p NRestarts --value)
printf 'before=%s after=%s\n' "$before" "$after"
systemctl is-active myapp.service
预期输出
before=<COUNT> after=<COUNT>
active
这里两个 <COUNT> 应相同;具体数值不要求是 0,因为它可能保留当前服务生命周期内已经发生过的自动重启次数。如果计数继续增加,就回到最近一次退出前的应用日志继续定位,而不是继续放宽重启策略。
频繁重启最终要形成一条证据链:应用以什么状态退出、哪条 Restart= 规则命中、多久后再次启动、是否触发启动限速。只要这四件事能够分别验证,就能判断是应用持续崩溃,还是 unit 的生命周期策略与程序实际语义不匹配。