
Linux 与服务器运维 / 系统课时
故障现场应该保留哪些信息
故障现场应该保留哪些信息
很多 Linux 故障一重启就“好了”,但进程、连接和瞬时资源状态也随之消失。本节给出一套重启或清理前的最小取证清单,把时间、日志、进程、连接和资源快照留在同一目录,方便后续按时间线追根因。
学习目标
- 明确重启、清理前最值得保存的故障现场信息
- 能一次性采集时间、资源、进程、连接和系统日志
- 判断现场资料是否足以支持后续根因分析
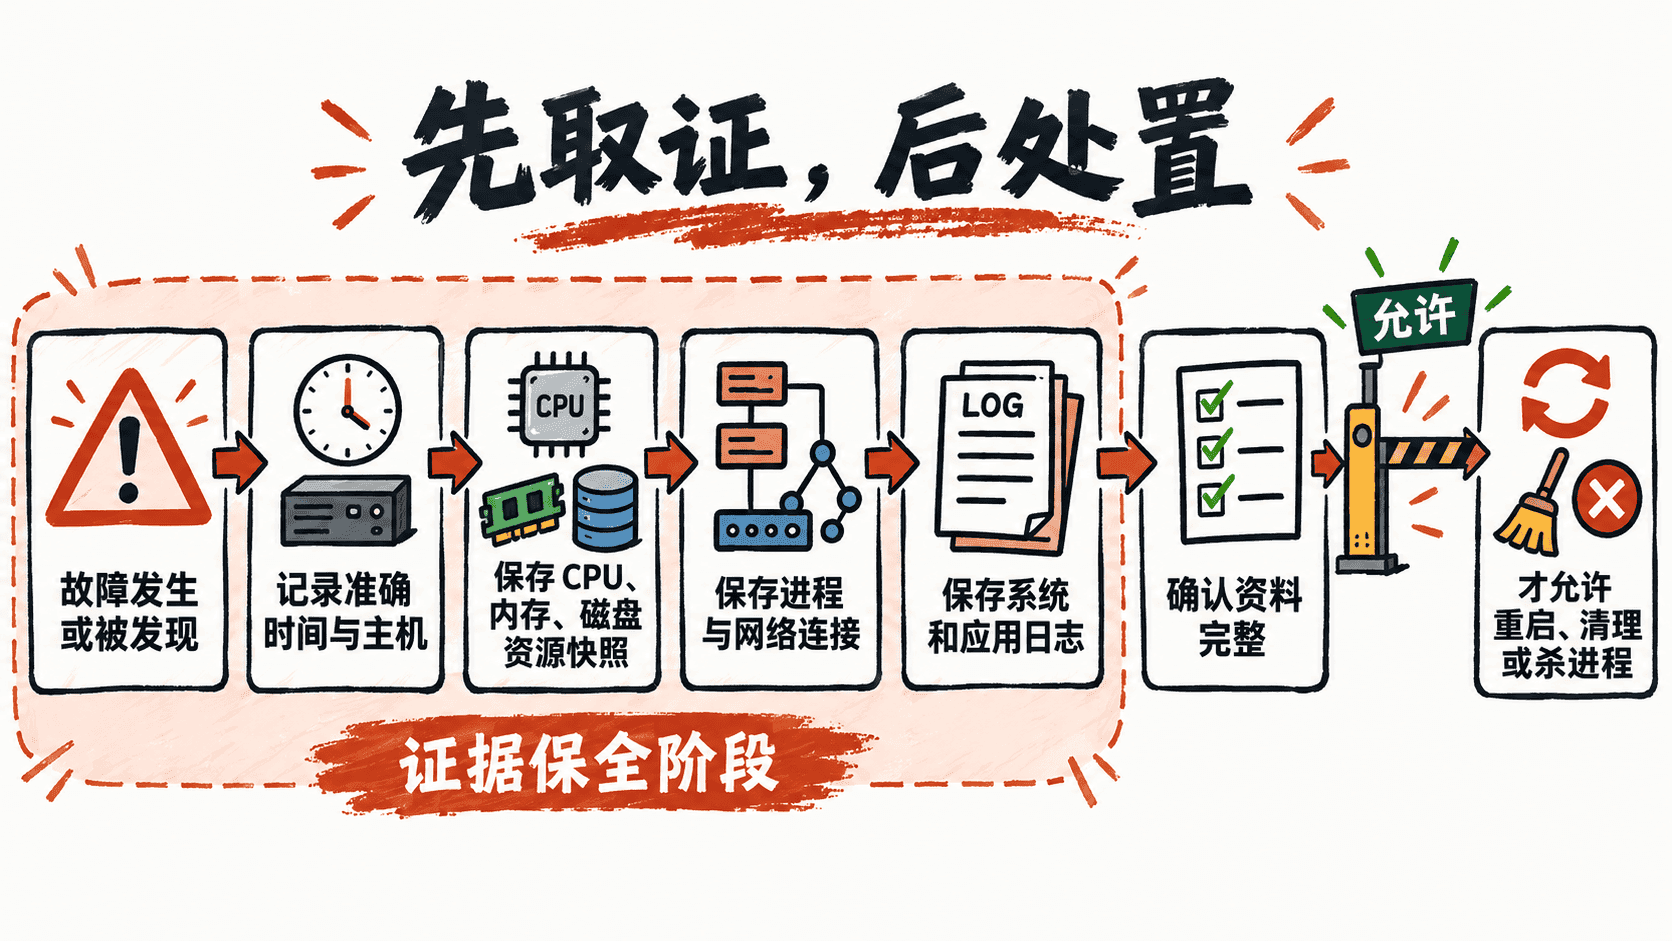
先保留证据,再改变系统状态
故障现场最重要的原则不是“马上恢复”,而是先判断接下来的操作会不会销毁证据。重启服务会改变 PID、连接和内存状态,重启主机会清空大量瞬时信息,日志清理或磁盘腾挪还可能直接删除故障窗口内的记录。
至少先记住故障发生或被发现的准确时间,并保留时区。后续分析 CPU 峰值、应用错误、内核日志和网络断连时,都要靠这条时间线对齐。如果多人参与排查,还应同时记录观察到的现象,例如“请求超时”“SSH 卡顿”或“某服务无法连接数据库”。
最小现场包包含什么
一次有效的现场采集通常至少覆盖五类信息。时间和主机信息负责建立时间线;CPU、内存和磁盘数据说明资源状态;进程列表用于确定当时谁在运行以及资源占用;网络连接反映监听端口和连接状态;系统日志则提供服务退出、内核异常和设备错误等事件线索。
对于使用 systemd 的常见 Linux 主机,可以在执行破坏性操作前创建一个独立目录并集中保存这些数据。下面的示例不会修改服务状态,只读取当前系统信息。
incident_dir="/tmp/incident-$(date +%Y%m%d-%H%M%S)"
mkdir -p "$incident_dir"

date -Is > "$incident_dir/time.txt"
hostname > "$incident_dir/hostname.txt"
uptime > "$incident_dir/uptime.txt"
free -h > "$incident_dir/memory.txt"
df -h > "$incident_dir/disk.txt"
top -b -n 1 > "$incident_dir/top.txt"
ps -eo pid,ppid,user,stat,etimes,%cpu,%mem,comm --sort=-%cpu > "$incident_dir/processes.txt"
ss -tanp > "$incident_dir/network.txt" 2>&1
journalctl --since "15 minutes ago" --no-pager > "$incident_dir/journal.txt"

printf '%s\n' "$incident_dir"
ls -1 "$incident_dir"
预期输出
/tmp/incident-<TIME>
disk.txt
hostname.txt
journal.txt
memory.txt
network.txt
processes.txt
time.txt
top.txt
uptime.txt
实际目录名中的时间会不同。普通用户执行 ss -tanp 时可能看不到其他用户进程的程序信息,但连接本身仍可用于分析;journalctl 能看到的日志范围也受当前账号权限影响。
日志必须覆盖故障前后窗口
只保存“报错那一行”通常不够。服务异常往往先出现连接积压、内存压力或依赖超时,然后才产生最终错误,因此应保留故障发生前后的一段日志。示例取最近 15 分钟只是一个起点,真实窗口应根据故障持续时间调整。
系统日志之外,还要保存发生问题的应用日志。如果应用日志不在 systemd journal 中,应把对应时间段单独复制到现场目录。配置文件可以记录版本号或校验值,但不要为了取证把密码、私钥、访问令牌等敏感内容复制到共享故障包中。
什么情况下资料还不够
保存完现场后,先检查时间是否覆盖故障窗口,以及资源、进程、网络和日志文件是否都成功生成。若问题涉及进程崩溃,还可能需要保留 core dump;若只在容器中出现,还应记录容器实例、资源限制和对应日志;若是偶发故障,则应优先保存监控平台上的历史指标,因为当前快照可能已经恢复正常。
真正有用的故障现场不是文件越多越好,而是能够回答“什么时候发生、当时资源怎样、哪些进程和连接存在、系统记录了什么事件”。这些信息一旦齐全,再重启或清理系统,后续分析仍然有据可查。