
Linux 与服务器运维 / 系统课时
ulimit 改大就能解决问题吗
ulimit 改大就能解决问题吗
文件描述符耗尽时,调大 ulimit -n 往往能让服务暂时恢复,但它只扩大可用边界。若连接、文件或管道持续增长,真正的问题仍在资源没有关闭;排查重点应从“上限是多少”转向“数量为什么一直涨”。
学习目标
- 理解文件描述符软限制、硬限制与资源耗尽之间的关系。
- 能通过
/proc判断文件描述符是稳定占用还是持续增长。 - 区分合理扩容与资源泄漏,并确定后续代码排查方向。
先判断是容量不足还是资源泄漏
Linux 为进程维护文件描述符表,普通文件、Socket、管道等都会占用其中的编号。RLIMIT_NOFILE 的软限制决定进程正常情况下能够打开多少描述符,硬限制则约束软限制能够提高到什么范围。
进程触及自己的描述符上限后,open、socket、accept 等调用可能返回 EMFILE。如果整个系统可分配的文件结构耗尽,则可能出现 ENFILE。两者都表现为“打不开新资源”,但排查层级不同。
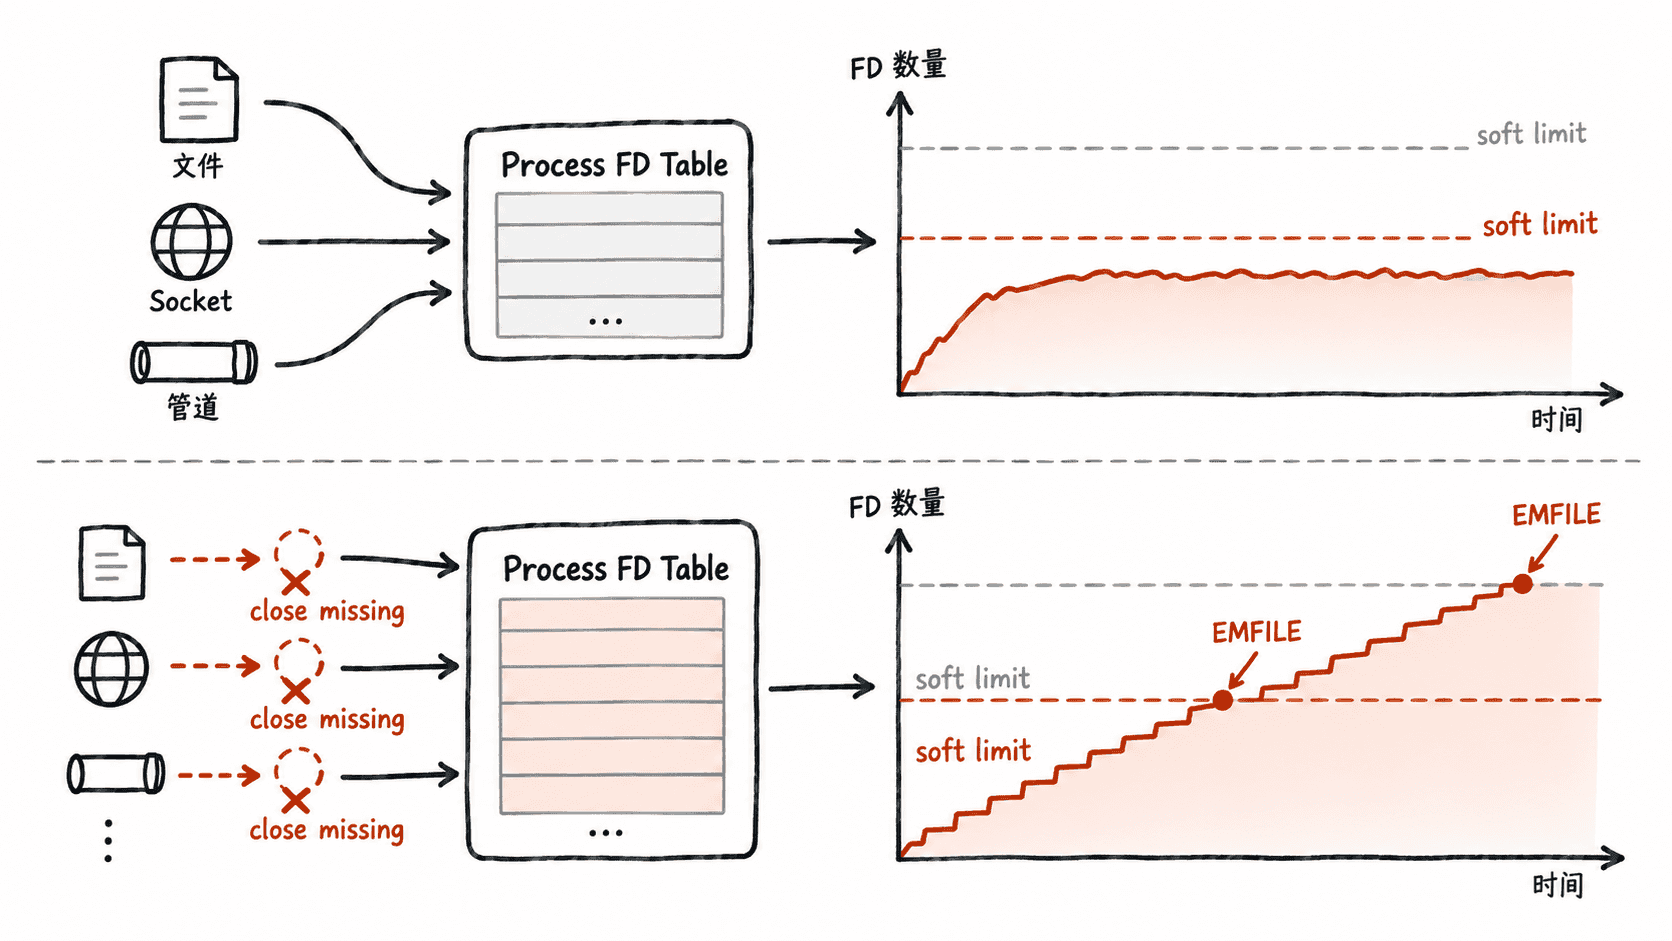
如果业务并发量长期稳定,而文件描述符数量仍单调上升,提高限制只能把故障时间向后推。反过来,如果描述符数量在稳定区间波动,只是峰值接近原上限,那么容量规划不足才更可能是主要问题。
用趋势而不是单点数值判断
先获取目标进程的软硬限制,再连续观察 /proc/<ID>/fd 中的描述符数量。下面的 <ID> 需要替换为实际 PID;时间和数量会随运行状态变化。
PID=<ID>
awk '/Max open files/ {print "soft=" $4, "hard=" $5}' "/proc/$PID/limits"
for i in 1 2 3; do
  printf "%s fd_count=" "$(date +%H:%M:%S)"
  ls -1 "/proc/$PID/fd" | wc -l
  sleep 2
done
预期输出:软硬限制和文件描述符数量会因系统而异,关键是比较多次采样的趋势。
soft=<SOFT> hard=<HARD>
<TIME> fd_count=<COUNT>
<TIME> fd_count=<COUNT>
<TIME> fd_count=<COUNT>
稳定业务负载下,如果 fd_count 一直增加且很少下降,应优先怀疑资源未释放;如果数量随着请求进入和结束而回落,则应结合峰值并发重新评估限制是否合理。
找到增长的是哪类资源
仅知道数量在增长还不够,还需要确认增长对象。可以用 lsof -nP -p <ID> 查看目标进程持有的资源,也可以检查 /proc/<ID>/fd 中符号链接指向的对象。
Socket 持续增加时,应检查 HTTP 客户端、数据库连接池、消息队列连接以及异常路径是否归还连接;普通文件持续增加时,应检查文件流、日志文件、临时文件和轮转逻辑;pipe、eventfd、anon_inode 等不断增加,则要结合线程池、子进程或异步框架继续定位。
真正需要修复的是“谁创建了资源却没有走到关闭路径”。因此还应把描述符类型对应回业务操作,再结合应用日志、指标、连接池统计或短时间 strace 观察,找到重复执行的打开动作和缺失的释放动作。
什么时候调大限制是正确动作
如果已经确认描述符数量会在业务结束后回落,只是正常并发峰值超过原限制,可以在容量评估后提高软限制。临时在当前 Shell 中调整时,新值不能超过硬限制,而且只会影响该 Shell 及其后代进程。
ulimit -Sn <NEW_LIMIT>
ulimit -Sn
预期输出:将 <NEW_LIMIT> 替换为不超过硬限制的实际整数后,第二条命令应显示新的软限制。
<NEW_LIMIT>由 systemd 启动的长期服务通常应在服务配置中使用 LimitNOFILE= 管理限制,而不是依赖交互式 Shell 的 ulimit。无论采用哪种方式,提高上限都应建立在描述符数量可回落、峰值有容量依据这一前提上;若数量持续增长,优先修复未关闭资源的代码路径。