
Linux 与服务器运维 / 系统课时
从告警信息确定排查入口
从告警信息确定排查入口
线上告警同时出现 CPU、Load、内存和接口超时时,最容易犯的错是看到哪个指标高就先查哪个。本节把离散告警还原成时间线,再用一组低风险命令快速判断资源瓶颈方向,避免一上来重启服务而丢失现场。
学习目标
- 把多个告警按发生时间和依赖关系整理成故障时间线
- 根据 CPU、Load、内存和接口超时组合选择第一批检查命令
- 在不破坏现场的前提下获得可继续定位的证据
先把离散告警还原成时间线
同一分钟内出现的告警不一定有相同根因。排查时先找“最早异常”,再看后续指标是否像连锁反应。例如 Load 先升高,随后接口超时,而内存告警更晚出现,入口通常应先放在造成系统排队的资源,而不是先追接口代码。
| 现象顺序 | 可能说明 | 第一轮关注点 |
|---|---|---|
| CPU 先升高,Load 随后升高 | 可运行任务增多,计算资源可能饱和 | CPU 使用率、运行队列、热点进程 |
| Load 先升高,但 CPU 不高 | 任务可能阻塞在 IO 或其他不可中断等待 | vmstat 的 b、wa,再查磁盘 |
| 内存持续下降并出现 Swap | 内存压力可能把问题放大为 IO 等待 | 可用内存、si/so、进程占用 |
| 接口超时晚于系统指标异常 | 超时可能是资源瓶颈的结果 | 先确认系统资源,再看应用与网络 |
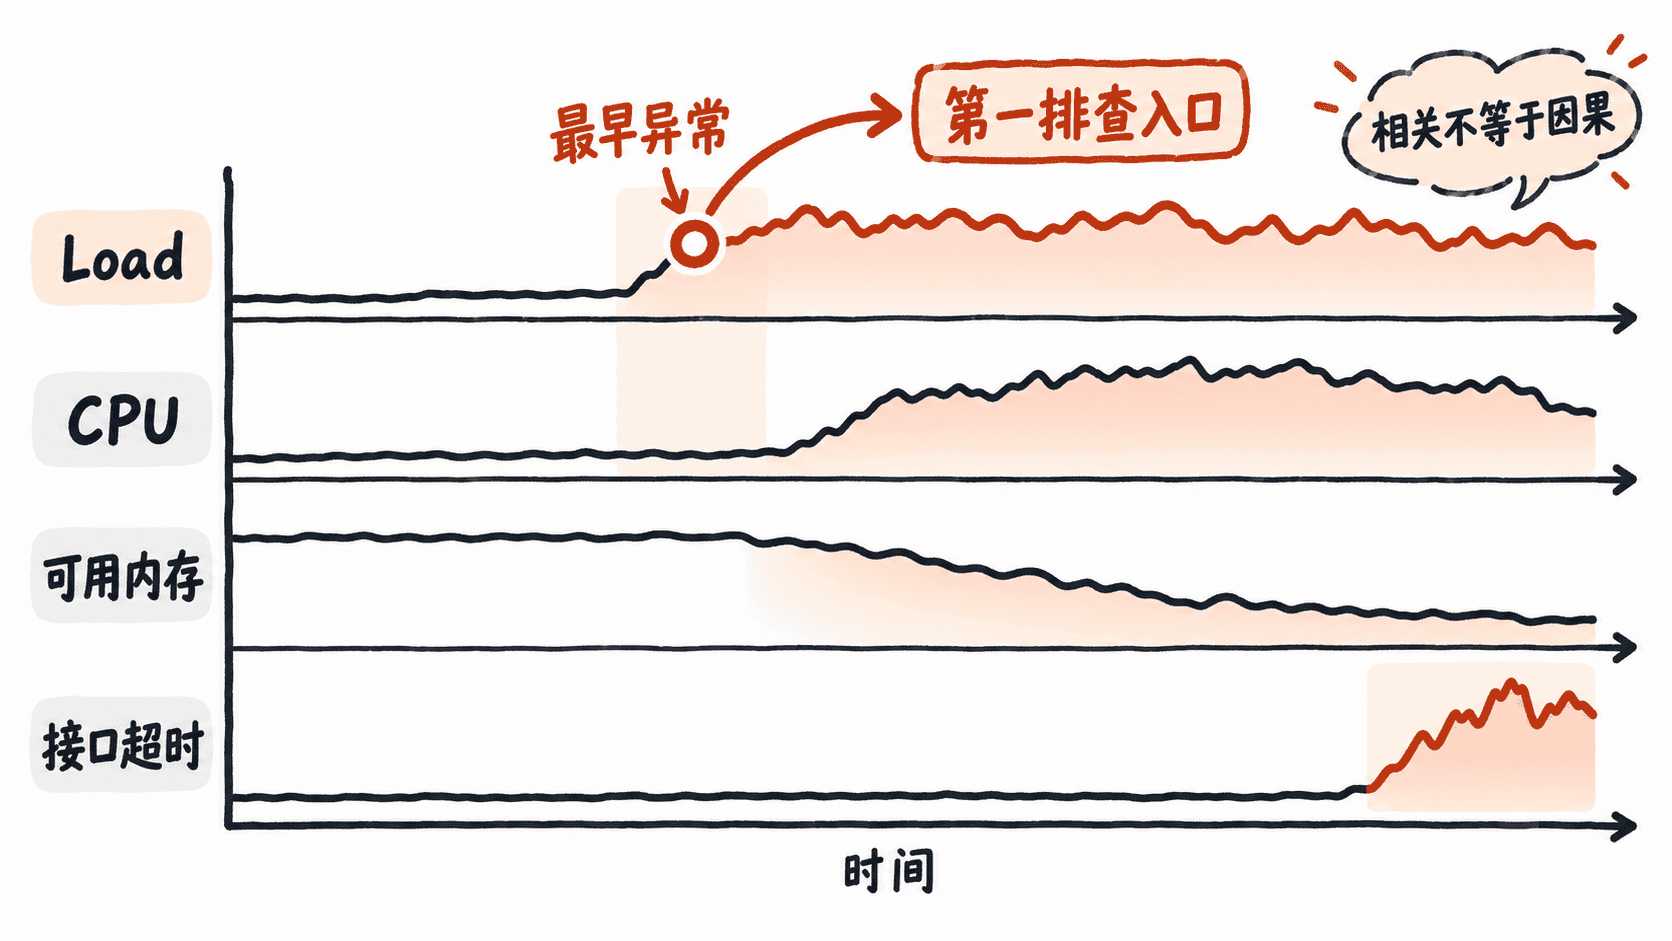
整理时间线时至少记录告警开始时间、恢复时间、持续时长以及是否反复抖动。真正有价值的是“谁先变化、谁后变化”,而不是只比较峰值大小。
用第一批命令建立系统快照
第一轮命令要满足两个条件:读取成本低,并且能同时覆盖负载、内存、调度与连接概况。下面这组命令适合在故障仍然存在时先做快照。
date -Is
uptime
free -h
vmstat 1 5
ss -s
预期输出(示例,时间与数值会因机器而异):
<TIME>
 <TIME> up <DAYS> days,  load average: 8.20, 7.10, 4.30
               total        used        free      shared  buff/cache   available
Mem:            16Gi        12Gi       620Mi       <SIZE>       <SIZE>       <SIZE>
Swap:          <SIZE>      <SIZE>      <SIZE>
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
 9  0  <N>   <N>    <N>   <N>     0    0   <N>   <N>  <N>  <N> 70 20  8  2  0
Total: <N>
TCP:   <N> (estab <N>, closed <N>, orphaned <N>, timewait <N>)
uptime 先确认 Load 的 1、5、15 分钟趋势;free -h 看 available 和 Swap,而不是只盯 free;vmstat 用 r、b、si/so、wa 区分 CPU 排队、阻塞、换页与 IO 等待;ss -s 只用于快速判断连接规模是否异常,不负责证明网络就是根因。
根据组合信号选择下一入口
如果 vmstat 的 r 持续偏高,同时 CPU 的 us+sy 很高、wa 很低,下一步应查热点进程和线程。若 Load 高但 CPU 空闲仍较多,且 b、wa 同时升高,应转向磁盘或远端存储等待。若 si/so 持续出现,先处理内存压力,因为换页本身会制造额外 IO。
接口超时若与系统资源异常同步出现,不要立刻把它归因于网络。先确认服务器是否已经因为 CPU、IO 或内存压力而无法及时调度应用线程,再决定是否继续进入连接、丢包、DNS 或下游依赖排查。
保留现场再做变更
第一轮排查阶段尽量避免直接执行重启、清缓存、杀进程或手工删日志。这些操作可能让服务暂时恢复,却会破坏故障证据。至少应先记录时间线、保存关键命令输出,并明确当前最可疑的资源方向,再进行有目的的修复或降级。
当第一批快照能够把问题归到 CPU、IO、内存或连接中的一类时,排查入口就算选对了;若多类指标同时异常,则继续依据“最早异常”和上下游依赖关系缩小范围,而不是同时在所有方向上展开。