
Linux 与服务器运维 / 系统课时
先判断应用问题还是系统问题
先判断应用问题还是系统问题
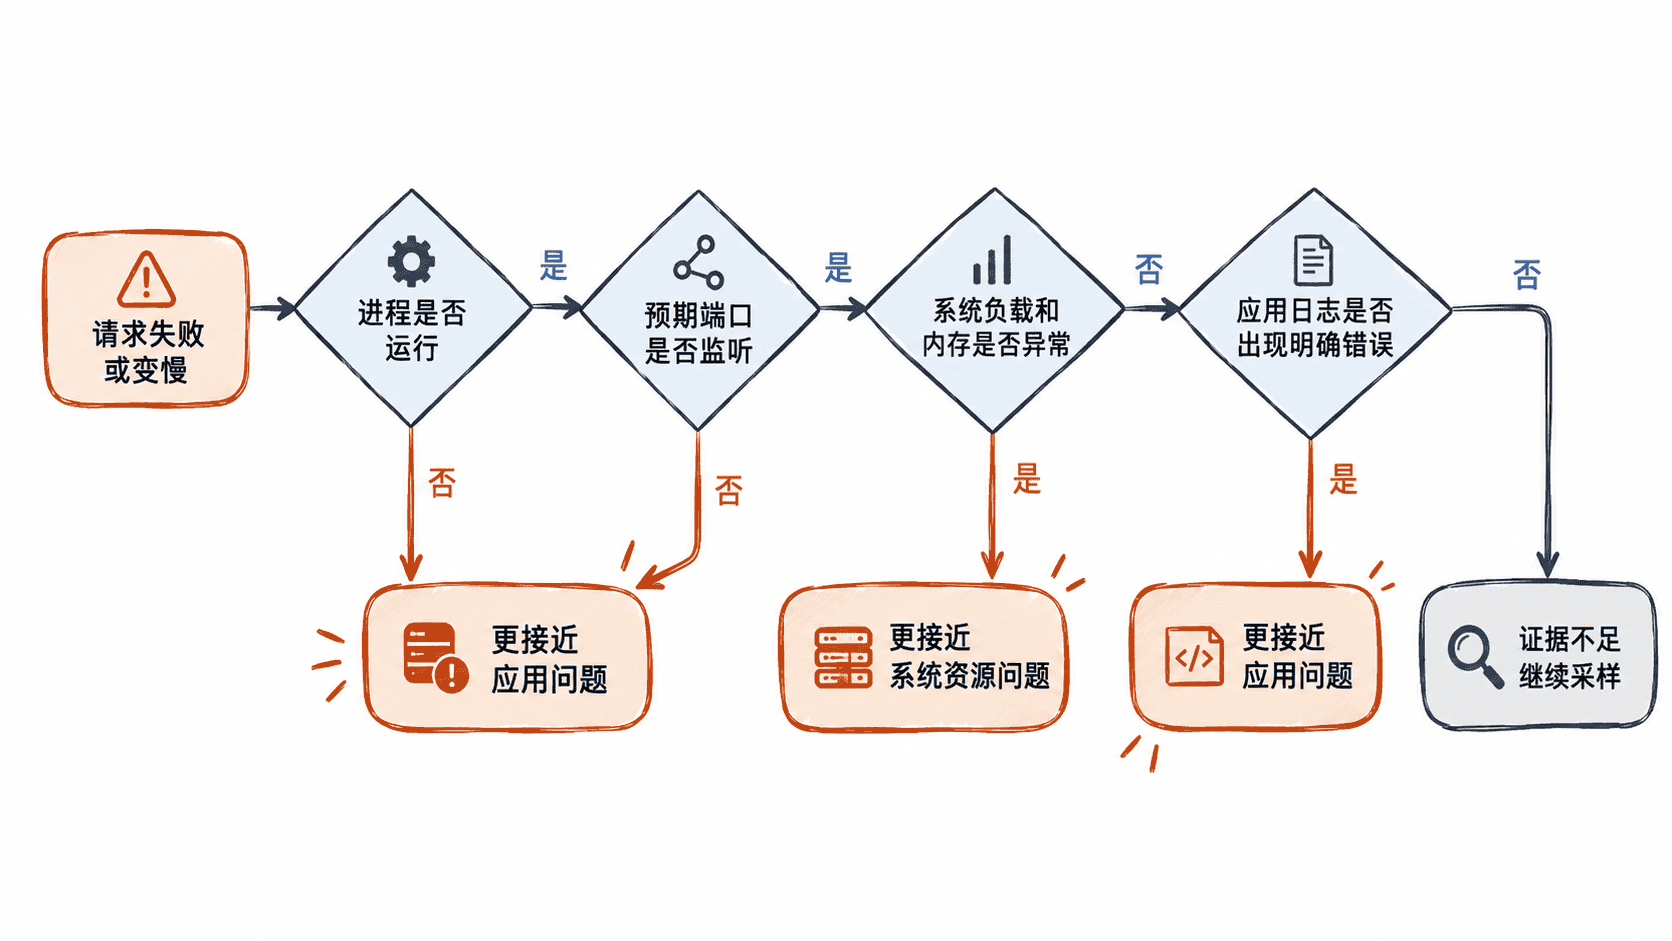
应用报错不等于操作系统有故障,系统负载升高也不一定是根因。本节用进程状态、端口监听、系统负载和应用日志建立一条判断链,先确定异常更靠近应用自身还是 Linux 资源层,再决定后续排查深度。
学习目标
- 能用进程、端口、负载和日志四类证据判断问题归属
- 能识别“应用未运行”和“系统资源异常”这两类典型现象
- 能在证据不足时避免过早下结论
先检查应用是否真的在工作
判断应用问题时,第一步不是看整机 CPU,而是确认目标进程是否存在、是否持续运行,以及预期端口是否监听。进程退出、反复重启或端口根本没有监听,通常应先沿应用启动和配置方向排查。
对于由 systemd 管理的服务,可以先查看状态;对于任意服务,再用 ss 验证端口。若进程存在但没有监听预期端口,还要检查绑定地址、启动参数和应用日志。
用四类证据做一次交叉判断
下面以 systemd 管理的 nginx 为例,检查服务状态、80 端口、系统负载和最近错误日志。若现场使用其他服务,应替换服务名和端口。
systemctl is-active nginx
ss -lntp '( sport = :80 )'
uptime
journalctl -u nginx -p err -n 5 --no-pager
预期输出(示例场景为 Nginx 未成功运行,时间和日志内容会因环境不同而变化):
inactive
State Recv-Q Send-Q Local Address:Port Peer Address:Port Process
<TIME> up <TIME>, <N> users, load average: <LOAD1>, <LOAD5>, <LOAD15>
<TIME> <HOST> nginx[<ID>]: <ERROR_MESSAGE>
这个结果中,服务为 inactive,80 端口没有监听,而系统负载没有直接显示出资源耗尽证据,问题就更接近应用启动失败。下一步应优先阅读错误日志、检查配置并尝试启动服务,而不是先调系统内核参数。
什么情况更像系统问题
如果应用进程和端口都正常,但多个互不相关的服务同时变慢,且系统出现高负载、可用内存快速下降、磁盘空间耗尽或大量 I/O 等待,问题更可能位于系统资源层。此时应继续检查 CPU 调度、内存回收、磁盘 I/O、文件系统和网络栈。
相反,如果只有一个服务异常,系统资源总体平稳,并且日志明确给出配置错误、依赖连接失败、权限错误或未捕获异常,应优先处理应用自身。范围是否跨应用是非常有价值的判断线索。
不要用单个指标定责
高 CPU 可能是应用死循环造成的,也可能只是业务流量突然增加;端口监听正常,只能说明进程接受连接,并不能证明业务接口可用;日志没有报错,也可能是日志级别、磁盘写入或日志路径本身有问题。
当证据相互矛盾时,不要急着贴“应用问题”或“系统问题”的标签,应扩大时间窗口、补充监控和日志,并检查最近发布或配置变更。故障归属是排查过程中的工作假设,不是凭单一命令得到的最终结论。