
Linux 与服务器运维 / 系统课时
日志没有报错就真的没问题吗
日志没有报错就真的没问题吗
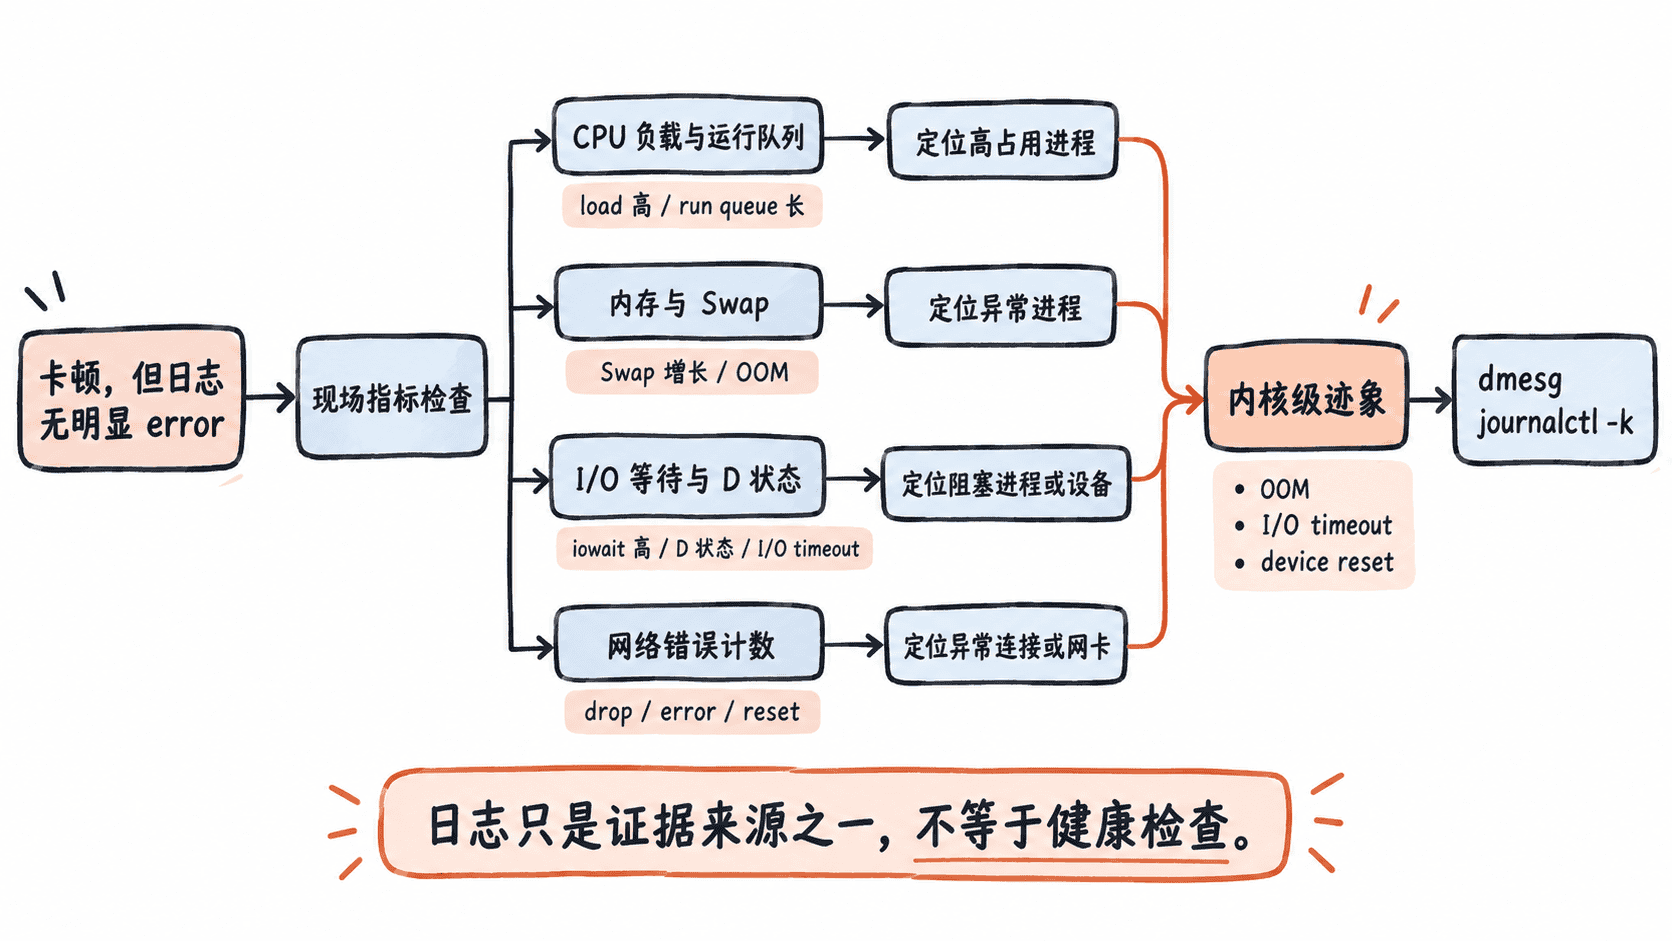
没有 error 日志不等于系统健康。CPU 饱和、内存回收、Swap 抖动、进程长时间处于不可中断睡眠等情况,往往在系统已经明显变慢时仍不会主动记录错误,因此排障必须把日志与现场指标、进程状态一起看。
学习目标
- 理解为什么部分性能和资源问题不会生成明显错误日志
- 能用负载、内存、
vmstat和进程状态快速判断资源瓶颈 - 能判断什么时候需要从指标异常继续追到内核日志
为什么日志可能保持安静
日志通常记录“发生了某个事件”,而性能问题常常只是系统持续处于合法但不理想的状态。例如 CPU 一直满载并不违反内核规则,内存回收也可能只是正常机制;只有到了 OOM、设备超时或驱动错误等阈值,才更可能出现明确日志。
先看现场指标
下面的命令只使用常见的 procps 与 coreutils 工具,适合在“系统慢但日志没报错”时快速建立现场快照。
bash
printf '== load ==\n'
uptime
printf '\n== memory ==\n'
free -h
printf '\n== vmstat ==\n'
vmstat 1 5
printf '\n== top processes ==\n'
ps -eo pid,stat,comm,%cpu,%mem --sort=-%cpu | head -n 8
预期输出(数值因机器和负载不同而变化):
text
== load ==
<TIME> up <UPTIME>, <USERS> users, load average: <LOAD1>, <LOAD5>, <LOAD15>

== memory ==
Mem: <TOTAL> <USED> <FREE> <SHARED> <BUFF_CACHE> <AVAILABLE>
Swap: <TOTAL> <USED> <FREE>

== vmstat ==
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
<ROW>
<ROW>

== top processes ==
PID STAT COMMAND %CPU %MEM
<ID> <STAT> <COMMAND> <CPU> <MEM>
这里不要只盯着单个数字,而要找能互相印证的组合信号。一次采样偏高可能只是瞬时波动,连续多个采样都异常才更有定位价值。
没有错误时怎么解释这些信号
| 现场信号 | 更可能说明什么 |
|---|---|
load 持续升高,vmstat 的 r 长期高于可用 CPU 数量 |
CPU 竞争或大量可运行任务排队 |
available 很低,同时 si、so 持续非零 |
内存压力明显,系统正在频繁换入换出 |
vmstat 的 b 持续大于 0,进程大量处于 D 状态 |
任务在等待不可中断 I/O,需继续查存储或设备 |
| 单个进程长期占高 CPU | 更像应用自身计算热点,而不是内核异常 |
ps 的 STAT 也很有用:R 表示正在运行或等待 CPU,S 多为可中断睡眠,D 表示不可中断睡眠。少量短暂 D 不一定异常,但如果大量进程长期停在 D,而系统同时有明显 I/O wait,就应该进一步追设备和内核信息。
什么时候再回到 dmesg
如果现场已经指向内存耗尽、设备 I/O、网卡异常或进程被突然杀死,再去检查 dmesg 或 journalctl -k,通常能得到更直接的内核级证据。相反,如果只是某个进程把 CPU 用满,内核日志完全没有 error 也很正常。
因此“日志没有报错”只能排除一部分已经被记录的异常,不能作为系统健康结论。可靠的排障顺序是先确认现象,再看资源指标和进程状态,最后根据线索决定是否深入内核、设备或应用层。
按自己的节奏,确认真正理解。