
Linux 与服务器运维 / 系统课时
线上故障应该先看什么
线上故障应该先看什么
线上故障发生时,最容易犯的错误是直接打开 top 猜 CPU 问题。更稳妥的做法是先固定故障时间、影响范围和用户可见现象,再用少量系统证据判断应该继续查 CPU、内存、磁盘、网络还是应用本身。
学习目标
- 能先记录故障时间、影响用户和异常表现,避免无方向排查
- 能用一组基础命令快速建立系统资源快照
- 能根据证据选择下一条排查路径,而不是逐项碰运气
先把故障边界说清楚
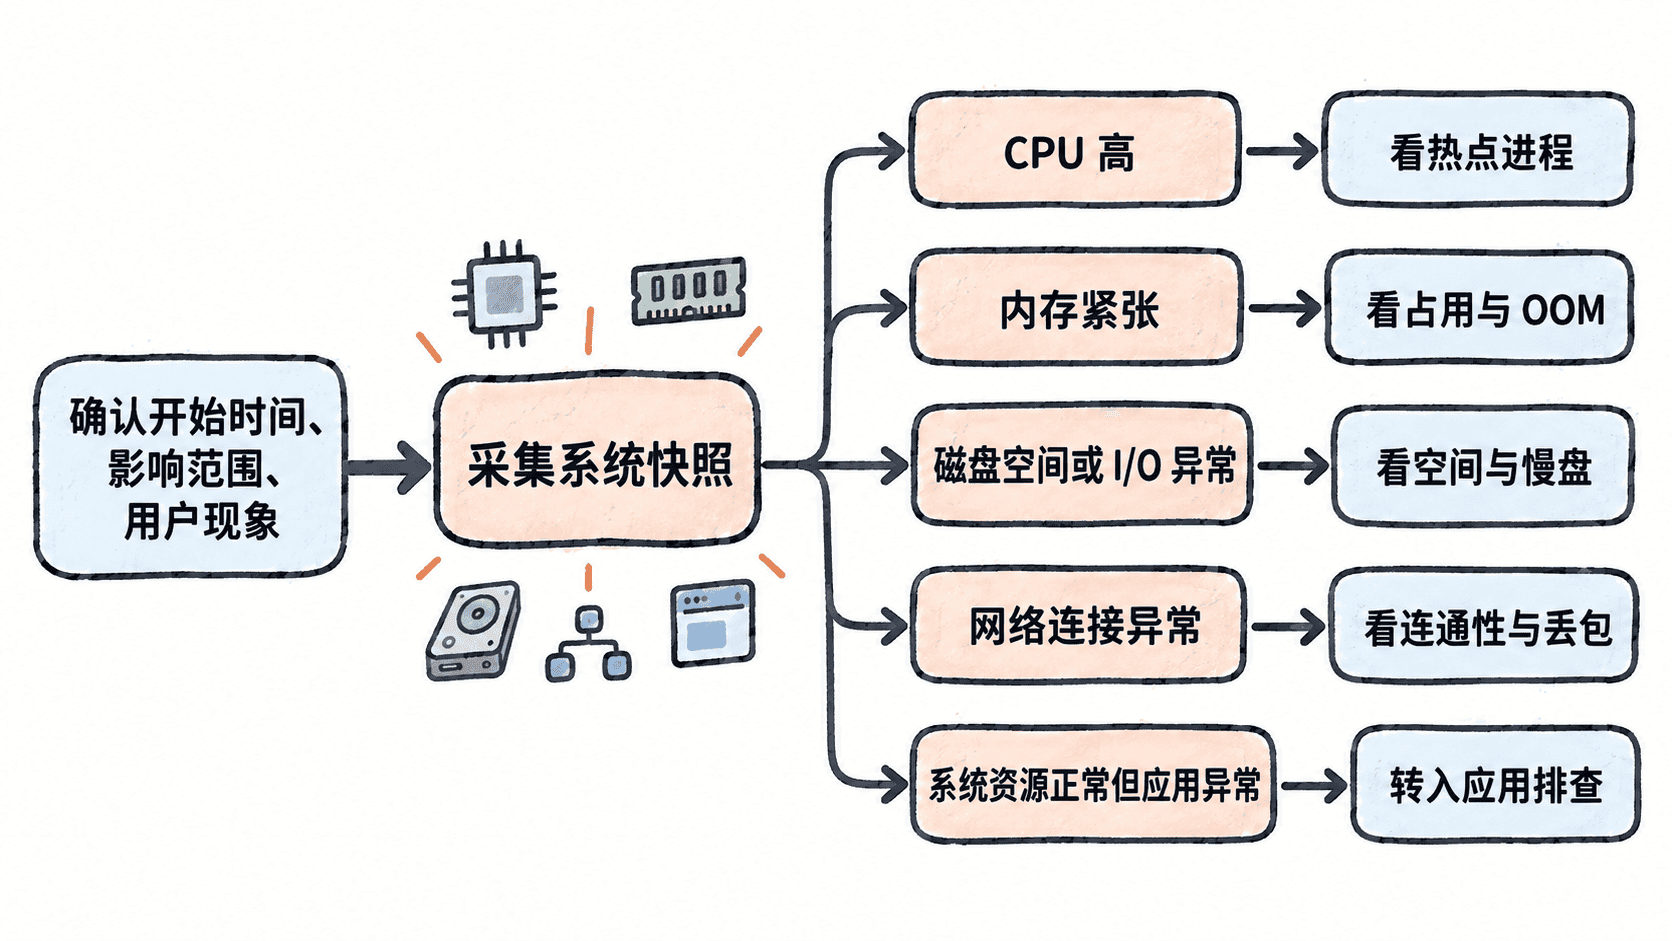
开始敲命令前,先回答三个问题:什么时候开始、影响谁、表现是什么。例如“04:10 起所有用户访问超时”与“只有某个租户提交订单失败”代表完全不同的排查方向。
时间用于和日志、监控、发布记录对齐;影响范围用于判断是单实例、单机房还是全局问题;异常表现则决定优先检查连接失败、响应慢、进程退出还是资源耗尽。没有这三个信息,后面的 CPU、内存和网络数据很容易被误读。
用最小快照判断系统是否失衡
先采集当前时间、负载、内存、根分区空间和连接概况。下面这组命令适合故障刚发生时快速留证,数值会随主机实时状态变化。
date
uptime
free -h
df -h /
ss -s
预期输出(示意,实际时间、容量和连接数可能不同):
<TIME>
<TIME> up <TIME>, <N> users, load average: <LOAD1>, <LOAD5>, <LOAD15>
               total        used        free      shared  buff/cache   available
Mem:           <SIZE>      <SIZE>      <SIZE>      <SIZE>      <SIZE>      <SIZE>
Filesystem      Size  Used Avail Use% Mounted on
<DEVICE>        <SIZE> <SIZE> <SIZE> <PERCENT> /
Total: <N>
TCP:   <N> (estab <N>, closed <N>, orphaned <N>, timewait <N>)
uptime 只说明负载趋势,不等于 CPU 一定打满;free -h 更应关注 available 而不是单看 free;df -h / 能快速发现根分区是否逼近满盘;ss -s 适合判断连接量是否异常增大。快照的目的不是立刻定责,而是排除明显失衡。
按现象选择下一条路径
如果负载持续升高,再结合 top 或 pidstat 找高 CPU 或不可中断睡眠进程;如果 available 很低且出现交换或 OOM 迹象,应转向内存排查;如果分区接近 100% 或 I/O 等待明显升高,应检查磁盘空间、inode 和存储延迟。
如果系统资源看起来正常,但请求仍超时或报错,应继续检查监听端口、连接建立、DNS、路由以及应用日志。尤其不要因为“CPU 不高”就直接判定网络故障,也不要因为“load average 高”就立刻重启服务。
先留证,再做有破坏性的动作
重启进程、清缓存、删除日志或扩容都可能让现象暂时消失,同时抹掉根因证据。至少先保存故障时间点附近的应用日志、系统日志和资源快照,再执行恢复动作。
首轮排查的关键不是一次找到根因,而是用最少信息把问题缩小到正确方向:资源、网络、磁盘或应用。这样下一步检查才有明确目的。