
Linux 与服务器运维 / 系统课时
为什么不能只盯着一个指标
为什么不能只盯着一个指标
故障排查最危险的做法之一,是把某个“看起来很高”的数字直接当作根因。Linux 的负载、Swap、I/O wait、CPU 和进程状态彼此关联,同一个现象可能由不同原因触发。本节用几个常见组合说明如何通过交叉指标判断真正的压力来源。
学习目标
- 理解“异常指标”与“故障根因”不是同一件事
- 能把负载、CPU、Swap、I/O 和进程状态组合起来判断
- 能识别常见的误判模式,并选择下一步验证命令
单个数字为什么会误导
以 load average 为例,Linux 负载统计的不只是正在占用 CPU 的任务,也包括处于不可中断睡眠状态的任务。因此“负载高”既可能是 CPU 竞争,也可能是存储 I/O 阻塞。只看 uptime 无法区分这两种情况。
Swap 也类似。系统存在一定 Swap 使用量,并不等于当前正在发生内存抖动;真正需要关注的是是否持续发生换入换出,以及应用是否同时出现延迟、回收压力或 OOM。磁盘 I/O 也是如此,吞吐量高可能只是正常批处理,是否构成故障还要结合等待情况和业务响应。
用一组命令做交叉验证
遇到“机器很慢”或“负载突然升高”时,可以先用下面这组命令同时观察负载、调度、内存和高消耗进程。
uptime
vmstat 1 5
free -h
ps -eo pid,comm,%cpu,%mem,state --sort=-%cpu | head
预期输出
 <TIME> up <TIME>,  <N> users,  load average: <LOAD1>, <LOAD5>, <LOAD15>

procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
 <N> <N> <N>   <N>    <N>   <N>    <N>  <N>   <N>   <N>  <N>  <N> <N> <N> <N> <N> <N>

               total        used        free      shared  buff/cache   available
Mem:           <SIZE>      <SIZE>      <SIZE>      <SIZE>      <SIZE>      <SIZE>
Swap:          <SIZE>      <SIZE>      <SIZE>

    PID COMMAND         %CPU %MEM S
   <ID> <COMMAND>       <N>  <N>  <STATE>
这些值本身没有统一的“故障阈值”,关键是看组合关系和连续采样趋势。
三种常见误判
负载高不一定是 CPU 满
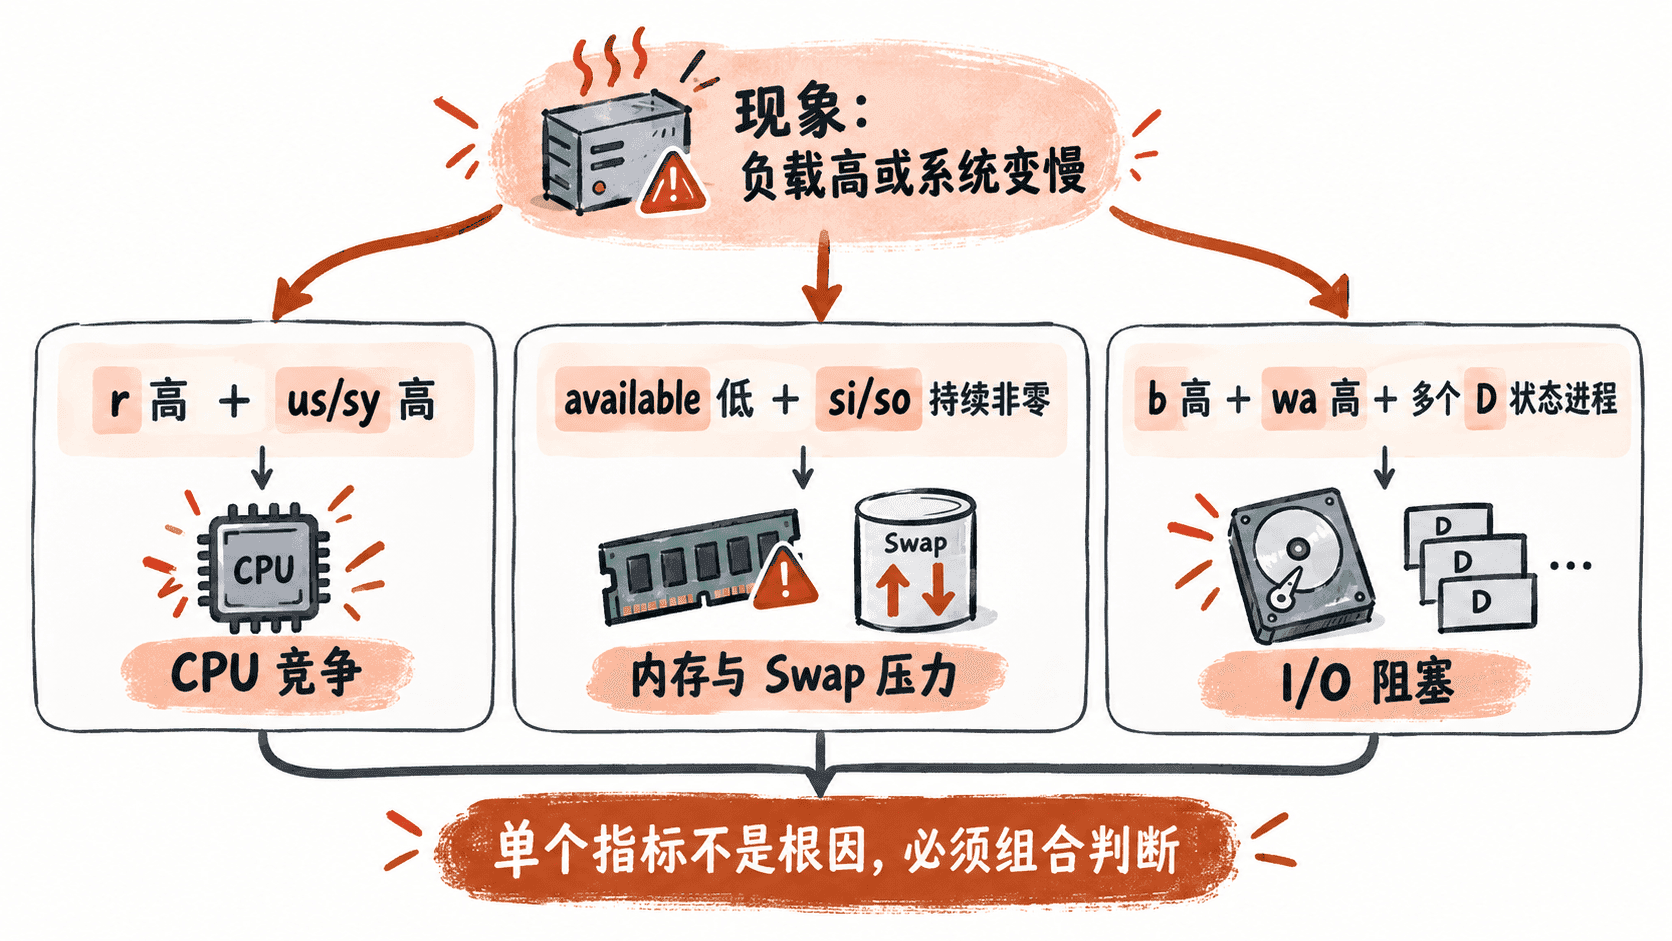
如果 load average 很高,同时 vmstat 的 r 持续高、us 与 sy 也高、id 处于低位,那么 CPU 竞争是合理的怀疑方向。此时再用进程列表定位谁在持续消耗 CPU。
如果负载高,但 r 不高,反而 b 和 wa 持续偏高,并且多个进程处于 D 状态,就更像 I/O 阻塞。此时继续盯 CPU 百分比只会偏离问题。
Swap 已用不等于正在抖动
free -h 显示 Swap 已使用,只说明部分页面曾被换出。判断当前是否有 Swap 压力,应结合 vmstat 的 si、so。如果它们在连续采样中长期接近 0,系统可能只是保留了历史换出的冷页。
相反,如果 available 很低,si、so 持续非零,而且业务延迟同步上升,就应该继续排查哪些进程占用内存,以及是否存在内存泄漏或工作集超过物理内存。
I/O wait 高需要继续找谁在等
wa 高表示 CPU 有一部分时间在等待 I/O,但它仍然只是现象。下一步应确认是否有大量 D 状态进程,以及问题集中在磁盘、网络文件系统还是其他块设备路径。若只是一次短暂峰值,不应仅凭单个采样判定存储故障。
建立现象、证据与根因链条
排障时可以把判断写成一句完整的话:现象是什么,哪些独立指标支持它,什么证据还能排除其他解释。 例如,“负载高”只是现象;“r 持续高、CPU 空闲率低、某进程长期占用大量 CPU”才构成更强的 CPU 竞争证据。
真正可靠的排障不是寻找一个万能数字,而是把多个指标拼成一致的因果链。指标之间如果互相矛盾,先解释矛盾,再继续取证;这往往比立刻“修复”更接近真正根因。