
Linux 与服务器运维 / 系统课时
TIME_WAIT 很多一定有问题吗
TIME_WAIT 很多一定有问题吗
看到服务器上成千上万个 TIME_WAIT,并不能直接判定网络异常。它是 TCP 正常关闭流程的一部分,真正需要判断的是:这些连接是否持续快速产生、是否正在消耗本机临时端口,以及应用是否已经出现连接失败、延迟升高等实际症状。
学习目标
- 理解
TIME_WAIT为什么存在以及通常出现在哪一侧 - 用连接数量和本机临时端口范围判断是否存在资源压力
- 区分正常的短连接现象与需要优化的异常连接模式
TIME_WAIT 是正常的连接状态
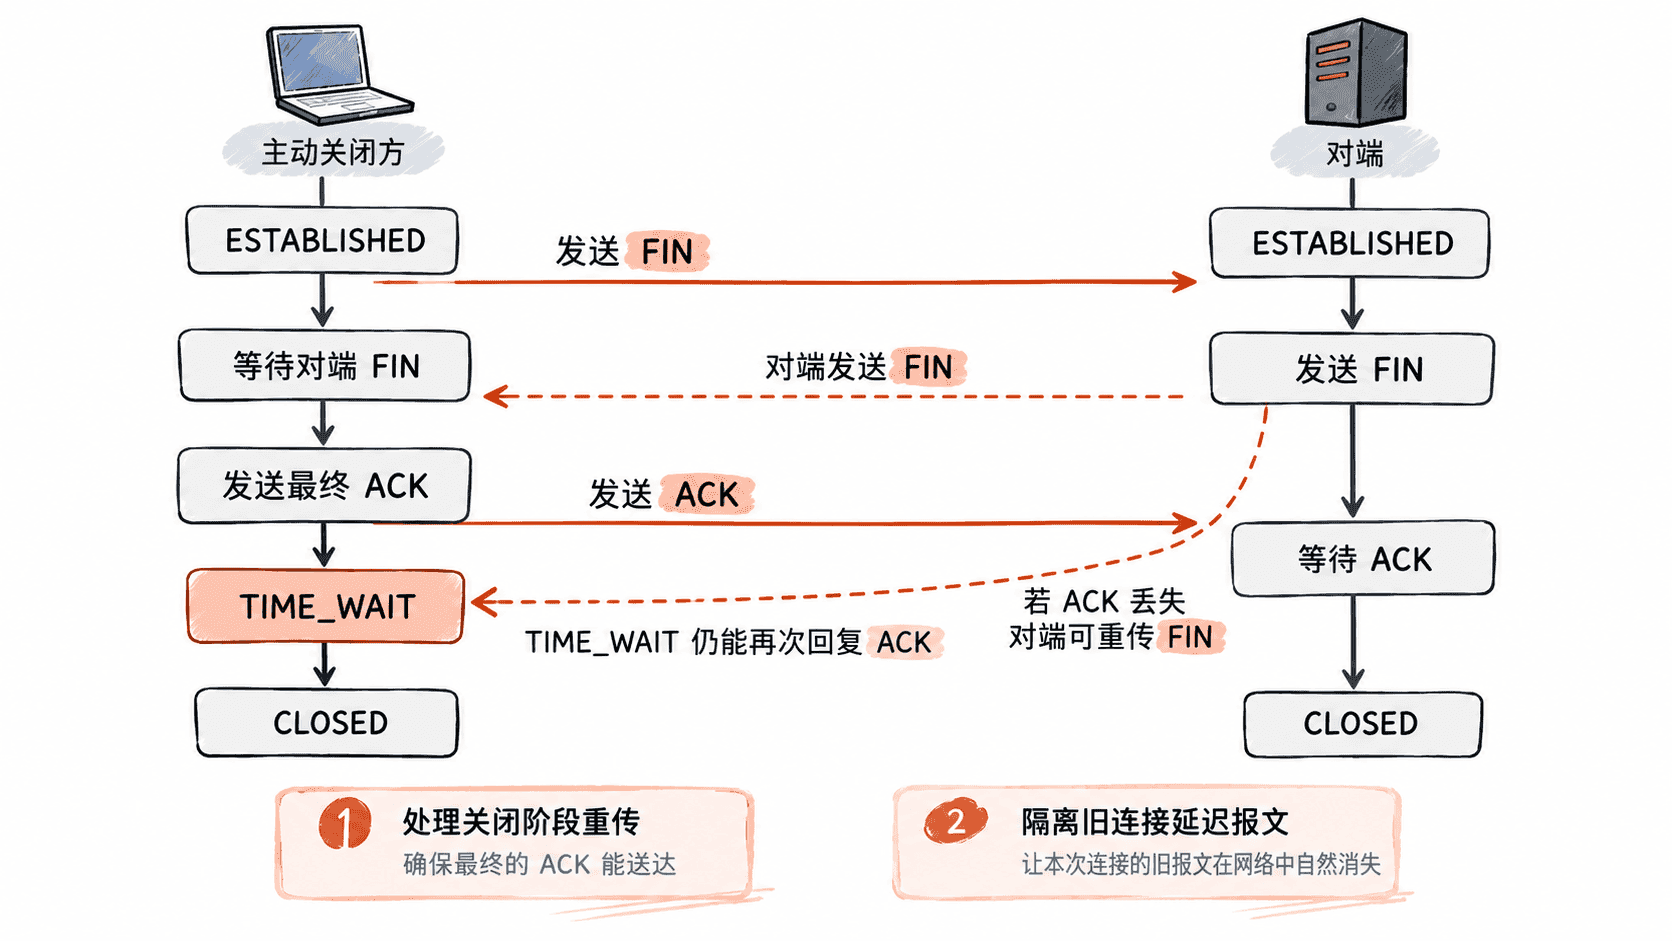
TCP 主动关闭连接的一方在完成挥手后,通常不会立刻彻底丢弃连接状态,而是进入 TIME_WAIT 保留一段时间。这样既能处理对端因最后确认丢失而重传的报文,也能降低旧连接的延迟报文被后续同一四元组连接误认的风险。
因此,Web 网关、代理、API 客户端或任何大量主动关闭短连接的程序,都可能积累很多 TIME_WAIT。数量大只说明近期结束的连接多,不等于这些连接正在占用应用工作线程,也不等于服务器已经故障。
先看数量,再看端口资源
可以直接统计当前 TIME_WAIT 数量,并查看 Linux 为主动发起连接准备的本地临时端口范围。输出会随机器负载和系统配置变化,因此用占位符表示动态值。
ss -tan state time-wait | wc -l
cat /proc/sys/net/ipv4/ip_local_port_range
预期输出类似:
<COUNT>
<LOW>    <HIGH>
第一行只是一个瞬时数量。第二行给出本机自动分配源端口时使用的默认临时端口范围。单看 <COUNT> 仍不足以判断故障,还要结合连接建立速率、目标地址分布和应用错误。
什么情况下才值得处理
如果业务运行正常,连接成功率、延迟和吞吐都稳定,即使 TIME_WAIT 较多,也通常不需要专门清理。内核会按 TCP 生命周期自动回收这些状态。
更值得关注的是以下组合现象:应用持续高频创建短连接;大量连接都从同一源地址访问同一目标;新连接开始失败;客户端日志出现本地端口不足或连接建立异常;连接池、HTTP Keep-Alive 或上游复用机制实际上没有生效。
此时问题往往不是“TIME_WAIT 没清掉”,而是连接创建模式产生了过高的端口和握手开销。应优先确认应用是否本可以复用连接,却在每个请求后都重新建立 TCP 连接。
看连接产生速度比看快照更有价值
可以间隔一段时间重复统计,观察数量是稳定波动还是持续上升。下面命令本身可直接执行,其中 <TIME> 表示实际记录时间,属于输出中的动态值。
printf '%s ' "$(date '+%F %T')"
ss -tan state time-wait | wc -l
预期输出:
<TIME> <COUNT>如果高峰期数量升高、流量下降后又自然回落,并且没有连接失败,通常属于正常短连接行为。反之,如果数量长期处在高位,同时新建连接失败或端口资源接近耗尽,就应继续追查哪个进程和哪个上游在制造大量短连接。
优先优化连接方式,不要先改内核参数
常见改善手段是启用或修复连接复用,例如 HTTP Keep-Alive、数据库连接池、代理到上游的持久连接,并检查超时配置是否导致连接被过早关闭。这些措施直接减少新 TCP 连接数量,也能同时降低握手、端口和 CPU 开销。
判断 TIME_WAIT 是否有问题,应把状态数量、连接产生速率、临时端口范围和真实故障现象放在一起看。没有资源耗尽和连接失败时,它通常只是 TCP 正常完成连接关闭留下的短期状态。