
Linux 与服务器运维 / 系统课时
traceroute 能告诉我们什么
traceroute 能告诉我们什么
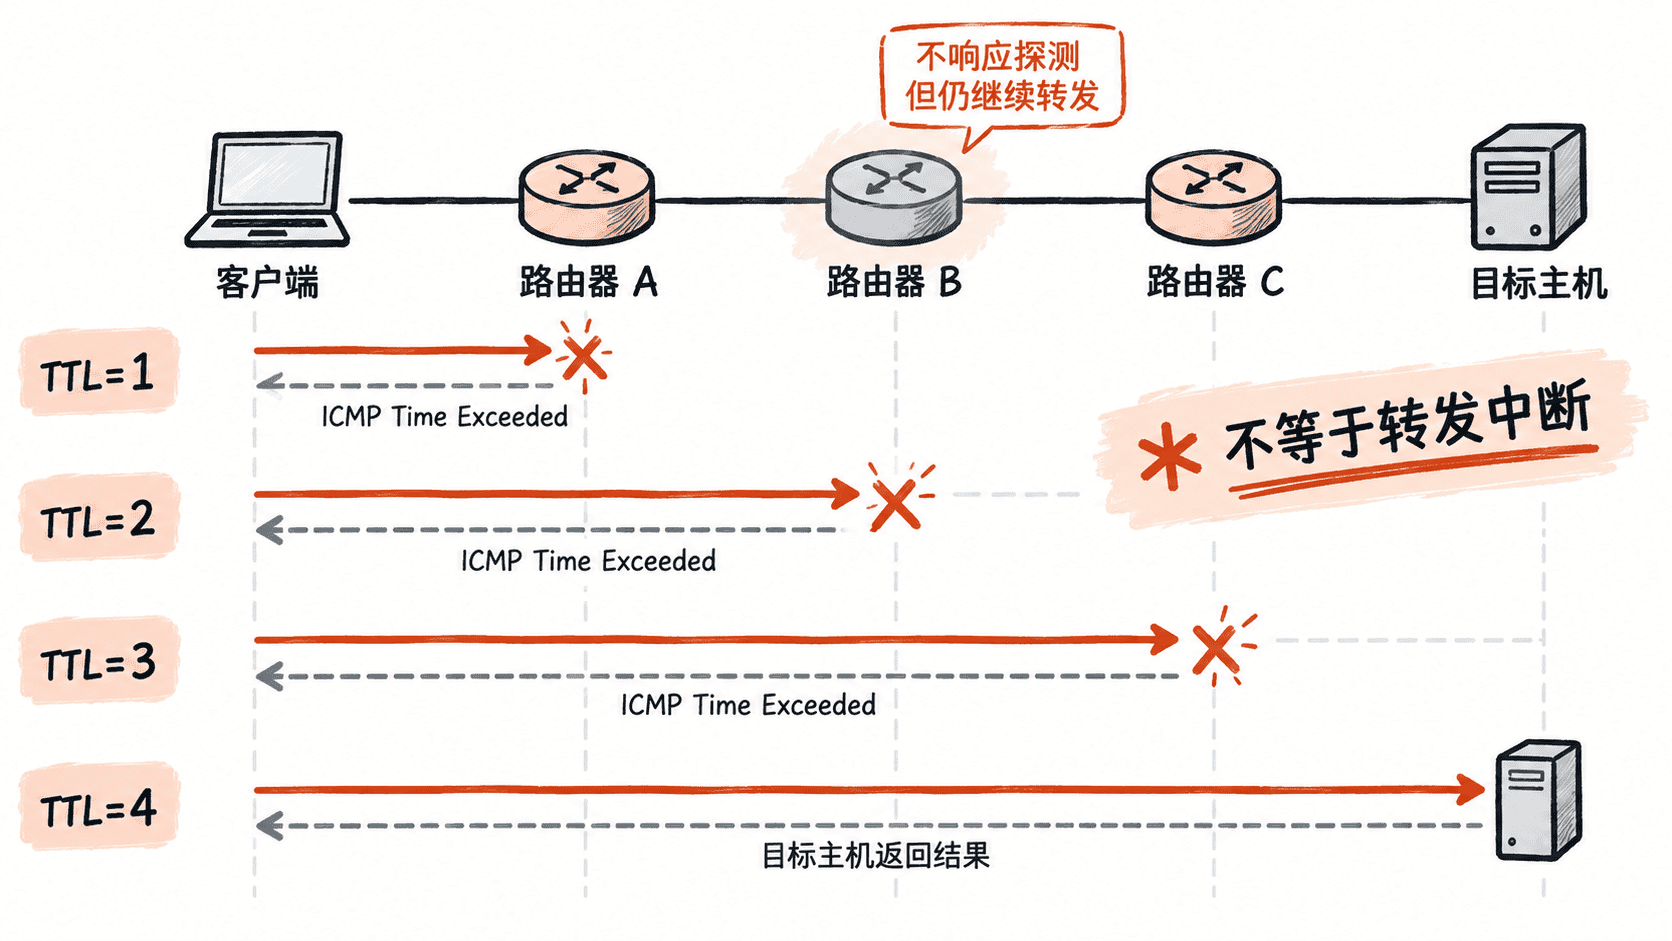
traceroute 用递增 TTL 的探测包观察数据包沿途经过的网络跳点,适合判断路径大致在哪里发生变化。但中间某一跳不回复并不等于流量在那里中断,必须结合后续跳点与其他连通性测试一起判断。
学习目标
- 理解
traceroute为什么能逐跳显示网络路径。 - 正确解读正常延迟、星号和路径变化。
- 知道什么时候切换 ICMP 或 TCP 探测方式辅助判断。
traceroute 如何逐跳看到路径
IP 包的 TTL 每经过一个三层转发设备就会减 1。traceroute 先发送 TTL 为 1 的探测包,再逐步增加 TTL;当 TTL 归零时,中间路由器通常返回 ICMP Time Exceeded,于是工具就能记录这一跳的地址和往返时间。
运行一次基础路由跟踪
先把 <HOST> 替换为真实目标。-n 禁止反向 DNS 查询,避免域名解析延迟干扰观察;-w 1 把单次等待时间设为 1 秒;-q 1 每跳只发一个探测包,适合快速排查。
traceroute -n -w 1 -q 1 <HOST>预期输出(结构示例,真实跳数、地址和延迟会不同):
traceroute to <HOST> (<IP>), 30 hops max, 60 byte packets
 1  <IP>  1.2 ms
 2  *
 3  <IP>  8.7 ms
 4  <IP>  12.4 ms
这里第 2 跳是 *,但第 3、4 跳仍有响应,因此第 2 跳显然仍在转发数据,只是没有返回探测所期待的 ICMP 消息,或该响应被限速、过滤了。
星号该怎么解释
连续星号只表示“当前探测方式没有收到这一跳的可见响应”,原因可能是路由器不回 ICMP Time Exceeded、控制平面限速、防火墙过滤,或者回程路径不同。只有在某一跳之后所有后续跳点都消失,并且目标端口测试也失败时,才更有理由把故障范围收缩到该位置附近。
延迟突然升高也不要仅凭单个节点下结论。某些路由器会降低对控制报文的处理优先级,导致自己这一跳的 RTT 很高,但后续节点仍然正常。判断真正的数据转发性能,应结合 ping、应用请求或持续监控结果。
切换探测协议验证过滤差异
Linux 上常见的 traceroute 默认使用 UDP 探测。若怀疑中间设备对 UDP、ICMP 或特定端口有不同策略,可以切换探测方式;具体可用选项取决于安装的 traceroute 实现与权限。
traceroute -I -n <HOST>
traceroute -T -p 443 -n <HOST>
预期结果:如果默认 UDP 被过滤,而 ICMP 或 TCP/443 可通过,后两种探测可能显示更多可响应跳点;如果路径策略相同,三种方式看到的路径通常相近,但不保证完全一致。
把路径信息和端口测试结合起来
traceroute 最适合回答“流量大致经过哪里、从哪一段开始看不到响应”,而不是证明某个具体端口一定可用。最终仍要用 nc、curl 等工具验证目标服务端口和应用协议。
当路径中间出现星号但目标端口仍能正常连接时,应把星号视为观测限制,而不是故障证据;当后续跳点全部消失且多种探测协议、目标端口测试都失败时,再结合本机路由、防火墙、VPN、云安全策略和网络侧日志继续缩小范围。