
Linux 与服务器运维 / 系统课时
怎么从请求 ID 串起一条故障链路
怎么从请求 ID 串起一条故障链路
当一次请求经过网关、业务服务和下游依赖后失败,只看某一台机器的错误日志通常无法确定故障发生在哪里。本节用请求 ID 把分散日志还原成一条时间链,判断请求经过了哪些服务、在哪一步开始异常,以及哪些日志只是后续连锁反应。
学习目标
- 使用同一个请求 ID 在多个服务日志中定位同一次调用
- 按时间和调用关系还原跨服务故障链路
- 识别请求 ID 中断、重复或未透传导致的排查盲区
请求 ID 为什么能串起多份日志
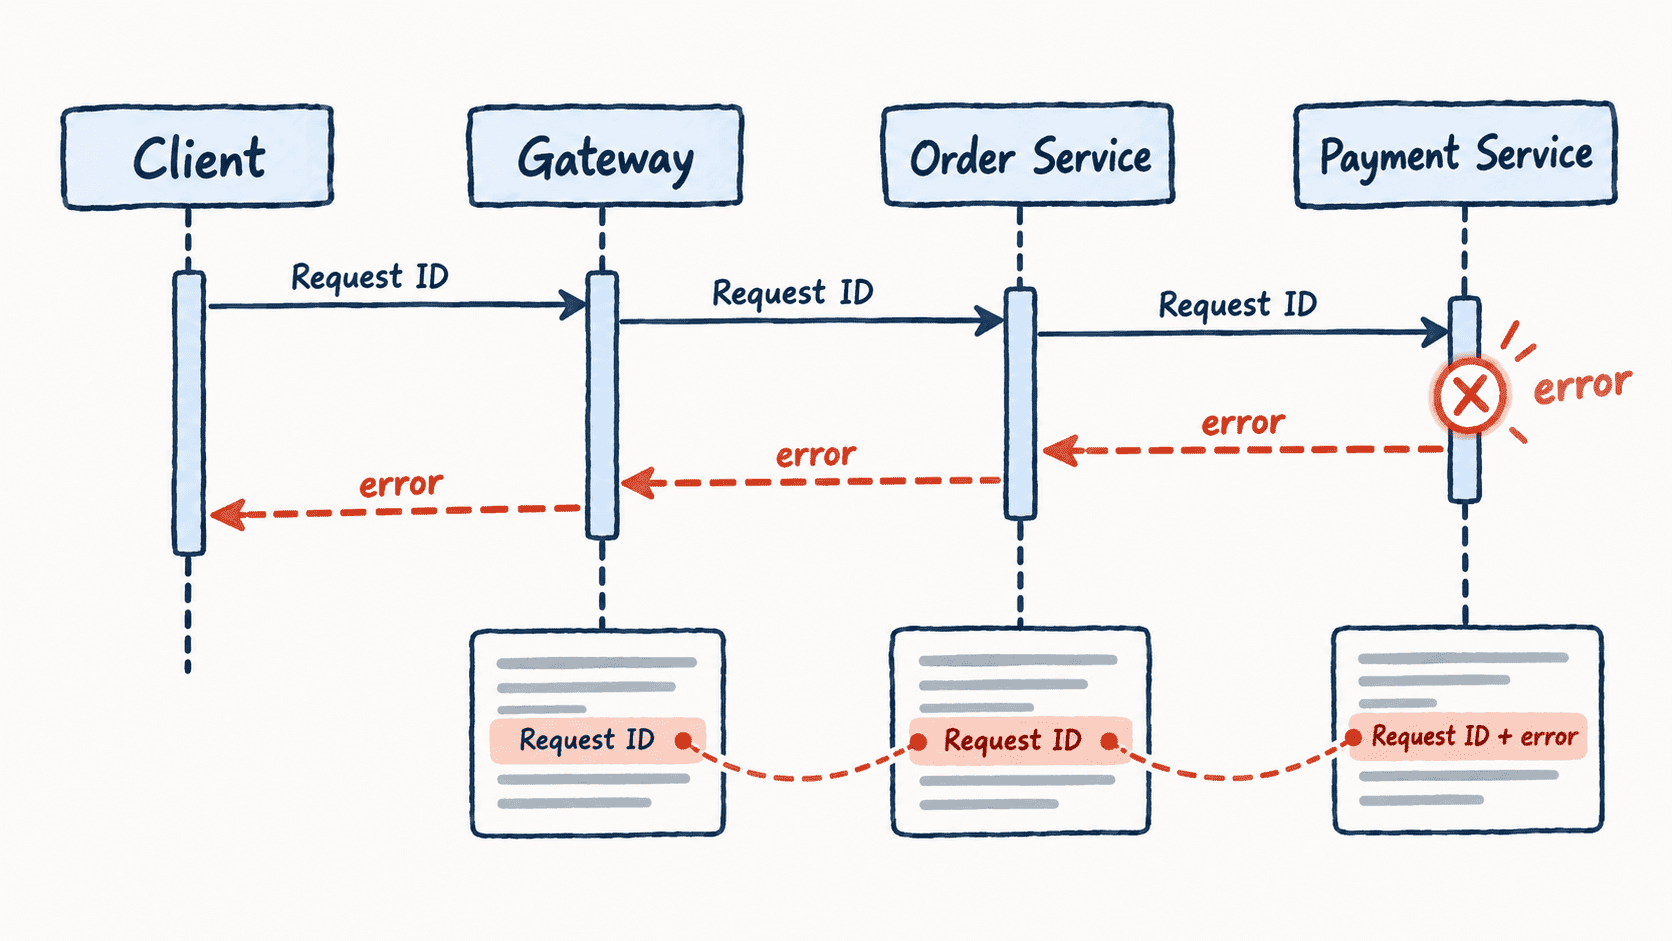
一次外部请求可能先进入网关,再调用订单服务、支付服务和数据库。不同进程各写自己的日志,仅靠时间搜索会混入大量并发请求;如果入口为请求生成唯一标识,并在后续调用中持续透传,各服务又把该标识写入日志,就能把属于同一次请求的记录筛选出来。
常见做法是在 HTTP 请求头中传递类似 X-Request-ID 的字段,或者由链路追踪系统维护 trace ID。字段名并不固定,排查前应先确认当前系统真正记录的是 request_id、trace_id 还是其他名称。
从入口日志开始搜索
先取得用户报错对应的请求 ID,再从入口服务开始搜索。下面假设三个服务分别把日志写入 /var/log/gateway/app.log、/var/log/order/app.log 和 /var/log/payment/app.log,实际环境应替换成真实路径。
REQUEST_ID='<ID>'
grep -HF "$REQUEST_ID" \
  /var/log/gateway/app.log \
  /var/log/order/app.log \
  /var/log/payment/app.log
预期输出中应看到同一个请求 ID 出现在多个服务;时间、接口、耗时等值会随实际请求变化。
/var/log/gateway/app.log:<TIME> INFO request_id=<ID> method=POST path=/orders
/var/log/order/app.log:<TIME> INFO request_id=<ID> calling payment service
/var/log/payment/app.log:<TIME> ERROR request_id=<ID> payment provider timeout
这里的 <ID> 和 <TIME> 都是动态值。若只在网关日志中出现而后续服务完全没有记录,优先检查请求是否真的转发成功,以及请求 ID 是否在跨服务调用时被透传。
按调用顺序而不是只看错误级别
拿到匹配日志后,应先还原请求经过的顺序,再判断第一处异常。一个实用的阅读顺序是:入口是否收到请求、上游是否发起下游调用、下游是否收到调用、哪一层最先出现失败、失败如何返回上游。
例如支付服务首先记录超时,随后订单服务记录支付失败,最后网关返回 500,那么订单服务和网关的错误通常是后果,支付调用超时才是当前链路中更早的异常点。不要仅因为网关日志最后出现 ERROR,就把入口层当作根因。
还要比较相邻日志的时间差。如果订单服务发起支付调用后隔了约 30 秒才记录失败,而支付服务根本没有对应请求,则应继续检查网络、DNS、连接建立或中间代理,而不是只搜索应用异常栈。
请求 ID 断链时怎么处理
最常见的盲区是某一跳没有继续传递标识。此时可以用上游记录的目标地址、接口、时间窗口和业务对象 ID 缩小范围,但这些条件都可能匹配多个并发请求,因此只能作为辅助证据。
如果经常发生断链,应从系统设计上修复:入口统一生成或规范化请求标识,调用下游时自动透传,并让日志框架在每条关键日志中写入同一字段。这样故障发生后,排查动作才能从“猜时间和机器”变成沿一条可验证的请求链逐跳定位。