
Linux 与服务器运维 / 系统课时
Swap 持续增长该怎么判断
Swap 持续增长该怎么判断
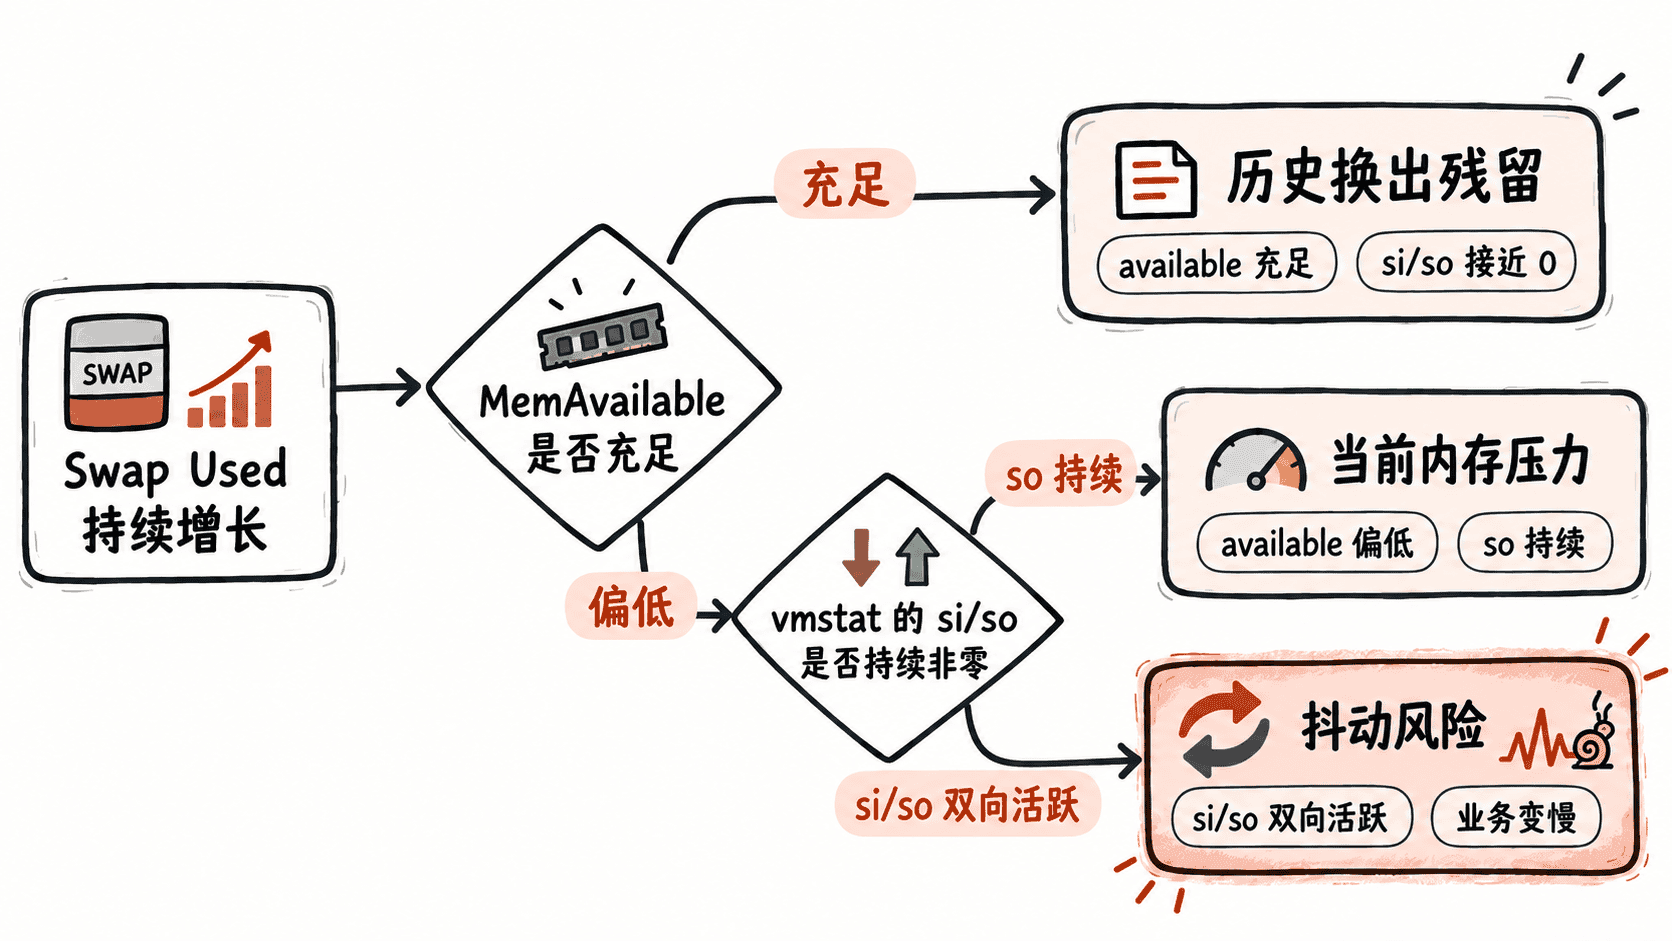
Swap 已使用量持续变大,并不等于系统此刻一定缺内存。排查的关键是把 available、Swap 占用和 si/so 换入换出趋势放在一起看,区分“历史上换出去但暂未收回的冷页”和“当前仍在持续发生的内存压力”。
学习目标
- 理解 Swap 已用量与实时内存压力不是同一个指标
- 使用
free、swapon和vmstat判断系统是否正在持续换页 - 根据
available、si/so的组合决定是否继续定位高内存进程
先判断“用了 Swap”还是“正在换页”
Linux 在一次内存紧张后,可能把较少访问的匿名页留在 Swap 中。即使后来物理内存已经恢复充足,这些页面也不会为了让 Swap 数字变小而立即全部换回。因此,只看到 Swap Used 增长,不能直接认定故障仍在持续。
free 中更值得关注的是 available,它估算了在不触发大量换页的情况下还能提供给新进程的内存。vmstat 的 si 和 so 则反映采样期间的换入和换出活动:so 持续出现说明内核仍在把页面换出,si 持续出现说明进程又在访问先前被换出的页面。
用一组命令抓现场
先连续采样,而不是只截取一个瞬时值。下面的命令同时查看物理内存、Swap 设备和 5 次换页采样。
printf '== memory ==\n'
free -h
printf '== swap ==\n'
swapon --show
printf '== paging ==\n'
vmstat 1 5
预期输出
== memory ==
               total        used        free      shared  buff/cache   available
Mem:           <TOTAL>      <USED>      <FREE>    <SHARED> <CACHE>      <AVAILABLE>
Swap:          <SWAP_TOTAL> <SWAP_USED> <SWAP_FREE>

== swap ==
NAME      TYPE      SIZE        USED        PRIO
<PATH>    <TYPE>    <SIZE>      <USED>      <PRIO>

== paging ==
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
<sample values...>
<sample values...>
<sample values...>
<sample values...>
<sample values...>
实际容量和采样数值会不同。重点不是某一行的绝对值,而是连续几行中 si、so 是否反复出现,以及此时 available 是否已经明显偏低。
按组合结果下结论
| 现象 | 更合理的判断 |
|---|---|
Swap 已用较高,available 充足,si/so 长时间接近 0 |
多半是历史压力留下的冷页,当前未必有持续内存压力 |
available 持续走低,so 连续非零 |
内核仍在回收并换出页面,应继续找内存增长来源 |
si 突然升高,但 available 仍充足 |
可能是进程重新访问已换出的页面,属于工作集回暖,不一定代表压力恶化 |
si、so 都频繁活跃,同时 I/O 等待和响应时间升高 |
可能出现换页抖动,内存工作集已超过可承受范围 |
判断时要看几分钟到更长时间的趋势。一次短暂 so 峰值可能只是瞬时回收;持续多轮采样非零才更值得追踪。
继续定位占用内存的进程
如果 available 低且 so 持续,下一步按 RSS 排序找当前主要内存消费者。
ps -eo pid,comm,rss,vsz,%mem --sort=-rss | head -n 15预期输出
    PID COMMAND           RSS      VSZ %MEM
   <ID> <PROCESS>      <RSS_KB> <VSZ_KB> <PCT>
   <ID> <PROCESS>      <RSS_KB> <VSZ_KB> <PCT>
   ...
这里先关注 RSS 大且仍在增长的进程,再结合业务指标、进程自身堆信息或 /proc/<PID>/status 继续确认。VSZ 很大并不等于同样多的物理内存已经被占用。
不要为了“清空 Swap”直接关闭交换空间
全量关闭 Swap 会尝试把已换出的页面重新装回内存。如果物理内存本来就紧张,这个动作可能放大压力,甚至直接触发 OOM。排障目标应是确认系统是否仍在换页、找出工作集为何超过可用内存,而不是把 Swap Used 数字强行归零。
只要 available 仍有余量、si/so 长时间接近 0、业务延迟正常,Swap 保留一部分已用空间通常可以接受;真正需要处理的是持续换出、可用内存下降和业务性能同时恶化的组合。