
容器与云原生 / 系统课时
排查 503 与端点不可达
排查 503 与端点不可达
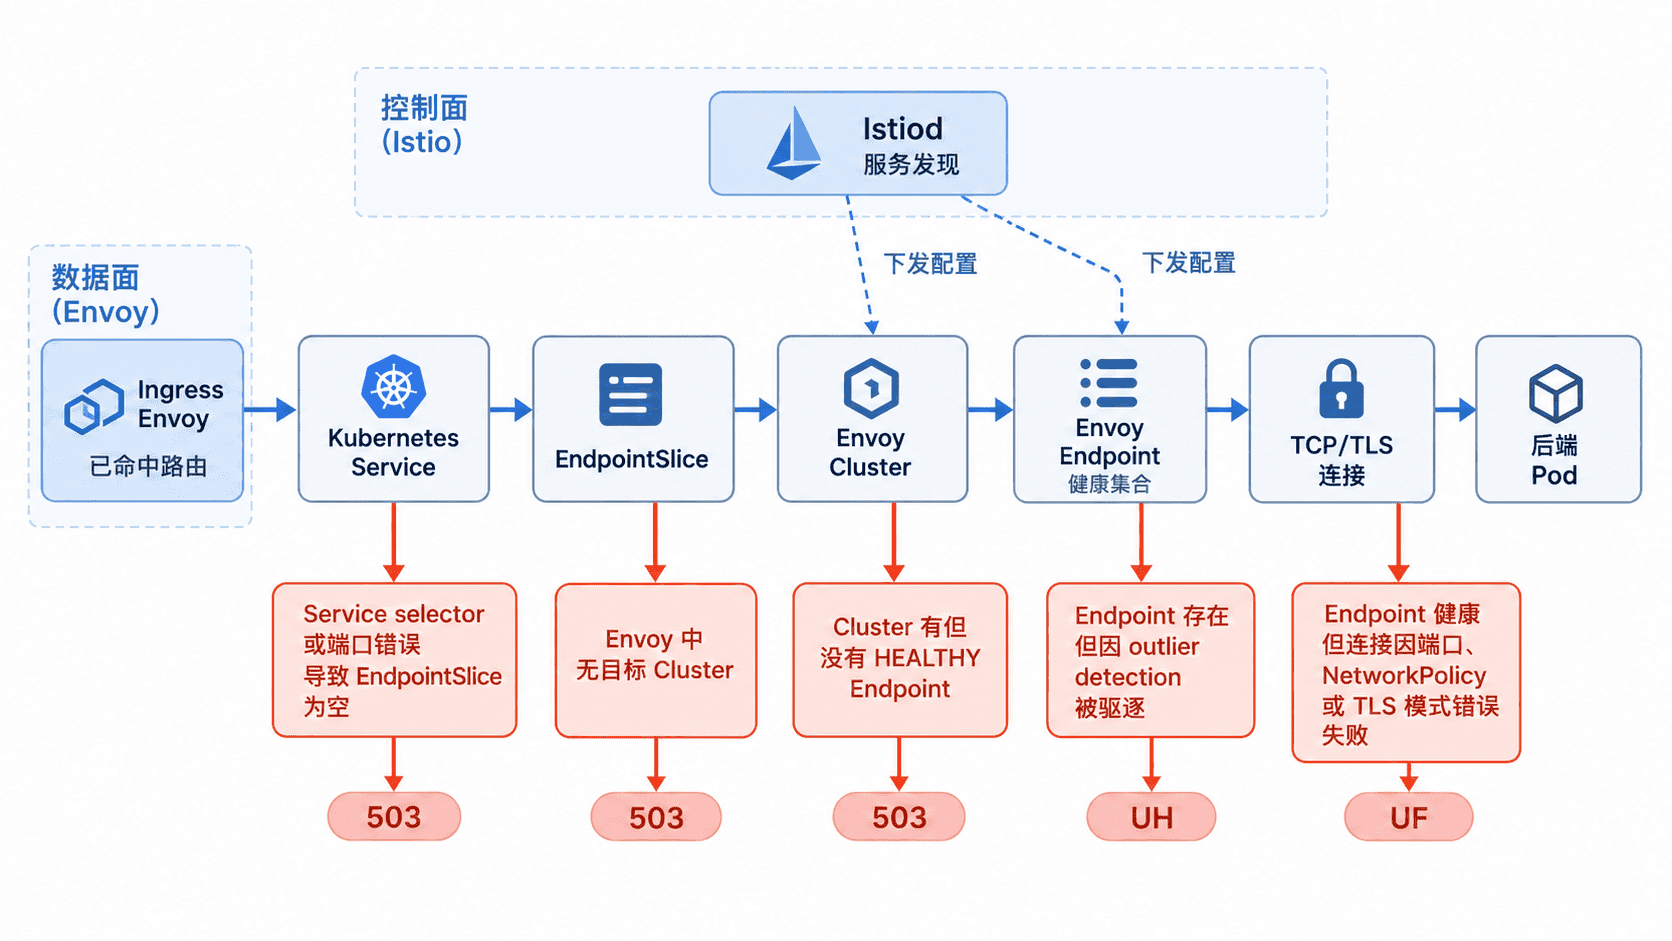
入口出现 503 时,先判断响应是否由 Envoy 在选择或连接上游阶段产生,再沿“Service → EndpointSlice → Envoy Cluster → Envoy Endpoint → 实际连接”逐层收敛。目标不是只确认 Pod 存活,而是找出数据面为什么没有可用上游。
学习目标
- 能根据 Envoy 响应标志区分无健康上游、连接失败和上游溢出
- 能对照 Kubernetes 服务发现与
istioctl proxy-config的数据面视图 - 能在端点存在时继续定位异常驱逐、网络连通性和 TLS 问题
先确认 503 发生在哪一层
先固定一条可稳定复现的入口请求,并结合入口网关访问日志查看 %RESPONSE_FLAGS%。下面以 api.example.com/orders 为例;实际入口 IP、响应头和响应体会因环境而不同。
INGRESS_IP='<IP>'
curl -i -H 'Host: api.example.com' "http://${INGRESS_IP}/orders"
预期输出
HTTP/1.1 503 Service Unavailable
<HEADERS>

<VALUE>
若访问日志中的响应标志为 UH、UF 或 UO,通常分别表示没有健康上游、连接上游失败、上游资源溢出。若 503 明确由业务应用返回,而不是 Envoy 生成,就应转向应用自身排障,不要继续沿服务发现链路误查。
从 Service 和 EndpointSlice 排除发现问题
先确认路由目标 Service 的 selector、服务端口和 EndpointSlice。Service 存在但没有可用端点时,Envoy 最终也无法获得可选工作负载;常见根因包括标签不匹配、Pod 未 Ready、工作负载缩容为零,或端口映射配置错误。
kubectl -n demo get service orders -o wide
kubectl -n demo get endpointslice -l kubernetes.io/service-name=orders -o wide
预期输出
NAME     TYPE        CLUSTER-IP   EXTERNAL-IP   PORT(S)    AGE       SELECTOR
orders   ClusterIP   <IP>         <none>        8080/TCP   <VALUE>   app=orders

NAME          ADDRESSTYPE   PORTS   ENDPOINTS                 AGE
orders-<ID>   IPv4          8080    10.42.1.21,10.42.2.18     <VALUE>
若 EndpointSlice 没有地址,或端点条件显示未就绪,先修 Kubernetes 服务发现,再谈 Istio 的重试、熔断或流量策略。修复 selector、readiness、端口或副本数后,应先看到可用端点重新出现。
核对 Envoy 的 Cluster 和 Endpoint
Kubernetes 中存在端点,不代表入口 Envoy 已收到同样的数据面配置。先按服务 FQDN 查询目标 Cluster;Istio 的出站 Cluster 名通常包含方向、端口、subset 和服务 FQDN。
istioctl proxy-config clusters deployment/istio-ingressgateway.istio-system --fqdn orders.demo.svc.cluster.local预期输出
SERVICE FQDN                    PORT   SUBSET   DIRECTION   TYPE
orders.demo.svc.cluster.local   8080   -        outbound    EDS
如果没有结果,优先检查路由目标主机、Service 名称与命名空间、配置可见范围以及控制面同步。若使用了 subset,查询 Endpoint 时要换成实际 Cluster 名,不要机械照抄空 subset。
istioctl proxy-config endpoints deployment/istio-ingressgateway.istio-system --cluster 'outbound|8080||orders.demo.svc.cluster.local'预期输出
ENDPOINT          STATUS    OUTLIER CHECK   CLUSTER
10.42.1.21:8080   HEALTHY   OK              outbound|8080||orders.demo.svc.cluster.local
10.42.2.18:8080   HEALTHY   OK              outbound|8080||orders.demo.svc.cluster.local
Cluster 存在但没有 Endpoint 时,应继续检查 Istiod 的服务发现结果与 EndpointSlice 是否一致;Endpoint 已存在却不可用时,则把重点转向异常驱逐、连接失败和策略约束。
端点存在仍 503 时检查连接与策略
健康 Endpoint 仍持续 503,说明问题已经从“有没有地址”收敛到“能否建立可用连接”。此时依次检查应用监听端口、NetworkPolicy、TLS、连接池和异常驱逐,避免先扩大超时掩盖真实连接错误。
先读取本服务的 DestinationRule。-o yaml 会返回资源 YAML,而不是人为拼接的字段摘要;下面使用动态占位符表示每个集群都会变化的元数据。
kubectl -n demo get destinationrule orders -o yaml预期输出
apiVersion: networking.istio.io/v1
kind: DestinationRule
metadata:
  creationTimestamp: <TIME>
  generation: <VALUE>
  name: orders
  namespace: demo
  resourceVersion: <VALUE>
  uid: <ID>
spec:
  host: orders.demo.svc.cluster.local
  trafficPolicy:
    tls:
      mode: ISTIO_MUTUAL
实际资源不一定显式配置 trafficPolicy.tls,也可能包含 connectionPool 或 outlierDetection。排障时应按真实 YAML 核对这些字段,不要把示例字段当成固定模板。
再确认命名空间内是否有 NetworkPolicy 限制网关到业务工作负载的流量。
kubectl -n demo get networkpolicy -o wide预期输出
NAME                   POD-SELECTOR   AGE
allow-orders-ingress   app=orders     <VALUE>
若命名空间没有 NetworkPolicy,命令会提示没有资源;若存在,则继续核对其 ingress/egress 规则是否允许网关访问 orders 的实际端口。UF 更应关注监听端口、网络可达性和 TLS 握手,UH 更应关注 Endpoint 健康与异常驱逐;被异常驱逐的主机即使仍出现在 EndpointSlice 中,也可能暂时不参与负载均衡。
修复后做控制面与数据面双重验收
修复后按同一路径反向验收:先确认 Kubernetes 端点恢复,再确认入口 Envoy 中至少有一个健康 Endpoint,最后重放原始业务请求。只看到 Pod Ready,不能证明入口链路已经恢复。
INGRESS_IP='<IP>'
kubectl -n demo get endpointslice -l kubernetes.io/service-name=orders -o wide
istioctl proxy-config endpoints deployment/istio-ingressgateway.istio-system --cluster 'outbound|8080||orders.demo.svc.cluster.local'
curl -i -H 'Host: api.example.com' "http://${INGRESS_IP}/orders"
预期输出
NAME          ADDRESSTYPE   PORTS   ENDPOINTS   AGE
orders-<ID>   IPv4          8080    <IP>        <VALUE>

ENDPOINT       STATUS    OUTLIER CHECK   CLUSTER
<IP>:8080      HEALTHY   OK              outbound|8080||orders.demo.svc.cluster.local

HTTP/1.1 200 OK
<HEADERS>

<VALUE>
如果 Cluster 与 Endpoint 都正确且健康,却仍持续出现 UF,排查范围已经收敛到真实连接路径,应集中检查网络可达性、TLS 握手和上游监听,而不是继续修改服务发现配置。