
容器与云原生 / 系统课时
配置地域感知流量
配置地域感知流量
地域感知流量解决“同一服务跨地域部署后,请求优先去哪儿、故障后退到哪儿”的问题。本课用 locality、distribute 与 failover 建立策略,并通过检查代理端点、缩减本地域端点和完全停掉本地域端点,完成正常、部分故障、跨地域切换与恢复验收。
学习目标
- 读懂 region、zone、subzone 组成的 locality,并确认调用方与服务端点具有可区分的地域信息。
- 区分
distribute的比例分配与failover的故障优先级切换。 - 配置跨地域 failover,并用实际请求计数和停端点操作验证正常、部分故障、跨 region 与恢复状态。
确认 locality 与端点信息
Istio 以 region/zone/subzone 表示地域。Kubernetes 环境通常从 Node 的 topology.kubernetes.io/region、topology.kubernetes.io/zone 获取前两级信息;需要 subzone 时可使用 topology.istio.io/subzone。调用方所在地域决定“从哪里发起”,目标端点的地域决定“有哪些本地或远端候选”。
先确认调用方和后端分别落在哪些 Node,并检查这些 Node 的地域标签:
kubectl get pod -l 'app in (caller,catalog)' -o custom-columns=NAME:.metadata.name,APP:.metadata.labels.app,NODE:.spec.nodeName
kubectl get nodes -L topology.kubernetes.io/region,topology.kubernetes.io/zone,topology.istio.io/subzone
预期输出:
NAME              APP       NODE
caller-<ID>       caller    <NODE-WEST>
catalog-<ID>      catalog   <NODE-WEST>
catalog-<ID>      catalog   <NODE-EAST>

NAME          STATUS   REGION     ZONE      SUBZONE
<NODE-WEST>   Ready    us-west1   zone-a    <VALUE>
<NODE-EAST>   Ready    us-east1   zone-a    <VALUE>
实际 Pod、Node 名称与 subzone 值会不同。若 REGION 或 ZONE 为空,应先补齐 Node 拓扑标签并让工作负载重新调度;只给 Pod 增加一个业务用的 region 标签,并不能替代 Istio 使用的 locality 元数据。
还要从调用方代理视角确认 catalog 的 EDS 端点确实带有 locality。下面使用 sidecar 模式下的调用方 Pod;若实验环境采用其他数据面模式,应改为对应代理的配置检查方式。
CALLER_POD=$(kubectl get pod -l app=caller -o jsonpath='{.items[0].metadata.name}')
istioctl proxy-config endpoints "$CALLER_POD" -n default --cluster 'outbound|80||catalog.default.svc.cluster.local' -o json | jq '.. | objects | select(has("locality") and has("lbEndpoints")) | {locality, addresses: [.lbEndpoints[]?.endpoint.address.socketAddress.address]}'
预期输出:
{
  "locality": {
    "region": "us-west1",
    "zone": "zone-a"
  },
  "addresses": [
    "<IP>"
  ]
}
{
  "locality": {
    "region": "us-east1",
    "zone": "zone-a"
  },
  "addresses": [
    "<IP>"
  ]
}
只要能看到本地与远端端点被归入不同 locality,就具备后续地域负载均衡的基础。
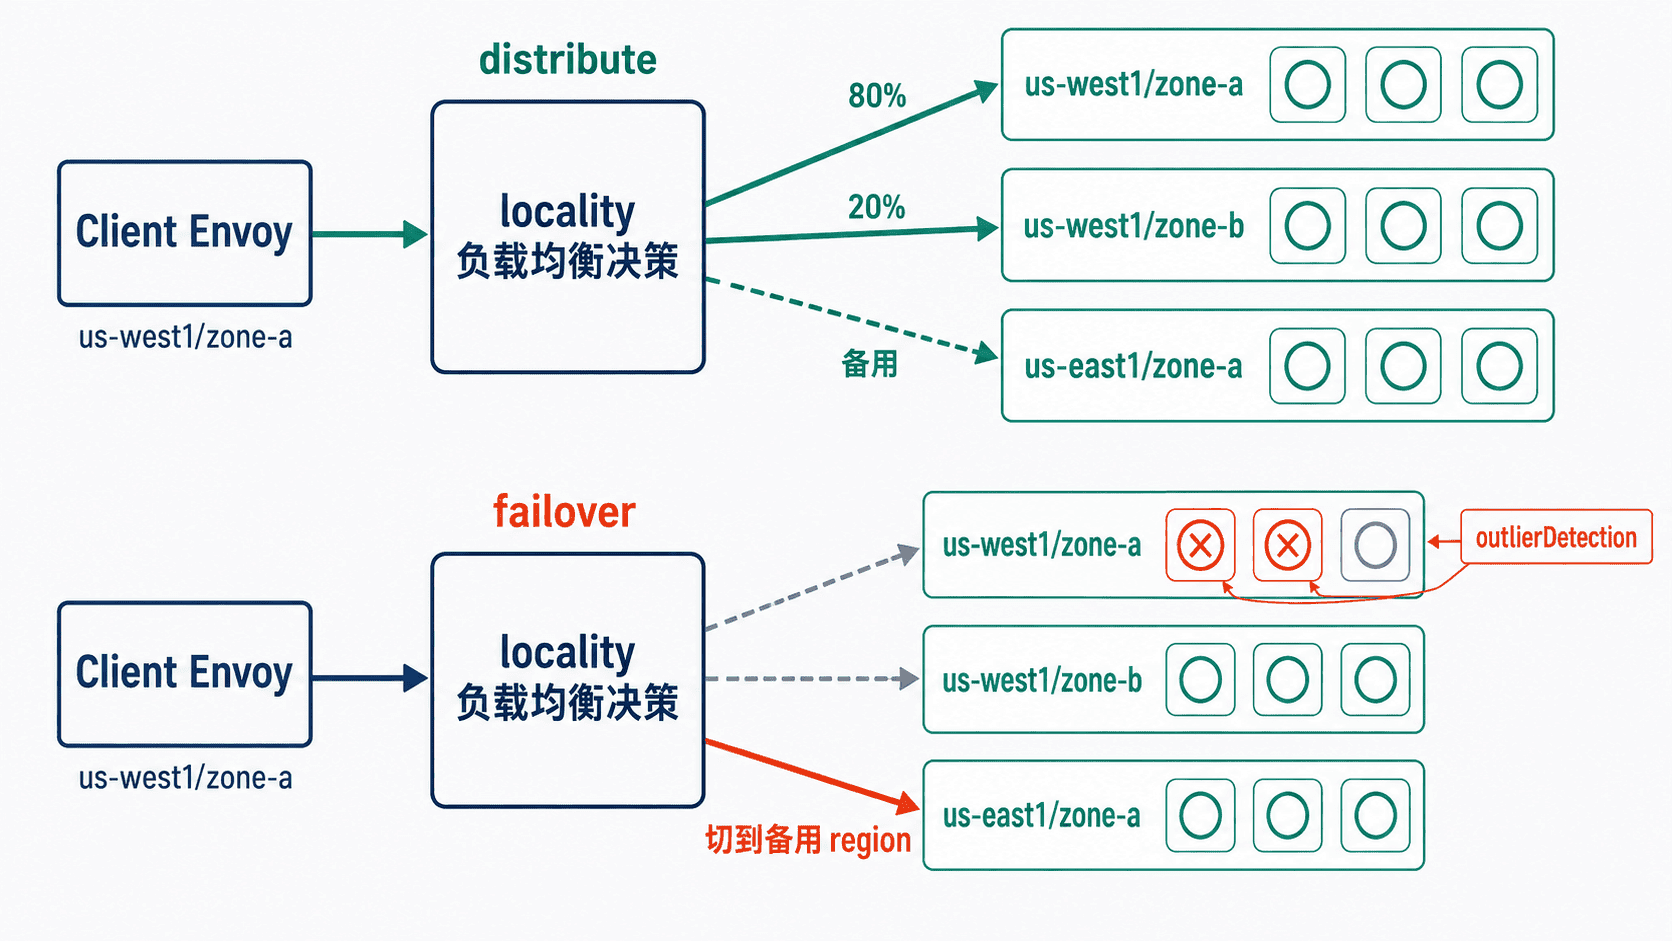
选择 distribute 与 failover
distribute 表达的是期望比例:根据调用方 locality 匹配 from,再按权重把流量分配到多个 to locality,适合主动维持固定跨地域比例,例如本地域 80%、异地 20%。
failover 表达的是故障优先级:正常时优先使用当前 region 的健康端点,本地域健康端点不足或不可用时,再转向指定备用 region。与 failover 配合时应配置 outlierDetection,让异常上游能够被从健康候选集中驱逐。
配置跨地域 failover
下面假设 catalog.default.svc.cluster.local 同时部署在 us-west1 与 us-east1,调用方位于 us-west1。策略优先使用西部健康端点;连续返回 5xx 的实例可被临时驱逐,当西部没有足够的健康候选时转向 us-east1。
apiVersion: networking.istio.io/v1
kind: DestinationRule
metadata:
  name: catalog-locality
  namespace: default
spec:
  host: catalog.default.svc.cluster.local
  trafficPolicy:
    outlierDetection:
      consecutive5xxErrors: 5
      interval: 5s
      baseEjectionTime: 30s
      maxEjectionPercent: 100
    loadBalancer:
      localityLbSetting:
        enabled: true
        failover:
          - from: us-west1
            to: us-east1
将配置保存为 locality-failover.yaml 后应用:
kubectl apply -f locality-failover.yaml预期输出:
destinationrule.networking.istio.io/catalog-locality configured首次创建时末尾可能是 created。这里的目标是确认 DestinationRule 已成功写入;后续还要用真实请求证明数据面的地域选择符合预期。
验证正常、部分故障、跨地域与恢复
为了让结果可观测,假设 catalog-west 与 catalog-east 两个 Deployment 都被同一个 catalog Service 选中,并通过调度约束分别落在 us-west1 与 us-east1;catalog-west 初始 2 个副本,catalog-east 至少 1 个副本;后端 /region 返回 us-west1 或 us-east1。业务 Pod 上的 region 标签只用于本实验定位 Pod,不参与 Istio locality 判定。
下面的主脚本依次验证四个状态:正常时 20 次请求都在西部;西部缩到 1 个副本后仍优先留在西部;西部缩到 0 后切到东部;恢复 2 个西部副本后再次回到西部。脚本在关键状态前等待 Pod 与代理端点收敛,避免把传播延迟误判为策略失败。
set -euo pipefail

request_stats() {
  kubectl exec deployment/caller -c caller -- sh -c 'for i in $(seq 1 20); do curl -fsS http://catalog.default.svc.cluster.local/region; echo; done' | sort | uniq -c
}

wait_for_region() {
  expected=$1
  for _ in $(seq 1 30); do
    actual=$(kubectl exec deployment/caller -c caller -- curl -fsS http://catalog.default.svc.cluster.local/region 2>/dev/null || true)
    [ "$actual" = "$expected" ] && return 0
    sleep 2
  done
  echo "region did not converge to $expected" >&2
  return 1
}

echo "BASELINE"
wait_for_region us-west1
request_stats

kubectl scale deployment/catalog-west --replicas=1
kubectl rollout status deployment/catalog-west --timeout=120s
echo "PARTIAL"
wait_for_region us-west1
request_stats

kubectl scale deployment/catalog-west --replicas=0
for _ in $(seq 1 30); do
  [ -z "$(kubectl get pod -l app=catalog,region=us-west1 -o name)" ] && break
  sleep 2
done
test -z "$(kubectl get pod -l app=catalog,region=us-west1 -o name)"
echo "FAILOVER"
wait_for_region us-east1
request_stats

kubectl scale deployment/catalog-west --replicas=2
kubectl rollout status deployment/catalog-west --timeout=120s
echo "RECOVERY"
wait_for_region us-west1
request_stats
预期输出:
BASELINE
     20 us-west1
deployment.apps/catalog-west scaled
deployment "catalog-west" successfully rolled out
PARTIAL
     20 us-west1
deployment.apps/catalog-west scaled
FAILOVER
     20 us-east1
deployment.apps/catalog-west scaled
deployment "catalog-west" successfully rolled out
RECOVERY
20 us-west1<ID>、<IP>、<NODE-WEST> 等占位符和实际等待时间会因环境不同而变化。稳定状态下应满足:本地域有健康端点时优先留在 us-west1,只减少部分本地端点不会直接跨 region,本地端点全部消失后转到 us-east1,恢复并完成配置收敛后重新回到 us-west1。
验收时重点看三个边界
先确认 locality 元数据,再确认 DestinationRule 已应用,最后才看请求结果。地域标签缺失、Service 没有同时选中两地端点、调用方未经过 Istio 数据面,都会让 failover 验证失真。
上面的缩容实验验证的是“端点从服务发现中消失”这一类故障,并未证明 outlierDetection 对连续 5xx 的驱逐行为。若还要验证异常驱逐,应让真实上游实例返回连续 5xx,再观察其被代理临时排除;不要用 VirtualService 直接生成的故障响应代替真实上游失败,否则无法证明 5xx 来自被监控的端点。
地域感知流量的目标不是把请求永远固定到某个机房,而是让 Envoy 在距离与健康状态之间形成可预测的优先关系。上线前完成一次“正常 → 部分端点减少 → 本地域清空 → 跨地域切换 → 恢复”的闭环,才能证明 locality 策略符合实际容灾目标。