
容器与云原生 / 系统课时
使用异常点驱逐
使用异常点驱逐
异常点驱逐会把持续失败的上游实例暂时移出当前代理的负载均衡池,避免请求反复命中故障端点。本节配置 DestinationRule,构造稳定返回 500 的 orders 实例,并持续发请求验证驱逐与恢复全过程。
学习目标
- 配置基于连续 5xx 的异常点驱逐规则
- 解释驱逐阈值、分析周期、驱逐时长和比例上限的作用
- 构造可重复的 500 故障,并用
istioctl proxy-config endpoints验证驱逐与恢复
异常点驱逐解决什么问题
Kubernetes 就绪探针解决的是“这个 Pod 是否应该进入 Service 端点集合”,异常点驱逐解决的是“某个代理观察到上游端点持续失败时,是否还应该继续向它分配新请求”。两者可以同时存在,判断依据和作用位置不同。
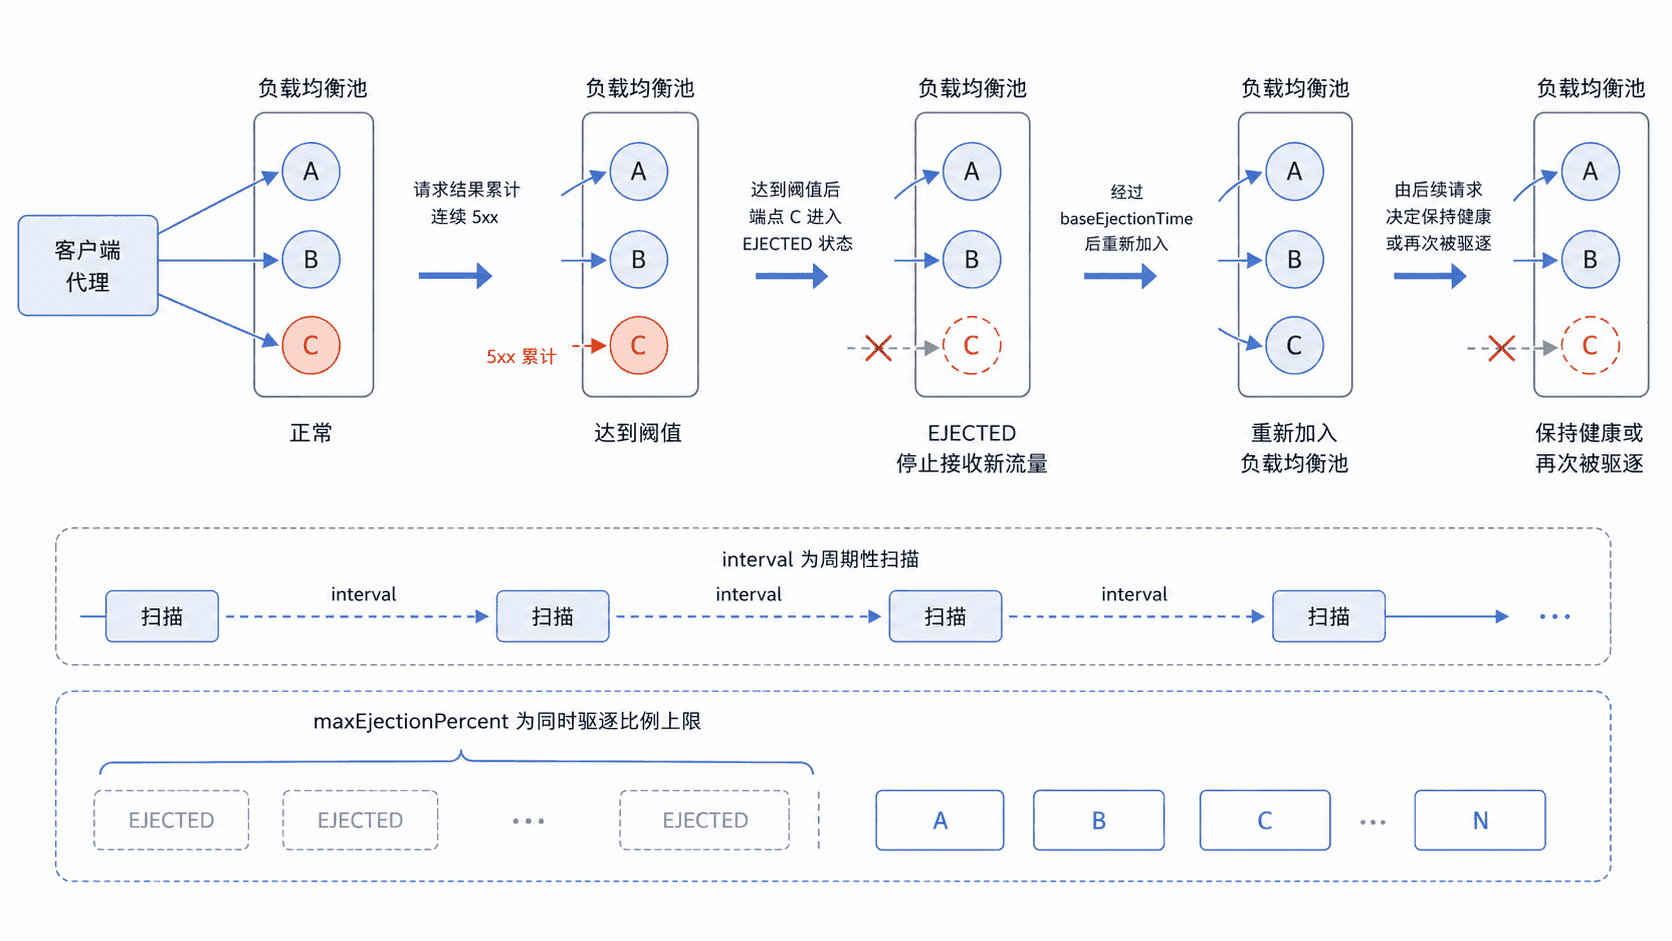
Outlier Detection 属于被动健康判断:数据面代理根据真实请求结果为各端点累计异常。达到条件后,端点会在一段时间内退出该代理的负载均衡选择;驱逐时间结束后重新参与流量,再由后续请求继续检验。它不会修改 Pod,也不会把端点从 Kubernetes Service 中删除。
配置并制造可复现故障
下面假设命名空间为 mesh-demo,orders Service 的 HTTP 服务端口和数值型 targetPort 都是 8080,且 Service 至少已有一个正常实例。实验创建一个复制该 Service 选择器、始终返回 500 的临时 Pod,因此它会成为真实的 orders 端点;同时临时使用 ROUND_ROBIN、关闭 HTTP/2 升级,并把每条上游连接限制为一个请求,使重复请求更稳定地轮询到故障端点。
set -euo pipefail

NS=mesh-demo
SERVICE=orders
HOST=orders.mesh-demo.svc.cluster.local
DR=orders-outlier-lab

cleanup() {
  kubectl delete pod orders-outlier-client orders-outlier-fault \
    -n "$NS" --ignore-not-found --wait=false >/dev/null 2>&1 || true
  kubectl delete destinationrule "$DR" \
    -n "$NS" --ignore-not-found >/dev/null 2>&1 || true
}
trap cleanup EXIT

SELECTOR="$(kubectl get svc "$SERVICE" -n "$NS" \
  -o go-template='{{range $k,$v := .spec.selector}}{{$k}}={{$v}},{{end}}')"
SELECTOR="${SELECTOR%,}"
test -n "$SELECTOR"

kubectl apply -n "$NS" -f - <<'EOF'
apiVersion: networking.istio.io/v1
kind: DestinationRule
metadata:
  name: orders-outlier-lab
spec:
  host: orders.mesh-demo.svc.cluster.local
  trafficPolicy:
    connectionPool:
      http:
        h2UpgradePolicy: DO_NOT_UPGRADE
        maxRequestsPerConnection: 1
    loadBalancer:
      simple: ROUND_ROBIN
    outlierDetection:
      consecutive5xxErrors: 3
      interval: 5s
      baseEjectionTime: 30s
      maxEjectionPercent: 50
EOF

kubectl delete pod orders-outlier-client orders-outlier-fault \
  -n "$NS" --ignore-not-found --wait=true

kubectl run orders-outlier-client -n "$NS" \
  --image=curlimages/curl:8.10.1 \
  --restart=Never \
  --annotations='sidecar.istio.io/inject=true' \
  --command -- sleep 3600

kubectl run orders-outlier-fault -n "$NS" \
  --image=python:3.12-alpine \
  --restart=Never \
  --labels="$SELECTOR" \
  --annotations='sidecar.istio.io/inject=true' \
  --port=8080 \
  --command -- python -u -c 'from http.server import BaseHTTPRequestHandler, HTTPServer
class H(BaseHTTPRequestHandler):
    def do_GET(self):
        self.send_response(500)
        self.end_headers()
        self.wfile.write(b"fault\n")
    def log_message(self, fmt, *args):
        print(fmt % args, flush=True)
HTTPServer(("0.0.0.0", 8080), H).serve_forever()'

kubectl wait -n "$NS" --for=condition=Ready \
  pod/orders-outlier-client pod/orders-outlier-fault --timeout=90s

FAULT_IP="$(kubectl get pod orders-outlier-fault -n "$NS" \
  -o jsonpath='{.status.podIP}')"

until kubectl get endpointslice -n "$NS" \
  -l kubernetes.io/service-name="$SERVICE" \
  -o jsonpath='{range .items[*].endpoints[*]}{.addresses[0]}{"\n"}{end}' \
  | grep -Fxq "$FAULT_IP"; do
  sleep 1
done

ENDPOINT_COUNT="$(kubectl get endpointslice -n "$NS" \
  -l kubernetes.io/service-name="$SERVICE" \
  -o jsonpath='{range .items[*].endpoints[*]}{.addresses[0]}{"\n"}{end}' \
  | sed '/^$/d' | wc -l | tr -d ' ')"
REQUESTS=$((ENDPOINT_COUNT * 4))

kubectl exec -n "$NS" orders-outlier-client -c orders-outlier-client -- \
  sh -c "i=0; while [ \$i -lt $REQUESTS ]; do curl -sS --max-time 2 -o /dev/null http://orders:8080/ || true; i=\$((i+1)); done"

sleep 6
printf 'fault hits='
kubectl logs -n "$NS" orders-outlier-fault -c orders-outlier-fault \
  | grep -c '"GET / HTTP/1.1" 500' || true

printf '%s\n' '=== ejected ==='
EJECTED="$(istioctl proxy-config endpoints orders-outlier-client -n "$NS" \
  --cluster "outbound|8080||$HOST")"
printf '%s\n' "$EJECTED" | grep -E "ENDPOINT|$FAULT_IP"
printf '%s\n' "$EJECTED" | grep -F "$FAULT_IP:8080" | grep -q 'FAILED'

sleep 36
printf '%s\n' '=== recovered ==='
RECOVERED="$(istioctl proxy-config endpoints orders-outlier-client -n "$NS" \
  --cluster "outbound|8080||$HOST")"
printf '%s\n' "$RECOVERED" | grep -E "ENDPOINT|$FAULT_IP"
printf '%s\n' "$RECOVERED" | grep -F "$FAULT_IP:8080" | grep -q 'OK'
预期输出
destinationrule.networking.istio.io/orders-outlier-lab created
pod/orders-outlier-client created
pod/orders-outlier-fault created
pod/orders-outlier-client condition met
pod/orders-outlier-fault condition met
fault hits=<VALUE>
=== ejected ===
ENDPOINT        STATUS    OUTLIER CHECK    CLUSTER
<IP>:8080       HEALTHY   FAILED           outbound|8080||orders.mesh-demo.svc.cluster.local
=== recovered ===
ENDPOINT        STATUS    OUTLIER CHECK    CLUSTER
<IP>:8080       HEALTHY   OK               outbound|8080||orders.mesh-demo.svc.cluster.local
fault hits 应至少为 3;实际命中次数、IP、列间距和端点数量会不同。如果同名实验规则已经存在,第一行也可能显示 configured 或 unchanged。脚本先确认故障 Pod 已进入 orders 的 EndpointSlice,再按端点数量发送足够多的请求;最后两条 grep -q 还会把“未观察到 FAILED”或“等待后未恢复为 OK”直接变成脚本失败,而不是只打印一份看似正常的表格。退出时会删除两个临时 Pod 和本实验的 DestinationRule。
驱逐与恢复如何发生
代理按端点维护异常统计。这里故障端点连续产生 3 次计入统计的 5xx 后即可触发连续错误检测;interval: 5s 是异常点分析的周期参数,不应理解成“必须等满 5 秒才会开始累计这 3 次错误”。实验在请求后额外等待 6 秒,是为了给状态更新和观察留出余量。
maxEjectionPercent: 50 限制同一负载均衡池中可同时被驱逐的端点比例,避免异常判断把全部容量一次摘空。baseEjectionTime: 30s 是基础驱逐时长;端点到期后会重新进入负载均衡选择。如果它继续返回 500,后续请求会再次累计错误并触发新的驱逐,重复驱逐的实际时长还可能增长。
读懂代理端点状态
验证时最关键的是故障 Pod 对应行的 OUTLIER CHECK。显示 FAILED 表示当前调用方代理已因异常点检测驱逐该端点;同一行的 STATUS 仍可能是 HEALTHY,因为 Kubernetes 端点健康状态与 Istio 的被动驱逐状态不是同一层判断。
等待基础驱逐时长后,同一代理通常会把该端点显示为 OK,表示它重新具备接受流量的资格,而不是被永久判定健康。若再次运行请求循环,由于临时端点仍固定返回 500,它会再次跨过阈值并进入下一轮驱逐,这才构成“持续失败—驱逐—恢复资格—再次评估”的闭环。