
容器与云原生 / 系统课时
设计灰度回滚与故障切换
设计灰度回滚与故障切换
灰度发布真正危险的不是“把 10% 流量给新版本”,而是异常出现后没有确定动作。本课把跨版本回滚与运行时故障切换分成两层,并用实际请求、异常驱逐统计和 locality 故障演练补齐完整证据链。
学习目标
- 区分跨版本灰度回滚与同一路由目标内的健康故障切换
- 把错误率、延迟等监控信号转换为明确的回滚门禁
- 验证回滚后 v2 流量归零、异常端点被驱逐以及 region 级 failover 生效
分清两层恢复动作
灰度回滚解决“候选版本整体不可信”,动作是修改 VirtualService 权重,让新请求重新由稳定版本处理。运行时故障切换解决“某些实例或某个 locality 不可用”,由 DestinationRule 的异常驱逐和 locality 负载均衡在数据面选择仍健康的端点。
| 场景 | 触发信号 | 主要机制 | 结果 |
|---|---|---|---|
| 候选版本质量下降 | v2 错误率、延迟或业务指标越过门禁 | VirtualService 权重回退 |
v2 10% → 0%,v1 90% → 100% |
| 个别实例失效 | 连续 5xx、连接失败等 | outlierDetection |
临时驱逐异常端点 |
| region/locality 故障 | 本地域没有可用端点 | localityLbSetting.failover + 健康状态 |
转向指定备用 region |
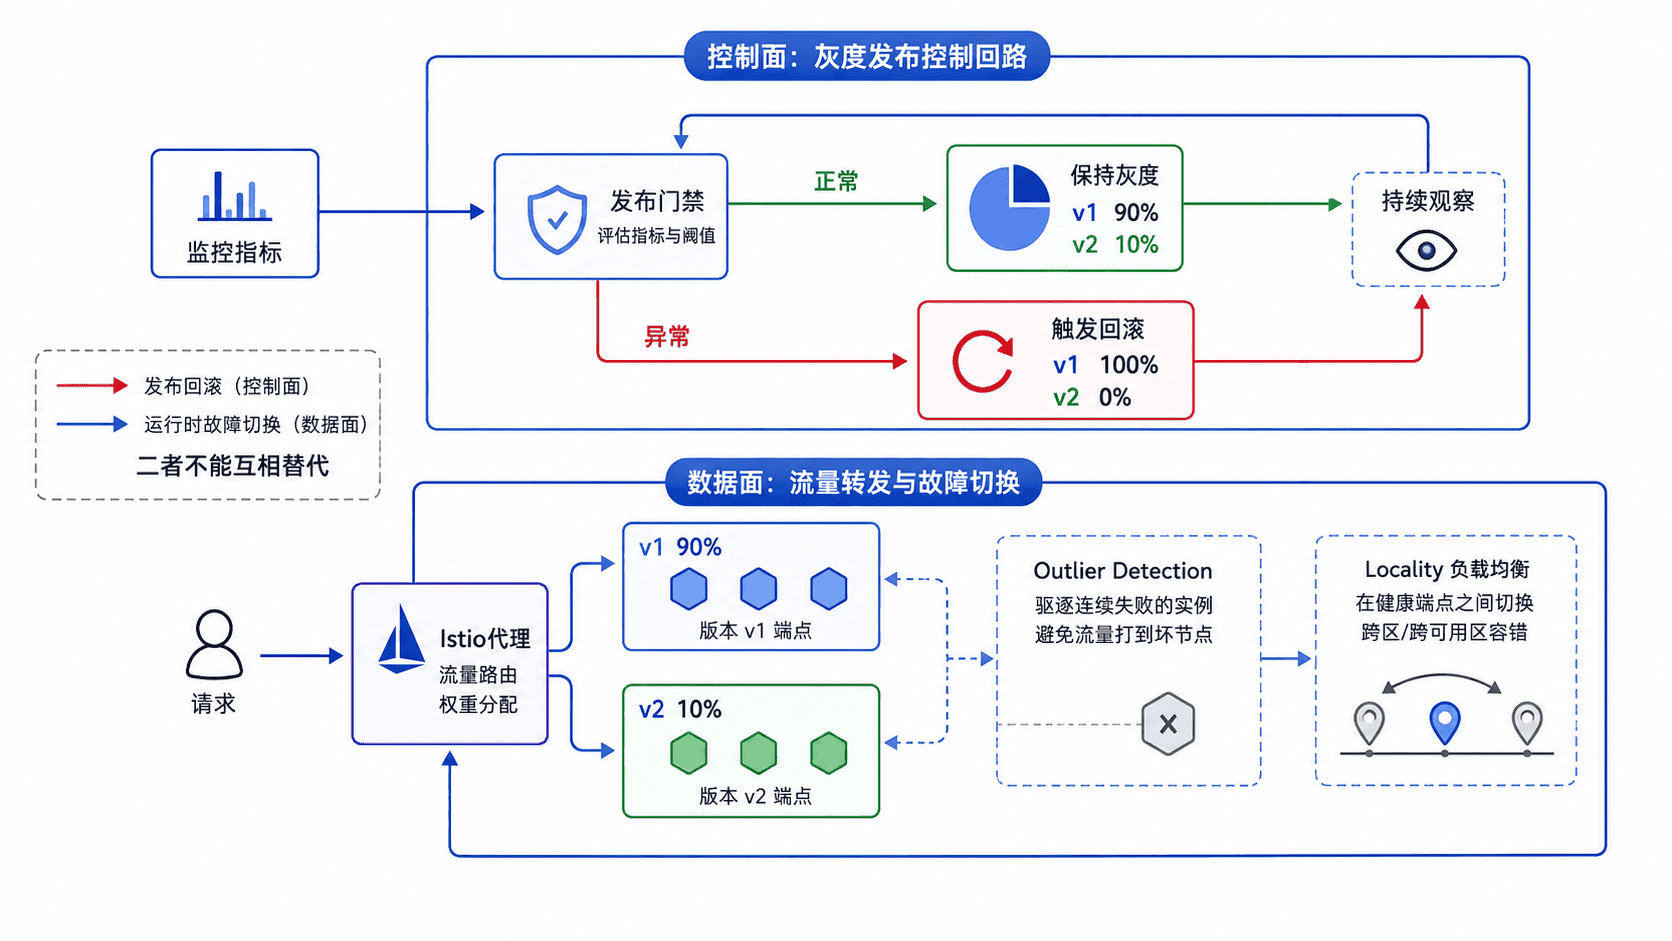
把监控信号写成回滚门禁
门禁要同时定义指标、阈值、持续时间和比较基线,否则“异常就回滚”无法自动执行。演练环境可以规定:v2 的 5xx 连续 5 分钟高于 2%,或 P95 延迟连续 5 分钟超过 v1 的 1.3 倍,就触发回滚。
这些数值只是示例。生产阈值应从服务 SLO、正常波动和容量余量推导,并为低流量服务设置最小样本量。触发前还要确认 v1 有足够副本和下游容量,避免回滚把发布故障放大成稳定版本过载。
配置恢复策略
下面以 region-a 和 region-b 为例。Istio 使用代理与端点所在节点的 topology.kubernetes.io/region 等拓扑信息判断 locality;failover.from 和 failover.to 必须与实际 region 名称一致。要让健康状态参与 locality failover,本例同时启用 outlierDetection。
演练假定 orders 已有 v1、v2 subset,稳定版本 v1 在两个 region 都有副本;client 位于 region-a 且使用 Sidecar 数据面。示例服务的 /version 返回 v1 或 v2,/region 返回实例所在 region;orders Service 选择 app=orders,目标端口为 8080。若实验环境命名不同,应替换名称和端口,不要直接照抄。
set -euo pipefail

cleanup() {
  kubectl delete pod orders-v1-bad --ignore-not-found --wait=false >/dev/null 2>&1 || true
  kubectl scale deployment orders-v1-region-a --replicas=2 >/dev/null 2>&1 || true
}
trap cleanup EXIT

kubectl apply -f - <<'EOF' >/dev/null
apiVersion: networking.istio.io/v1
kind: DestinationRule
metadata:
  name: orders
spec:
  host: orders
  subsets:
  - name: v1
    labels:
      version: v1
  - name: v2
    labels:
      version: v2
  trafficPolicy:
    loadBalancer:
      localityLbSetting:
        enabled: true
        failover:
        - from: region-a
          to: region-b
        - from: region-b
          to: region-a
    outlierDetection:
      consecutive5xxErrors: 5
      interval: 5s
      baseEjectionTime: 30s
      maxEjectionPercent: 50
---
apiVersion: networking.istio.io/v1
kind: VirtualService
metadata:
  name: orders
spec:
  hosts:
  - orders
  http:
  - route:
    - destination:
        host: orders
        subset: v1
      weight: 90
    - destination:
        host: orders
        subset: v2
      weight: 10
EOF

kubectl get virtualservice orders -o jsonpath='{range .spec.http[0].route[*]}{.destination.subset}={.weight}{" "}{end}{"\n"}'

# 门禁触发后只改权重,再用真实请求验收,而不是只读回配置。
kubectl patch virtualservice orders --type=json -p='[{"op":"replace","path":"/spec/http/0/route/0/weight","value":100},{"op":"replace","path":"/spec/http/0/route/1/weight","value":0}]' >/dev/null
kubectl get virtualservice orders -o jsonpath='{range .spec.http[0].route[*]}{.destination.subset}={.weight}{" "}{end}{"\n"}'
kubectl exec deploy/client -c client -- sh -c 'i=0; while [ "$i" -lt 100 ]; do curl -fsS http://orders/version; echo; i=$((i+1)); done' | sort | uniq -c

# 加入一个始终返回 500 的 v1 端点,专门验证单实例异常驱逐。
kubectl apply -f - <<'EOF' >/dev/null
apiVersion: v1
kind: Pod
metadata:
  name: orders-v1-bad
  labels:
    app: orders
    version: v1
spec:
  nodeSelector:
    topology.kubernetes.io/region: region-a
  containers:
  - name: bad
    image: python:3.12-alpine
    command: ["python", "-c"]
    args:
    - |
      from http.server import BaseHTTPRequestHandler, HTTPServer
      class Handler(BaseHTTPRequestHandler):
          def do_GET(self):
              self.send_response(500)
              self.end_headers()
              self.wfile.write(b"bad\n")
          def log_message(self, *_):
              pass
      HTTPServer(("0.0.0.0", 8080), Handler).serve_forever()
    ports:
    - containerPort: 8080
EOF
kubectl wait --for=condition=Ready pod/orders-v1-bad --timeout=60s >/dev/null
sleep 5

kubectl exec deploy/client -c client -- sh -c 'i=0; while [ "$i" -lt 60 ]; do curl -s -o /dev/null -w "%{http_code}\n" http://orders/region; i=$((i+1)); done' | sort | uniq -c
kubectl exec deploy/client -c client -- sh -c "curl -fsS 'http://127.0.0.1:15000/stats?filter=outlier_detection.ejections_active' | grep 'outbound|80|v1|orders'"
kubectl exec deploy/client -c client -- sh -c 'i=0; while [ "$i" -lt 20 ]; do curl -s -o /dev/null -w "%{http_code}\n" http://orders/region; i=$((i+1)); done' | sort | uniq -c

# 删除故障端点,再让 region-a 的稳定版本端点整体消失,验证 locality failover。
kubectl delete pod orders-v1-bad --wait=true >/dev/null
kubectl scale deployment orders-v1-region-a --replicas=0 >/dev/null
sleep 5
kubectl exec deploy/client -c client -- sh -c 'i=0; while [ "$i" -lt 5 ]; do curl -fsS http://orders/region; echo; i=$((i+1)); done'

kubectl scale deployment orders-v1-region-a --replicas=2 >/dev/null
trap - EXIT
预期输出
v1=90 v2=10
v1=100 v2=0
    100 v1
<VALUE> 200
<VALUE> 500
cluster.outbound|80|v1|orders.default.svc.cluster.local.outlier_detection.ejections_active: 1
     20 200
region-b
region-b
region-b
region-b
region-b
首轮 HTTP 状态码中的两个 <VALUE> 会随端点数和负载均衡时序变化,但在 baseEjectionTime 尚未结束时,应同时看到故障端点产生过 500、ejections_active 变为 1,随后 20 次请求全部为 200。若统计中始终没有 500,应先确认临时 Pod 已被 orders Service 选中且已进入代理的端点视图。
验收完整证据链
回滚验收不能停在 VirtualService 显示 100/0:100 次 /version 请求全部返回 v1,才证明新请求不再进入 v2。单实例故障则要同时看到“先出现 500 → ejections_active: 1 → 后续请求恢复 200”,这样才能把异常驱逐与版本回滚区分开。
最后再制造 locality 级故障:删除临时故障 Pod、把 region-a 的 v1 副本缩到 0 后,来自 region-a 的请求应连续返回 region-b。已有长连接、WebSocket 或长时间 gRPC 流通常不会因为新权重或 locality 选择立即迁移,因此生产回滚还应配合连接排空,并记录触发指标、配置版本、执行时间和恢复结果。