
容器与云原生 / 系统课时
关联访问日志与分布式追踪
关联访问日志与分布式追踪
单条 5xx 日志只能说明某个代理看到了失败,不能直接证明故障发生在哪一跳。本课用 x-request-id 串联多跳 Envoy 访问日志,并把 traceparent 显式写入访问日志,再从日志中提取 Trace ID 进入追踪后端,实现“日志 → Trace → 异常 Span”的可复现定位链路。
学习目标
- 区分请求 ID、Trace ID 与 Span ID 的职责。
- 配置 Envoy 访问日志显式记录
traceparent,并验证关联头跨服务传播。 - 从访问日志提取 Trace ID,结合分布式追踪定位真正的异常节点。
建立可贯穿链路的关联键
x-request-id 适合做日志检索键;Trace ID 标识整条分布式调用;Span ID 只标识其中一段操作。使用 W3C Trace Context 时,traceparent 的 Trace ID 在链路中保持不变,而不同跳的 Span ID 可以变化。
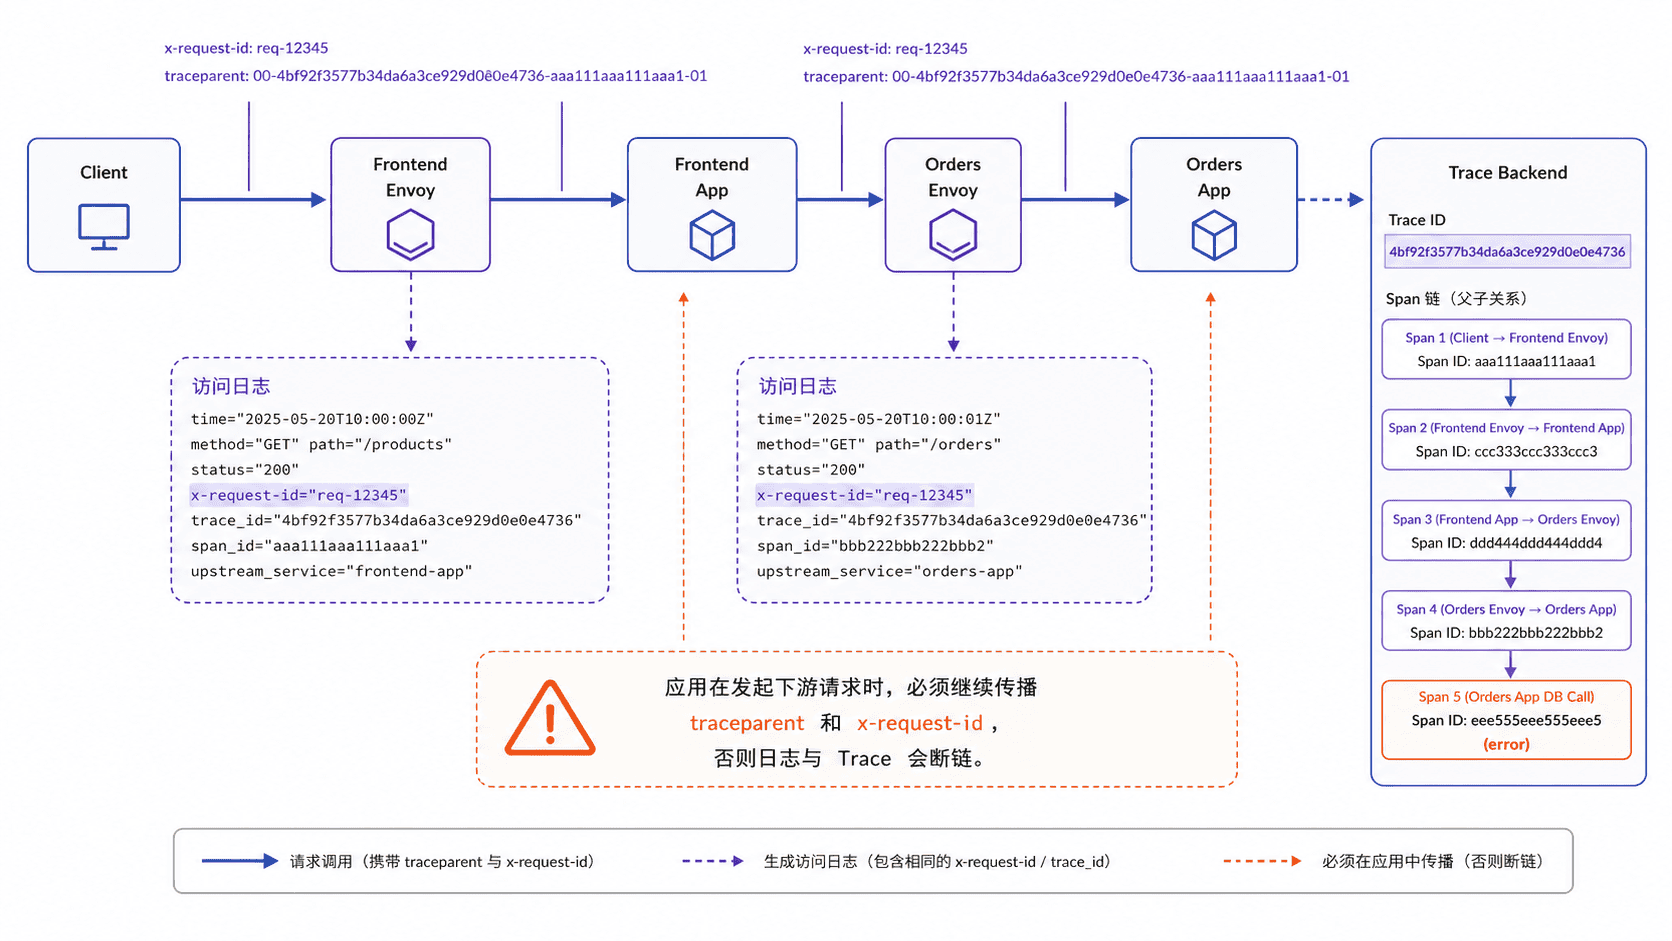
业务进程发起新的 HTTP/gRPC 请求时,仍要把收到的追踪上下文继续传给下游。若应用丢弃 traceparent,下游可能形成新的 Trace;若丢弃 x-request-id,就不能再用同一个日志键贯穿多跳代理。
Istio 默认 Envoy 文本访问日志通常包含 X-REQUEST-ID,但不会自动把 traceparent 或 Trace ID 写入日志。因此,仅启用默认 envoy access log provider 不能完成“从日志取得 Trace ID 再跳到追踪系统”;必须显式扩展访问日志格式。
让访问日志记录追踪上下文
下面是一个配置片段示例:在现有 Istio 安装配置的 meshConfig.extensionProviders 中定义文件访问日志 provider,并把 request_id、traceparent、状态码和上游地址写成结构化字段。该片段需要合并到当前安装配置后按既有升级方式生效,避免用一份不完整的安装清单覆盖现有网格参数。
meshConfig:
  extensionProviders:
  - name: envoy-trace-log
    envoyFileAccessLog:
      path: /dev/stdout
      logFormat:
        labels:
          request_id: "%REQ(X-REQUEST-ID)%"
          traceparent: "%REQ(TRACEPARENT)%"
          response_code: "%RESPONSE_CODE%"
          upstream_host: "%UPSTREAM_HOST%"
配置生效行为:名为 envoy-trace-log 的 provider 会把上述字段写到 Envoy 标准输出。若当前安装已经定义同名 provider,应修改原定义而不是重复声明;配置更新后再用下面的主示例选择该 provider 并验证实际日志。
从同一请求的日志提取 Trace ID
下面应用命名空间级 Telemetry,发送一条带固定请求 ID 和合法 W3C traceparent 的请求,再从 Envoy 日志中提取 traceparent。示例中的 Trace ID 固定只是为了便于核对,后续 TRACE_ID_FROM_LOG 只从日志内容计算,不直接复用请求侧变量。
kubectl apply -f - <<'EOF'
apiVersion: telemetry.istio.io/v1
kind: Telemetry
metadata:
  name: namespace-access-log
  namespace: default
spec:
  accessLogging:
  - providers:
    - name: envoy-trace-log
EOF

REQ_ID="anystack-demo-001"
TRACE_ID_SENT="0123456789abcdef0123456789abcdef"
ROOT_SPAN_ID="0123456789abcdef"
HTTP_STATUS=$(curl -sS -o /dev/null -w '%{http_code}' -H "x-request-id: $REQ_ID" -H "traceparent: 00-$TRACE_ID_SENT-$ROOT_SPAN_ID-01" "<URL>")
echo "HTTP $HTTP_STATUS"

FRONTEND_LOG=$(kubectl -n default logs deploy/frontend -c istio-proxy --since=2m | grep "$REQ_ID" | tail -n 1)
ORDERS_LOG=$(kubectl -n default logs deploy/orders -c istio-proxy --since=2m | grep "$REQ_ID" | tail -n 1)
echo "$FRONTEND_LOG"
echo "$ORDERS_LOG"

TRACEPARENT_FROM_LOG=$(echo "$FRONTEND_LOG" | jq -r '.traceparent')
TRACE_ID_FROM_LOG=$(echo "$TRACEPARENT_FROM_LOG" | cut -d- -f2)
echo "trace_id_from_log=$TRACE_ID_FROM_LOG"
预期结果:
telemetry.telemetry.istio.io/namespace-access-log created
HTTP <HTTP_STATUS>
{"request_id":"anystack-demo-001","traceparent":"00-0123456789abcdef0123456789abcdef-<SPAN_ID>-01","response_code":"<HTTP_STATUS>","upstream_host":"<UPSTREAM_HOST>"}
{"request_id":"anystack-demo-001","traceparent":"00-0123456789abcdef0123456789abcdef-<SPAN_ID>-01","response_code":"<HTTP_STATUS>","upstream_host":"<UPSTREAM_HOST>"}
trace_id_from_log=0123456789abcdef0123456789abcdef
如果 Telemetry 已存在,第一行可能显示 configured。<URL>、<HTTP_STATUS>、<UPSTREAM_HOST>、时间、JSON 字段顺序和每一跳的 Span ID 以实际环境为准;两条日志的 Trace ID 应一致,Span ID 可以不同。若只有第一跳能关联成功,优先检查业务代码是否传播 x-request-id、traceparent 与 tracestate。
从日志证据进入 Trace
此时用于追踪检索的值来自 TRACE_ID_FROM_LOG,而不是事先记住的请求参数。将它复制到 Jaeger、Tempo、Zipkin 或其他兼容后端的 Trace ID 检索入口,才真正完成“从日志跳到 Trace”。
访问日志回答“哪一跳看到了什么状态码、耗时和上游目标”,Trace 回答“各 Span 的父子关系、持续时间和错误发生位置”。如果某个 Envoy 日志已经出现 503,且 Trace 中没有对应的下游业务 Span,问题更可能发生在路由、连接或上游可达性;如果代理返回正常,而业务 Span 内部报错,则继续检查应用逻辑与依赖。
最终应形成一条可复现证据链:请求 ID 能贯穿相关访问日志,日志中能够取得 Trace ID,Trace ID 又能命中对应 Span,异常时间点与具体服务一致。三项对齐后,才能避免把“最后返回错误的代理”误判成“真正产生故障的服务”。