
容器与云原生 / 系统课时
设置超时与重试
设置超时与重试
本课把请求总时间预算、单次尝试时限和重试条件放进同一套 Istio 路由策略,并补上可重复的 5xx 与延迟实验。完成后,你能确认重试确实发生,而不只是看到一次成功响应,同时理解怎样避免重试放大下游故障。
学习目标
- 理解总超时、单次尝试超时与重试次数之间的约束关系
- 使用
VirtualService配置timeout、retries.attempts、perTryTimeout与retryOn - 用可控 5xx、延迟和后端日志验证多次上游尝试
先把时间预算算清楚
timeout 是整条路由的总时间预算,perTryTimeout 限制每次上游尝试最多等待多久,attempts 表示允许的重试次数。配置 attempts: 2 时,最多可能出现首次请求加 2 次重试,但实际次数仍受总超时和剩余时间限制。
例如总超时为 3 秒、单次尝试最多 1 秒时,前一次尝试消耗的时间会从同一个 3 秒预算中扣除,后续重试不会重新获得一份 3 秒预算。perTryTimeout 也不应配置得比总超时更长,否则无法形成有意义的分层时间限制。
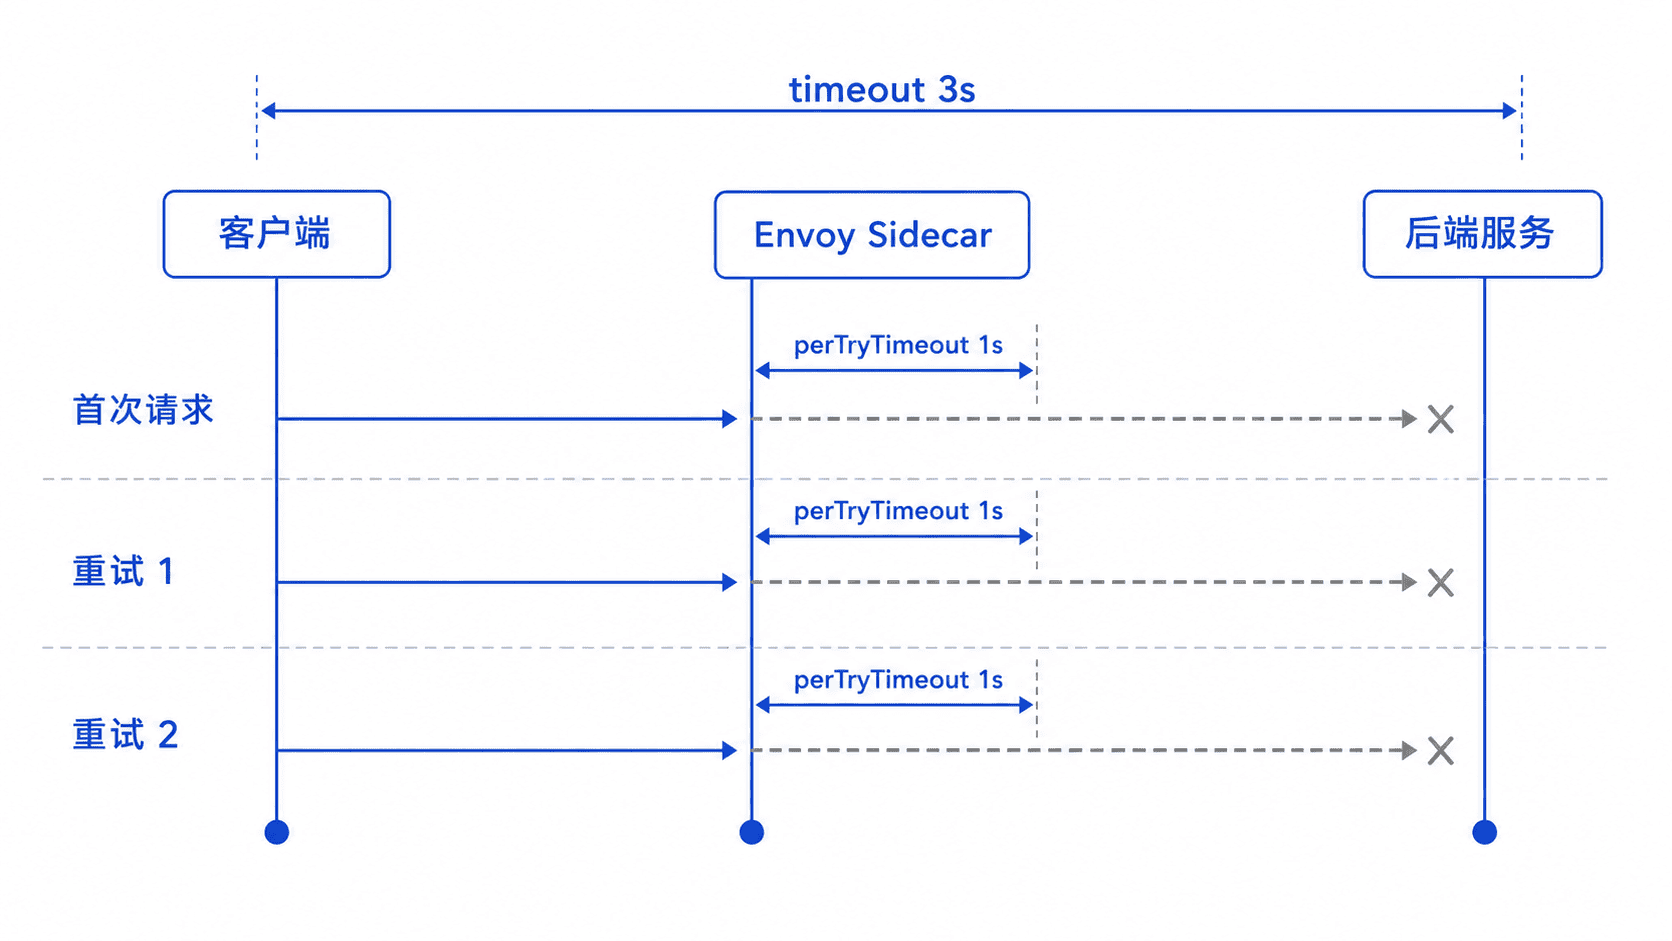
准备可控实验并配置路由
为了真正验证重试,先准备一个单副本测试后端:/flaky 前两次返回 503、第三次返回 200;/slow 每次等待 2 秒再返回 200。retry-client 显式请求 Sidecar 注入,保证出站请求经过 Envoy。
将下面内容保存为 retry-lab.yaml:
apiVersion: v1
kind: ConfigMap
metadata:
  name: backend-lab-code
  namespace: default
data:
  server.py: |
    from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
    from threading import Lock
    from time import sleep

    COUNTS = {}
    LOCK = Lock()

    def next_attempt(path):
        with LOCK:
            COUNTS[path] = COUNTS.get(path, 0) + 1
            return COUNTS[path]

    class Handler(BaseHTTPRequestHandler):
        def reply(self, status, body):
            self.send_response(status)
            self.send_header('Content-Type', 'text/plain')
            self.end_headers()
            try:
                self.wfile.write(body.encode())
            except BrokenPipeError:
                pass

        def do_GET(self):
            path = self.path.split('?', 1)[0]
            if path == '/reset':
                with LOCK:
                    COUNTS.clear()
                print('path=/reset status=200', flush=True)
                self.reply(200, 'reset\n')
                return

            attempt = next_attempt(path)
            if path == '/flaky':
                status = 503 if attempt <= 2 else 200
                print(f'attempt={attempt} path=/flaky status={status}', flush=True)
                self.reply(status, f'flaky attempt={attempt}\n')
                return

            if path == '/slow':
                print(f'attempt={attempt} path=/slow phase=start delay=2s', flush=True)
                sleep(2)
                self.reply(200, 'slow ok\n')
                return

            print(f'attempt={attempt} path={path} status=200', flush=True)
            self.reply(200, 'ok\n')

        def log_message(self, format, *args):
            pass

    ThreadingHTTPServer(('0.0.0.0', 8080), Handler).serve_forever()
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: backend
  namespace: default
spec:
  replicas: 1
  selector:
    matchLabels:
      app: backend
  template:
    metadata:
      labels:
        app: backend
    spec:
      containers:
        - name: backend
          image: python:3.12-alpine
          command: ["python", "/app/server.py"]
          ports:
            - containerPort: 8080
          volumeMounts:
            - name: code
              mountPath: /app
      volumes:
        - name: code
          configMap:
            name: backend-lab-code
---
apiVersion: v1
kind: Service
metadata:
  name: backend
  namespace: default
spec:
  selector:
    app: backend
  ports:
    - port: 80
      targetPort: 8080
---
apiVersion: v1
kind: Pod
metadata:
  name: retry-client
  namespace: default
  annotations:
    sidecar.istio.io/inject: "true"
spec:
  containers:
    - name: curl
      image: curlimages/curl:8.10.1
      command: ["sh", "-c", "sleep 3600"]
该配置只用于实验:单副本保证 /flaky 的计数不会落到不同 Pod。应用并等待后端和客户端就绪:
kubectl apply -f retry-lab.yaml
kubectl rollout status deployment/backend -n default --timeout=120s
kubectl wait -n default --for=condition=Ready pod/retry-client --timeout=120s
预期输出首次创建时包含:
configmap/backend-lab-code created
deployment.apps/backend created
service/backend created
pod/retry-client created
deployment "backend" successfully rolled out
pod/retry-client condition met
重复执行时前四行可能显示 configured 或 unchanged。再确认客户端确实有业务容器和 istio-proxy:
kubectl get pod retry-client -n default -o jsonpath='{.spec.containers[*].name}{"\n"}'预期输出:
curl istio-proxy如果没有 istio-proxy,先修复 Sidecar 注入,再继续验证。然后将下面的路由保存为 virtual-service.yaml:
apiVersion: networking.istio.io/v1
kind: VirtualService
metadata:
  name: backend-resilience
  namespace: default
spec:
  hosts:
    - backend.default.svc.cluster.local
  http:
    - route:
        - destination:
            host: backend.default.svc.cluster.local
      timeout: 3s
      retries:
        attempts: 2
        perTryTimeout: 1s
        retryOn: 5xx,reset,connect-failure,refused-stream
这里最多允许 2 次重试,单次尝试最多等待 1 秒,整个请求最多占用 3 秒;只有匹配 retryOn 的失败才进入下一次尝试。应用配置:
kubectl apply -f virtual-service.yaml预期输出:
virtualservice.networking.istio.io/backend-resilience created资源已存在时也可能显示 configured 或 unchanged。
验证 5xx 重试
先记录日志时间边界并重置测试后端计数,再从 Sidecar 客户端请求 /flaky。第一次和第二次上游尝试会收到 503,Envoy 依据 retryOn: 5xx 再试,第三次得到 200;最后只读取本轮实验产生的 /flaky 日志:
RUN_START=$(date -u +%Y-%m-%dT%H:%M:%SZ)
kubectl exec -n default retry-client -c curl --   curl -sS http://backend.default.svc.cluster.local/reset
kubectl exec -n default retry-client -c curl --   curl -sS -o /dev/null -w 'status=%{http_code}\n'   http://backend.default.svc.cluster.local/flaky
kubectl logs -n default deployment/backend -c backend   --since-time="$RUN_START" | grep 'path=/flaky'
预期输出:
reset
status=200
attempt=1 path=/flaky status=503
attempt=2 path=/flaky status=503
attempt=3 path=/flaky status=200
单个 200 只能证明最终请求成功;三条后端日志才说明 Envoy 实际执行了首次请求和两次重试,从而完成“策略命中并发生重试”的验证闭环。
验证单次尝试与总超时
/slow 每次等待 2 秒,而 perTryTimeout 只有 1 秒,因此每次尝试都会先超时;在最多两次重试和 3 秒总预算耗尽后,客户端应收到网格生成的超时响应。再次重置计数并限制日志到本轮实验:
RUN_START=$(date -u +%Y-%m-%dT%H:%M:%SZ)
kubectl exec -n default retry-client -c curl --   curl -sS http://backend.default.svc.cluster.local/reset
kubectl exec -n default retry-client -c curl --   curl -sS -o /dev/null -w 'status=%{http_code} total=%{time_total}\n'   http://backend.default.svc.cluster.local/slow
kubectl logs -n default deployment/backend -c backend   --since-time="$RUN_START" | grep 'path=/slow phase=start'
预期输出:
reset
status=504 total=<TIME>
attempt=1 path=/slow phase=start delay=2s
attempt=2 path=/slow phase=start delay=2s
attempt=3 path=/slow phase=start delay=2s
<TIME> 通常接近 3 秒,但会受调度、代理退避和网络开销影响。这组结果说明 perTryTimeout 触发了后续尝试,而 timeout 最终限制了整个请求的总持续时间。若状态码或次数不同,应先确认请求是否经过 retry-client 的 Sidecar,以及是否有其他 VirtualService 同时匹配同一主机。
避免把故障放大
重试会直接增加下游尝试次数。若大量请求同时失败,每个请求再追加两次重试,最坏情况下下游可能承受接近原始流量三倍的请求尝试,因此生产配置应同时收紧重试次数、总超时、单次尝试超时和 retryOn 条件。
当下游已经持续过载时,继续重试通常只会制造更多压力。此时应结合连接池、熔断、异常实例驱逐和容量保护限制失败扩散;超时与重试负责“什么时候放弃、是否再试”,不能替代下游的并发与负载保护。