
容器与云原生 / 系统课时
配置 Pod 出站允许规则
配置 Pod 出站允许规则
启用 Egress 隔离后,Pod 只能访问被允许的目标。本课用一个主策略放行应用 API,并在确认 CNI 的 Service 策略语义后放行集群 DNS,再用实际连接验证结果,避免把某种 CNI 的实现细节误当成标准 NetworkPolicy 的通用行为。
学习目标
- 能使用
egress、podSelector、namespaceSelector和端口条件描述最小出站允许范围 - 能先识别 DNS 与 Service 流量的策略实施语义,再选择可验证的放行方式
- 能通过解析与连接测试判断必要依赖是否已被策略覆盖
先确认出站依赖与策略语义
Pod 默认未被 Egress 策略隔离时,可以主动建立出站连接。一旦至少一个包含 Egress 的 NetworkPolicy 选中该 Pod,它就进入 Egress 隔离状态,只能建立被任一选中策略允许的连接;多条策略的允许范围取并集,不按声明顺序覆盖。
访问 api.default.svc.cluster.local 至少包含两段依赖:先向集群 DNS 发起查询,再连接 API。DNS 或 API 任意一段未被允许,应用都可能表现为解析失败或连接超时。
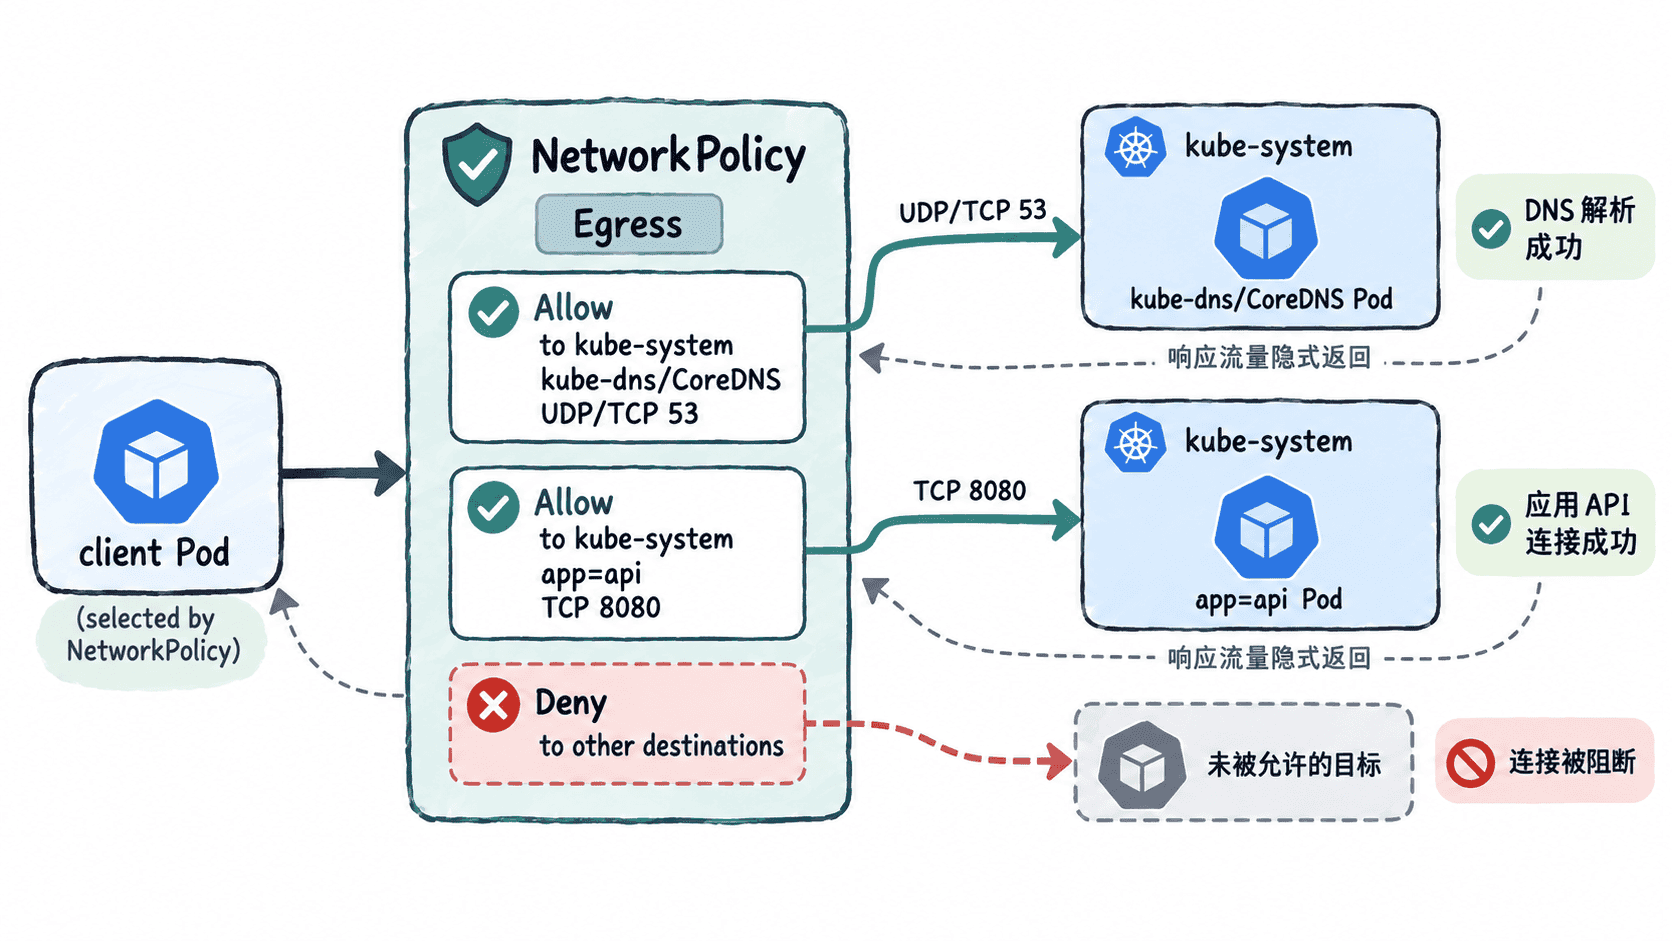
在写 DNS 规则前,先确认客户端、DNS Service 和 DNS Pod 的实际对象。不同发行版的 DNS Service 名称与 Pod 标签可能不同。
kubectl get pod -l app=client --show-labels
kubectl get svc -n kube-system
kubectl get pod -n kube-system --show-labels
预期结果:
可以找到至少一个带 app=client 的客户端 Pod,以及集群 DNS 对应的 Service 与后端 Pod。
Pod 名称、ClusterIP、READY、运行时间和标签会因环境不同而变化。
还要查看所用 CNI 的 NetworkPolicy 文档,确认访问 Service ClusterIP 时策略是在地址转换前还是后评估,以及是否提供 Service、DNS 或 FQDN 级扩展能力。标准 NetworkPolicy 本身没有“按 Service 名称”或“按域名”选择目标的字段。
配置最小允许规则
下面假设 default 命名空间中的客户端 Pod 带 app=client,API Pod 带 app=api,API 监听 TCP 8080;同时假设你已经确认当前 CNI 对 DNS Service 流量会按后端 Pod 身份执行标准 NetworkPolicy,因此可以用 namespaceSelector 与 podSelector 限定 DNS 后端。如果你的 CNI 不是这种语义,不要直接照搬第二条规则,应按其文档改用对应的 Service/DNS 扩展策略。
将以下内容保存为 allow-client-egress.yaml:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-client-egress
  namespace: default
spec:
  podSelector:
    matchLabels:
      app: client
  policyTypes:
    - Egress
  egress:
    # 允许访问同一命名空间中 app=api 的 Pod。
    - to:
        - podSelector:
            matchLabels:
              app: api
      ports:
        - protocol: TCP
          port: 8080
    # 仅在当前 CNI 已确认会按 DNS 后端 Pod 匹配 Service 流量时使用。
    - to:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: kube-system
          podSelector:
            matchLabels:
              k8s-app: kube-dns
      ports:
        - protocol: UDP
          port: 53
        - protocol: TCP
          port: 53
同一个 to 条目中的 namespaceSelector 与 podSelector 是同时满足的条件,因此这里选中的是 kube-system 中带 k8s-app=kube-dns 的 Pod,而不是任意命名空间中的同标签 Pod。若你的集群标签不同,应以实际标签替换示例值。
应用策略:
kubectl apply -f allow-client-egress.yaml预期输出:
networkpolicy.networking.k8s.io/allow-client-egress created重复执行时可能显示 configured 或 unchanged,这不改变策略语义。
验证 DNS 与 API 连接
先确认 NetworkPolicy 已创建并确实选中了客户端 Pod:
kubectl get networkpolicy allow-client-egress
kubectl get pod -l app=client --show-labels
预期结果:
可以看到 allow-client-egress NetworkPolicy,以及至少一个带 app=client 的客户端 Pod。
AGE、Pod 名称和其他动态字段会因环境不同而变化。
随后进入客户端 Pod 测试。下面假设镜像中提供 nslookup 和 wget,并存在名为 api、端口为 8080 的 Service:
CLIENT_POD=$(kubectl get pod -l app=client -o jsonpath='{.items[0].metadata.name}')
kubectl exec "$CLIENT_POD" -- nslookup api.default.svc.cluster.local
kubectl exec "$CLIENT_POD" -- wget -qO- --timeout=3 http://api:8080/health
预期结果:
Name:      api.default.svc.cluster.local
Address:   <IP>

ok
<IP> 以及 /health 的响应正文属于环境动态值,实际结果可能不同。DNS 失败时,先核对 DNS Service、后端 Pod 标签、53/UDP 与 53/TCP 是否被允许,以及当前 CNI 对 Service 流量的实施位置;不要为了恢复解析直接放开全部 Egress。DNS 成功而 API 超时时,再检查 API Pod 标签、应用端口、Service 后端和目标 Pod 的 Ingress 策略。Pod 到 Pod 通信需要同时满足源端 Egress 与目标端 Ingress 的允许条件。
放行外部服务时注意边界
访问数据库、第三方 API 或云服务时可以使用 ipBlock 描述 CIDR,但它只匹配网络层地址,不理解域名。Service 地址转换也可能影响实际匹配结果,因此凡是依赖 ClusterIP、负载均衡地址或经常变化的第三方 IP,都应按所用 CNI 的实现文档验证,而不是只看 YAML 推断。
实施 Egress 白名单时,先盘点 DNS、集群内服务、数据库、消息系统和外部 API 等真实依赖,再按当前网络实现逐项添加最小允许规则,并用真实解析与连接测试验收。这样既能避免开启隔离后业务整体中断,也不会因临时止损重新放开全部出站流量。